让高密算力快速落地投产:超擎数智iMDC液冷智算中心重塑算力基建范式
大模型迈向万亿参数,单柜功率突破百千瓦,传统风冷与土建周期双双触顶。超擎数智推出 iMDC 集装箱液冷智算中心,以“1+3+N”架构将计算、网络、存储、供配电与液冷在工厂完成约 90% 集成:单箱典型 13 柜 512 卡、单柜最高 120kW,两层组网支撑 8192 卡,PUE 控制在 1.2 以内,标准项目 8–12 周投产。
随着大模型参数规模向万亿级演进,以及多模态生成、智能体(Agentic AI)应用的规模化落地,全球算力需求正经历从“通用计算”向“高密智算”的结构性跨越。
然而,在算力规模狂飙的背后,智算中心的建设难度也随之增加。
一方面是功耗与散热的物理极限。 新一代GPU服务器的单机与单柜功耗呈指数级攀升,传统风冷数据中心单柜散热能力已触及天花板,高密算力如何高效散热、电力和制冷如何配套,网络与存储能否跟上集群规模,成为每个智算项目落地前必须跨越的工程门槛。
另一方面是“基建周期与业务窗口的错配”。 传统数据中心建设涉及土建、机电、暖通、弱电等多个专业交叉作业,现场施工和联调周期较长,往往难以匹配AI企业按周迭代的业务上线节奏,“算力等机房”成为制约AI商业化落地的普遍痛点。
面对高密化、敏捷化的宏观市场刚需,作为AI原生的基础设施产品和全栈方案提供商,超擎数智推出iMDC集装箱液冷智算中心解决方案。
该方案将智算中心从“现场土建工程”升级为标准化的“工业产品”。 以标准集装箱为载体,将计算、网络、存储、供配电、液冷和监控系统在工厂完成集成,运抵现场后进行安装对接和联合调试,即可为AI训练、推理及高性能计算提供高密算力基础设施。
一、架构解构:“1+3+N”全栈预制,万卡级扩展的高密算力底座
从整体架构看,iMDC可以概括为“1+3+N”。
“1”是液冷集装箱这个基础设施底座;“3”是计算、网络、存储三套核心系统;“N”是对不同算力形态的支持,包括OAM模组、PCIe等类型的AI服务器,以及不同生态的GPU产品。客户可以根据现有技术路线和后续扩容计划选择配置,不必被单一算力平台绑定。
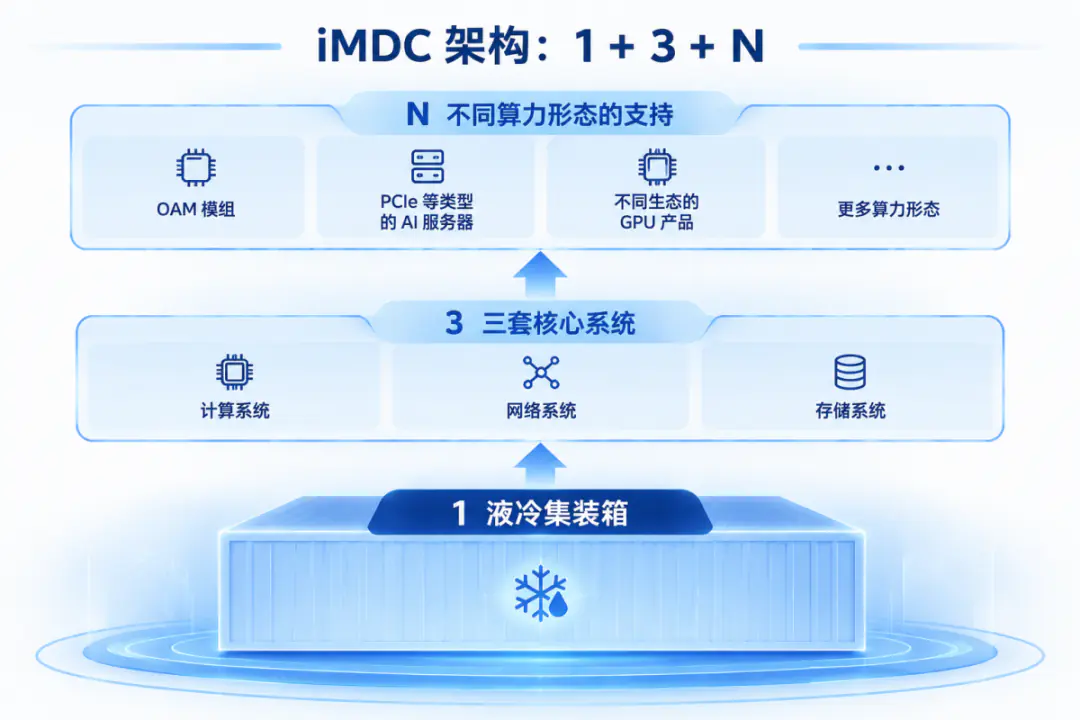
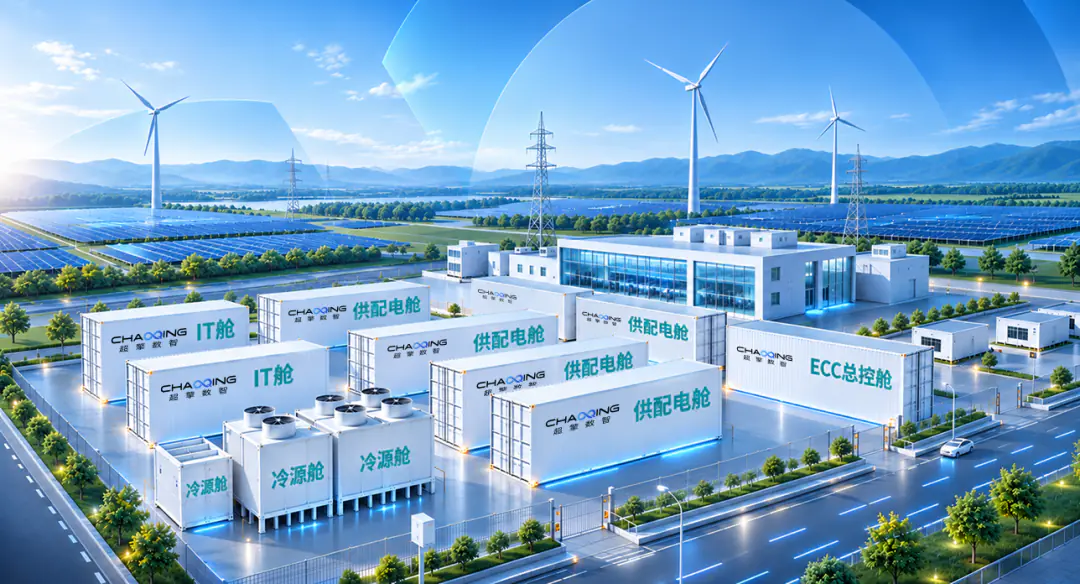
一个智算中心通常由 IT舱、冷源舱、供配电舱和ECC总控舱 组成。其中,供配电部分可根据项目规模配置中压、低压、电池、柴油发电及并机单元。各功能舱在工厂分别集成,到现场组合成完整系统。
- 高密算力承载(IT舱): IT舱是主要的算力承载单元。典型单箱配置为13个柜、512张算力卡,计算、存储、网络和管理设备在同一舱内部署,具体数量和配比可根据GPU类型及业务需求调整。单柜功率最高可达120kW,适合部署高密度液冷服务器。后续需要扩容时,可以以单箱为单位增加模块,并同步扩充网络和存储能力。
- 冷板式液冷散热: 散热采用冷板式液冷。冷板贴合CPU、GPU等主要发热部件,冷却液经二次侧管路进入冷板,再通过CDU与一次侧冷源完成热交换。系统采用1+1冗余设计,双管路、双泵组和双回路互为备用,一路需要检修时,另一路可以继续承担散热任务。对于网络、存储等未全部采用液冷的设备,则由精密空调配合散热。
- 无损高速网络: 网络采用Spine-Leaf架构,可按集群规模选择两层或三层组网。方案支持400G无损网络、1:1无阻塞收敛、自适应路由和动态拥塞控制,减少分布式训练中的丢包、重传和通信等待。两层网络可支撑8192卡,三层网络可扩展至16384卡及以上。
- 分布式并行存储: 存储部分采用分布式并行架构,支持GPUDirect Storage,减少数据在CPU和内存之间的额外搬运。全闪与混闪可以分别承担热数据、训练检查点和归档数据,并通过副本、纠删码、多协议访问及在线扩展等机制,兼顾性能、容量和数据安全。
- 高可靠供配电与总控: 供电链路覆盖中压柜、低压模组、小母线和机柜PDU。A/B双路2N架构配合IT设备双电源,降低单路故障对业务的影响;电池单元用于市电中断后的短时续电,为柴油发电系统启动争取时间。ECC总控舱统一采集配电、制冷、动环、消防和安防信息,便于日常监控、告警和能耗分析。
二、极速交付:90%工程化预调测,建设周期极限压缩
iMDC将约 90% 的集成工作放在工厂完成,包括舱体生产、设备安装、管路和线缆连接,以及出厂前的检查与预调测。相比全部在现场施工,这种方式能够减少多专业交叉作业,也更容易控制安装质量和一致性。
项目启动后,超擎数智首先确认算力规模、GPU选型、训练或推理负载、扩容计划,以及现场的电力、水源、承重和空间条件,再确定各功能舱配置。设备到场后,完成吊装落位、水电接入、外部网络连接和系统联调,随后进入验收环节。
验收不仅检查设备能否正常运行,还包括供电切换、液冷温度和流量、网络吞吐与拥塞控制、存储性能及集群通信测试。依托CQIS服务体系,超擎数智可以继续提供网络与算力协同调优、运行检查和后续运维支持,帮助集群从安装完成平稳过渡到业务运行。
在供货和现场条件满足要求的情况下,标准项目建设周期可缩短至8–12周。对于局部改造或应急部署项目,现场条件具备后还可进一步压缩上线时间。
三、降本增效:预制化智算中心的四重收益
- 缩短算力等待时间。 工厂预制与现场准备可以并行推进,减少施工和联调对项目进度的影响,让算力更早投入训练或推理任务。
- 提高空间利用率。 单柜最高120kW,算力密度可提升2–3倍,适合电力和场地有限、但需要部署高密GPU的项目。
- 显著降低长期运行成本。 方案PUE可控制在1.2以内,部分高性能计算场景可低至1.1,具体表现取决于负载率、当地气候和系统配置。双路供电、冗余液冷及存储数据保护,则为集群连续运行提供保障。
- 投资与扩容更具弹性。 客户不必一次性完成全部投资。以集装箱为模块按需建设,算力、网络和存储同步扩展,更适合业务规模仍在增长或需求尚未完全确定的项目。
四、超擎数智:以全栈实力重新定义AI基础设施交付
在智算中心步入“百千瓦单柜、万卡级集群”的深水区后,单一硬件的堆砌早已无法满足复杂的AI业务需求。iMDC集装箱液冷智算中心之所以能够实现“预制化生产、8–12周极速投产”,其背后依托的是超擎数智在AI基础设施领域深耕多年的全栈技术体系与服务能力。
通过iMDC,超擎数智将传统智算中心建设中重复、复杂的工程环节标准化,同时保留设备和规模的配置弹性。对客户而言,交付的不只是一个装有服务器的集装箱,而是一套经过联调、开箱即可承接实际业务的智算系统。
从漫长的现场施工,到标准化的工厂预制;从单点硬件拼装,到全栈方案的整建制交付。超擎数智正帮助更多政企、科研院所与企业跨越AI基础设施周期鸿沟,让澎湃的高密算力第一时间转化为驱动产业升级的智能生产力。