从单机验证到团队高并发:DGX Spark集群解锁本地智能体生产力新路径
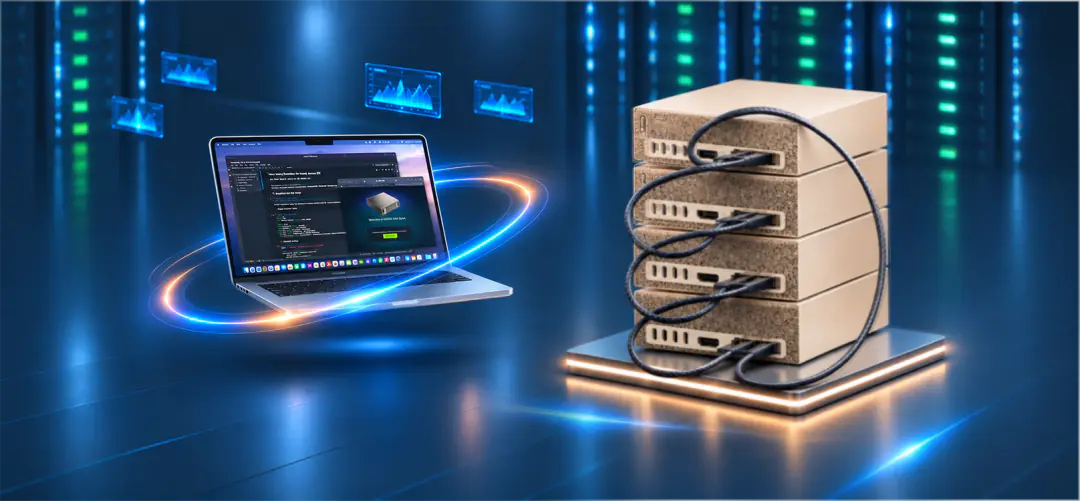
智能体高频使用让云端 API 的成本、限流与数据合规短板迅速放大。基于 GB10 Grace Blackwell 的 NVIDIA DGX Spark 以 128GB 统一内存、1000 AI TOPS 与 170W 低功耗实现本地推理;四台或八台集群经 ConnectX-7 组网可池化出 512GB–1TB 统一内存与 4–8 PFLOPS 算力,支撑私有代码辅助研发、知识库检索与本地微调三大场景。
近期,随着WorkBuddy等桌面智能体工作台的普及,以及DeepSeek-V4.1-Flash在推理效率与代码、文档处理表现上的迭代,企业内部使用AI的方式正在发生实质性变化。
过去,大模型更多停留在网页端的单轮问答;如今,智能体开始直接接入本地工作环境,跨文件夹检索资料、批量解析业务报表、扫描整个代码仓库并自动执行脚本。
AI与具体业务流程的距离被大幅拉近,但新的工程瓶颈也随之浮现。
一旦智能体的调用从个人零星尝试转向研发或业务团队的日常高频使用,云端API模式的局限便会迅速放大。
一方面,智能体完成一项复杂任务往往需要经历任务拆解、工具调用、结果校验与多轮反思,单次任务的Token消耗量是普通对话的数倍乃至数十倍,长期调用成本难以收敛,且外部接口的限流、拥塞或网络波动会直接打断自动化工作流。
另一方面,智能体要发挥真实生产力,前提是获得核心源代码、技术规范、财务单据与内部合同的读取权限,而这类高密级数据在多数企业的安全规范中明确要求"数据不出内网"。
既要充分发挥智能体框架与前沿开源模型的协同效率,又要守住数据合规边界、维持可预期的算力投入,将高性能算力直接下沉至办公与研发一线,正在成为企业解锁本地智能体生产力的一条务实路径。
一、智能体走向本地运行,硬件底座需要补齐什么能力?
在本地运行大模型与智能体,并非简单购置几张消费级显卡就能解决。智能体工作负载对底层硬件提出了两个十分具体的要求:足够的显存容量以容纳模型权重与长上下文,以及极高的内存带宽以降低多轮交互时的首字延迟。
当开发或业务人员在WorkBuddy中挂载本地DeepSeek-V4.1-Flash等模型执行复杂任务时,系统不仅要常驻模型本身的参数,还要动态维护不断增长的上下文缓存(KV Cache)。传统PC或普通工作站受限于PCIe总线带宽与显存墙,面对长文本读取或多任务并发时极易出现吞吐骤降,使智能体退化为"慢速脚本"。而如果为此专门立项采购传统机架式AI服务器,又往往受制于单卡极高的功耗、机房配电改造、专业散热条件及漫长的交付周期,很多部门级或中小规模的智能化需求在基础设施阶段便被高门槛劝退。
NVIDIA推出的桌面级AI超级计算机DGX Spark切中了这一断层。
在紧凑机身内,DGX Spark搭载了NVIDIA GB10 Grace Blackwell超级芯片,配备第五代Tensor Core并支持FP4计算精度,单机可提供高达1000 AI TOPS的计算性能。更重要的是其内存架构设计:GB10通过NVIDIA NVLink-C2C互连技术,将20核Arm架构CPU与Blackwell GPU紧密耦合,构建起128GB LPDDR5x一致性统一系统内存,互连带宽达到第五代PCIe的5倍。这一架构能够实现GPU和CPU之间的数据访问,为内存密集型AI开发者工作负载优化性能。
同时,170W的整机功耗使其摆脱了对专业数据中心机房的依赖,在常规办公室或研发实验室环境下即可实现7×24小时稳定运行。
二、从个人桌面到团队协同,为什么需要四台与八台集群?
单台DGX Spark足以支撑个人开发者在桌面上完成模型原型验证,但当应用场景升级为企业团队的生产力底座时,单节点的物理边界就会显现。
在实际研发与经营场景中,算力需求往往是并发且混合的。单机128GB内存一旦同时承接多路并发的KV Cache与计算请求,响应时延便会明显拉长。这也是以四台或八台DGX Spark组建本地小型超算集群的核心逻辑:通过横向扩展实现算力与统一内存的池化。
DGX Spark机身原生集成ConnectX-7高速智能网卡,为多节点扩展预留了高规格硬件接口。当四台或八台DGX Spark通过高速交换机完成低时延组网后,原本独立的桌面节点便聚合为一个拥有512GB至1TB统一内存空间、总算力达4至8PFLOPS的紧凑型AI集群。充裕的东西向通信带宽保障了张量并行、流水线并行及多实例负载均衡的顺畅调度,让多智能体并发任务互不抢占资源。
依托这套本地集群与DeepSeek-V4.1-Flash、WorkBuddy的组合,企业能够在三个高确定性场景中快速兑现生产力价值:
一是高密级代码库的私有化辅助研发。 金融、制造、能源及核心软件企业的源码严禁外传。研发团队将WorkBuddy的模型后端指向内网DGX Spark集群部署的DeepSeek-V4.1-Flash,即可在完全物理隔离的环境下完成跨模块代码理解、遗留系统重构、单元测试生成与缺陷排查。充足的集群并发能力保证了多人同时调用时的毫秒级响应,让辅助编码真正嵌入日常开发节奏。
二是企业私有知识库的深度检索与文档处理。 面对常年积累的PDF技术手册、历史项目方案、招投标文件与合规合同,集群可同时部署高精度嵌入模型、向量数据库与生成式推理服务。智能体在本地直接读取原始文件、提取关键条款并交叉比对,既省去了海量文档上传云端的带宽开销与泄密隐患,也显著提升了长文档推理的完整度。
三是面向垂直业务的模型本地微调与迭代。 通用开源模型进入具体行业后,往往需要结合企业内部规范与专业语料进行定向优化。DGX Spark预装完整的NVIDIA AI Enterprise软件套件,涵盖NGC容器化应用目录与RAPIDS加速库。团队在白天可将四台或八台集群主力用于在线推理服务,夜间及空闲窗口则可平滑切换至LoRA或参数高效微调任务;未来若业务规模进一步扩大,整套工作流还可在几乎不改动代码的前提下,无缝扩展至更大规模的数据中心基础设施。
三、让算力真正转化为生产力,交付考验的是全栈技术服务能力
从投入产出的角度核算,四台或八台DGX Spark集群提供了一种更为精细的基础设施配置方式。它以模块化的固定资产投入,替代了随调用量不断膨胀的公有云,也避开了初期盲目建设大型机房带来的算力闲置与运维重负。企业可以先以四节点集群快速跑通核心部门的智能体工作流,再随团队接入规模平滑扩容至八节点乃至更大规模,使每一分算力投入都与实际业务负载相匹配。
但同样需要看到,将多台高性能设备连接成网,并不自动等同于一套开箱即用的智能体生产系统。多节点集群在本地分布式推理框架下的切分策略、高速互联网络的拥塞控制与参数调优、DeepSeek系列模型在Blackwell架构与低精度格式下的吞吐优化,以及底层推理服务端点与WorkBuddy等上层智能体工具的并发对接,每一个环节都会直接影响终端用户的实际体感。
作为AI原生的基础设施产品和全栈方案提供商,以及NVIDIA Compute(计算)与Networking(网络)双Elite精英级合作伙伴,超擎数智正在将这一复杂的系统集成过程标准化。目前,超擎数智不仅支持NVIDIA DGX Spark现货在仓、快速交付,更围绕四台及八台DGX Spark集群打造了涵盖高速网络互联配置、分布式推理环境部署、主流开源模型优化及本地智能体工作流联调的全栈交付方案。
AI应用的竞争正在从早期的概念验证,转向真实业务环境下的效率、成本与安全综合比拼。当算力走出传统机房、以轻量集群的形态部署在离业务最近的地方,企业无需在数据安全与前沿智能之间作出妥协,本地智能体的规模化生产力也由此真正具备了落地的工程基础。