超擎实测:KV Cache复用让等待时间缩短97%,大模型推理如何跑出"企业级速度"
超擎数智基于擎天系列平台(8×RTX PRO 5000 72GB Blackwell)与 vLLM + LMCache 缓存链路,对 Qwen3-235B 开展长上下文 KV 复用实测:32K 输入首 Token 时延由 34.875 秒降至 0.975 秒(缩短约 97.2%),8 组用例总吞吐均超 10 万 Token/s,显存溢出压力测试 256 并发零失败。
AI产业正在经历从"训练"转向"推理"的关键阶段。当企业将大模型引入实际业务——知识库问答、智能体调度、长文档分析——一个共同的挑战摆在眼前:如何让AI既能处理长上下文,又能快速响应多人并发,还不让算力成本失控?
问题的关键在于:当同一份材料被反复调用时,系统能否"记住"已经计算过的内容,避免每次都从头开始?这项被称为KV Cache复用的技术,正成为大模型推理效率提升的核心突破口。
围绕这一产业痛点,ODCC AI存储实验室完成了一次系统级的性能验证。测试结果显示:通过软硬件的深度协同,长上下文推理的响应时延可以从30多秒缩短至1秒以内,效率提升达97%以上。
硬核测试:Qwen3-235B推理性能实测
本次测试基于超擎数智擎天系列高性能硬件平台,采用8张NVIDIA RTX PRO 5000 72GB Blackwell GPU,结合vLLM、LMCache与第三方共享存储,验证开源千亿参数模型Qwen3-235B在长上下文KV复用场景下的表现。
核心测试数据:
- 最高总Token吞吐达到131,125 Token/s;
- 32K输入、并发4时,warm首Token时延为975毫秒。
一、性能基础:八卡576GB显存,承载235B级模型
部署大模型,显存需要同时为模型权重、KV Cache和运行时数据提供空间。输入越长、并发越高,缓存需求也会随之增加。
超擎本次采用擎天系列高性能硬件平台,每张GPU配备72GB GDDR7 ECC显存,单卡显存带宽为1,344GB/s,八卡标称显存容量合计576GB。Blackwell架构的计算能力与大容量显存,共同构成模型运行的硬件基础。
测试模型为Qwen3-235B-A22B-Instruct-2507-FP8,采用混合专家架构,总参数量为 235B,每个Token激活约22B参数。较低的激活参数量有助于控制计算开销,完整模型权重仍需纳入部署容量规划。
本轮关键配置:
| 项目 | 测试配置 |
|---|---|
| 硬件平台 | 超擎数智擎天系列高性能硬件平台,测试标识 RTX5K-2 |
| GPU配置 | 8×NVIDIA RTX PRO 5000 72GB Blackwell |
| 模型 | Qwen3-235B-A22B-Instruct-2507-FP8 |
| 并行与精度 | TP8+EP,模型权重 FP8,KV Cache BF16 |
| 服务上下文上限 | 131,328 Token |
| 客户端网络 | 2×400Gb/s,两个端口均有实际流量 |
| 推理与缓存链路 | vLLM+LMCache 多进程+第三方共享存储 |
八张GPU通过张量并行与专家并行共同运行模型,双400G网络端口连接外部KV存储,为已有缓存的读回提供数据通路。这里的576GB为各卡显存之和,权重与缓存仍需按并行策略分配,并预留运行空间。
二、性能实测:长上下文、并发与显存溢出的多维验证
本轮测试围绕长输入处理、并发变化和容量压力展开,分别观察Prefill预填充与Decode生成阶段的表现。测试采用vLLM、LMCache与第三方共享存储,每个Prefill用例先执行1遍cold,再执行5遍warm;每遍均reset并清空L1缓存,以核查网络存储中的KV复用路径。
长上下文:8组用例的KV复用总吞吐均超10万Token/s
本次Prefill测试覆盖2K至128K输入,以及不同并发配置。在已有KV可复用的warm条件下,8组用例的总Token吞吐均超过10万Token/s。
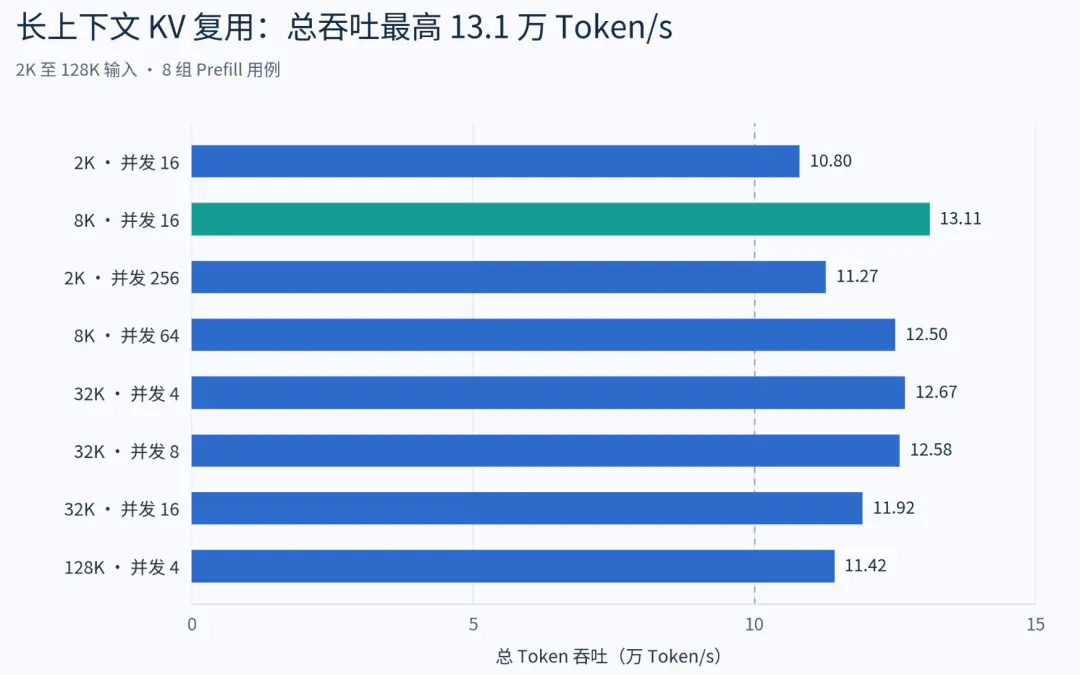
其中,8K输入、并发16的总吞吐达到本轮最高的13.1 万 Token/s;128K输入、并发4时,总吞吐约为11.4 万 Token/s。这些结果展示了超擎数智擎天系列高性能硬件平台与推理框架、外部缓存链路在不同长输入负载下的协同表现。
对于企业知识库、技术资料问答等需要反复读取相同材料的应用,模型计算与缓存读回都应纳入硬件方案验证。
响应效率:32K输入,首Token等待缩短至975毫秒
用户提交请求后,需要先等待模型处理输入,才能收到第一个输出Token。首Token时延(TTFT)反映的就是这段等待时间。
将相同负载的cold与warm结果放在一起,可以更直观地看到KV复用带来的变化:
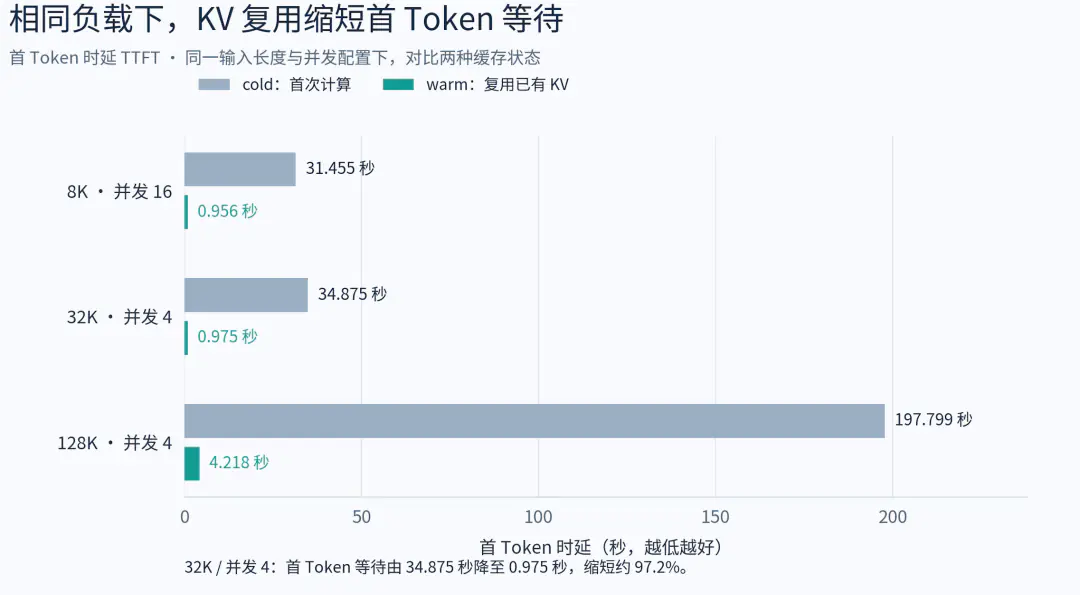
以32K输入、并发4为例,首Token时延由cold阶段的34.875秒降至warm阶段的975毫秒,缩短约97.2%。在128K输入、并发4的用例中,warm首Token时延为4.218秒。
对围绕同一份报告、产品手册或业务规则反复提问的任务,保存并读回已有 KV,可以减少重复处理相同前缀的计算。这类收益以缓存可复用为前提,体现的是整套推理与缓存系统的协同效率。
并发扩展:32K输入下的时延与吞吐表现
硬件平台需要承载多个请求时,并发设置会影响用户体验。本轮测试在固定32K输入的条件下,分别观察了并发 4、8、16 时的表现,让这一变化有了更清楚的对照。
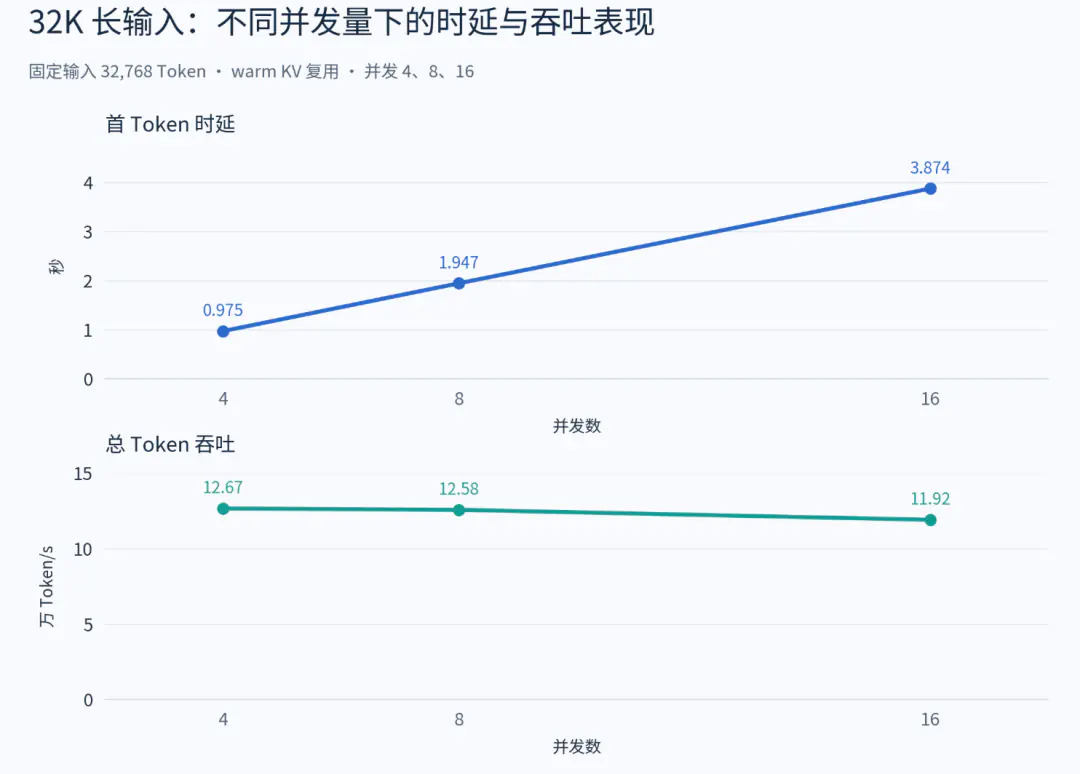
并发从4增加至16时,warm总吞吐处于约11.9万—12.7万 Token/s,首 Token 时延则由约1秒增加至约3.9秒。更高并发没有带来同比例的吞吐增长,却增加了首次响应前的等待。
这意味着,交互式问答需要根据用户可接受的等待时间设置并发;批量分析任务则可以结合处理时限安排任务。对企业算力基础设施选型而言,目标模型、输入长度、并发与响应时间应当作为一组条件共同验证。
显存溢出:同时观察首次响应与后续生成
随着上下文和并发增加,KV 缓存也会带来更大的容量压力。本轮进一步设置了3组显存溢出 Decode 用例,并发均为256,覆盖不同输入长度及128、512、2,048 Token的输出规模。每组均完成256个请求,失败数为0。
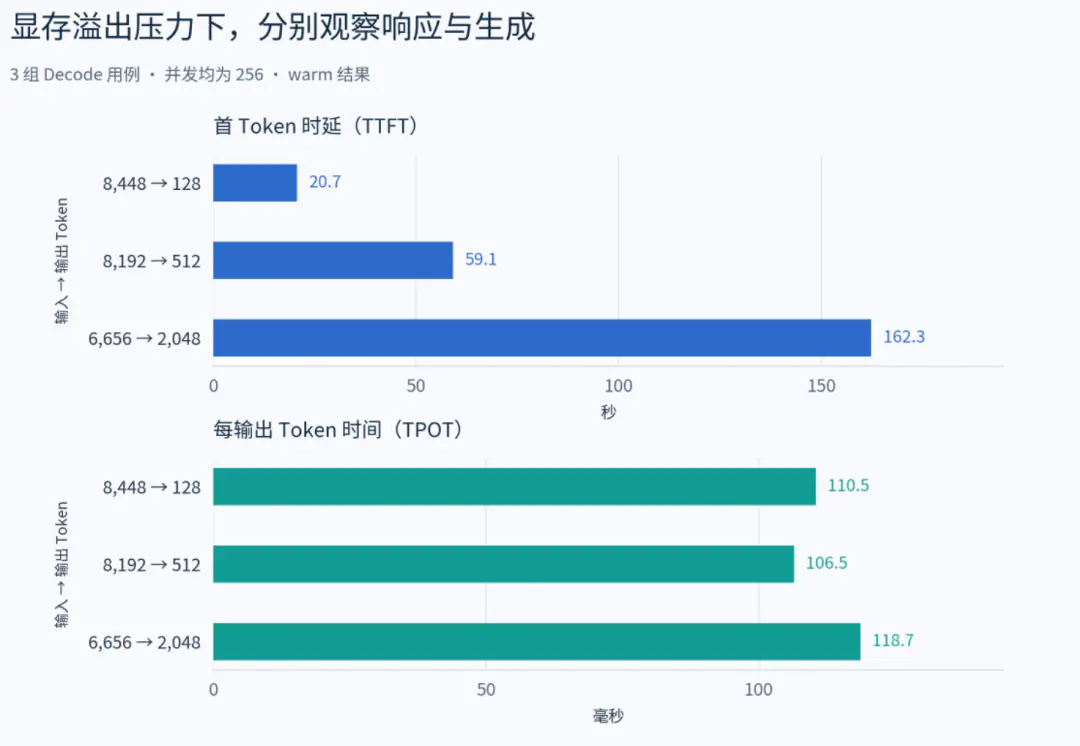
图中分别呈现首Token 时延(TTFT)与每输出 Token 时间(TPOT):前者反映开始响应前的等待,后者反映后续生成阶段的速度。
三组用例的warm TPOT处于106.5—118.7 毫秒区间,首Token 时延则为20.7—162.3秒。这说明,在容量压力下,开始响应和后续生成需要分别评估。三个用例的输入与输出长度均有变化,其差异应结合各自负载条件理解。
在本轮显存溢出压力测试中,超擎数智擎天系列高性能硬件平台与外部缓存链路完成了所测请求。企业可据此进一步明确业务对首次响应、持续生成和任务完成时间的要求,确定适合自身场景的硬件平台、并发及缓存配置。
三、从实验室到生产环境:超擎数智的全栈交付能力
从这次测试可以看到,长上下文推理涉及模型计算、显存分配、缓存管理和网络读回。这不是单个设备能解决的问题,而是需要系统协同的工程实践。
围绕这些需求,超擎数智的核心优势是能提供硬件平台产品与配套工程服务。CQIS(CHAOQING Infrastructure Service)是超擎打造的标准化AI集群全周期交付服务体系,覆盖规划、部署、调试、验收及后续支持,帮助企业有序推进基础设施建设。
面向真实负载,让算力基础设施选型有依据。 同样运行Qwen3-235B,短问答、长文档分析和批量任务,对显存、并发与时延的要求各不相同。超擎可结合目标模型、输入输出长度、缓存复用条件和响应目标开展方案验证,帮助客户确定GPU配置及网络、存储配套,让服务器投入对应到具体任务。
围绕完整系统,让软硬件协同发挥作用。 CQIS从硬件、GPU驱动、操作系统、CUDA及关键组件纳入版本基线与兼容性验证,并围绕系统部署、网络通信和性能调优开展工程实施。结合集群审计调优服务,超擎可定位计算、网络与存储环节的瓶颈,形成检测记录和优化方案,为后续维护与扩展保留清晰依据。
通过标准交付,让部署成果便于维护。 从验收标准、测试计划到问题处理、报告与技术交接,CQIS将交付工作落实到可检查的结果。企业可根据自身团队能力和现场条件,选择CQIS Care远程支持、CQIS Guard现场服务或CQIS Shield交钥匙交付,并按项目需求配置验收、培训与后续支持。
超擎数智正在构建的,是一套从硬件性能到系统交付的完整能力体系。这套体系不是简单的产品交付,而是将性能领先的AI算力基础设施产品、ODCC实验室的独立验证、CQIS的标准化交付、AI创新中心的方案PoC有机整合,形成了从测试验证到生产部署的闭环能力。真正帮助千行百业构建高性能AI算力底座,全栈加速行业智能落地。