推理引擎崩溃后,如何实现秒级恢复?超擎数智实测NVIDIA Dynamo Shadow Engine
大模型推理服务中,Engine故障后重启可能需要2-3分钟,这段时间内请求堆积、用户等待、服务体验急剧下降。NVIDIA Dynamo的Shadow Engine技术将恢复时间缩短至1秒以内。本文,超擎数智技术团队通过实际测试数据,解析这项技术如何实现推理容量的秒级恢复,以及超擎数智AI Driver人工智能推理平台如何将其纳入生产环境。
大模型推理服务中,Engine故障后重启可能需要2-3分钟,这段时间内请求堆积、用户等待、服务体验急剧下降。NVIDIA Dynamo的Shadow Engine技术将恢复时间缩短至1秒以内。本文,超擎数智技术团队通过实际测试数据,解析这项技术如何实现推理容量的秒级恢复,以及超擎数智AI Driver人工智能推理平台如何将其纳入生产环境。
大模型推理服务中,一个容易被忽视的问题是:推理引擎故障后,服务本身可能仍然在线,但原有的推理容量并不会立即恢复。
假设集群中有两个推理Worker,各自承担一半流量。其中一个Worker的Engine因CUDA错误、NCCL异常退出,只要另一个Worker仍然正常,整个服务通常不会立即中断。但系统总推理容量会瞬间下降,剩余Worker需要承接更多请求,随后可能出现请求排队增长、首Token时间(TTFT)上升以及单用户解码吞吐下降等一系列问题。
因此,对于大模型推理服务来说,更值得关注的并不只是进程重启时间(Process Restart Time),而是推理服务容量恢复时间(Time to Restore Serving Capacity)。
为什么推理Engine的恢复这么慢?
一个LLM Engine从进程启动到真正能够接收请求,需要完成模型权重加载、GPU显存分配、NCCL通信器初始化、KV Cache创建、Kernel预热、CUDA Graph Capture等一系列工作。
对于几十GB甚至几百GB的模型,仅重新加载模型权重就可能需要数百秒甚至更长时间。更关键的,是传统方式下,模型权重对应的GPU显存分配通常跟随Engine进程的CUDA Context生命周期。当Engine退出后,相关显存分配会被回收。即使GPU和节点本身仍然正常,新启动的Engine也需要重新建立显存状态并加载模型权重。
Dynamo的处理方式,是将模型权重的生命周期与具体的Engine进程解耦。
2GMS:将模型权重从Engine生命周期中解耦
Dynamo引入GPU Memory Service(GMS),由独立组件持有模型权重对应的GPU物理显存,而Engine负责将这部分显存映射到自己的GPU虚拟地址空间。传统方式下,可以简单理解为:
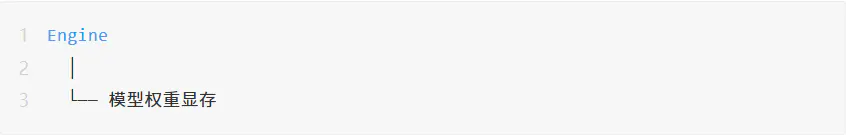
引入GMS后则变为:
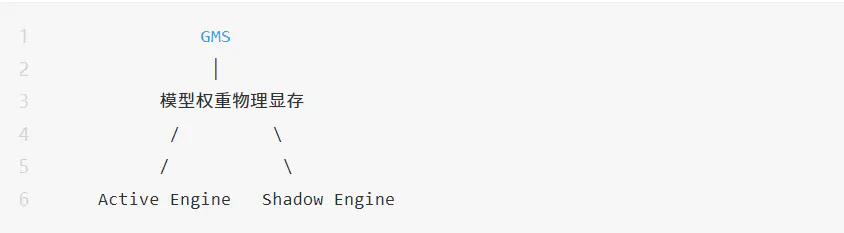
因此,即使Active Engine退出,只要GMS仍然正常,模型权重所在的GPU物理显存就可以继续保留,新Engine不需要重新加载完整模型。
同时,Active Engine和Shadow Engine可以将同一份模型权重物理显存映射到各自的虚拟地址空间,因此Shadow Engine不需要在HBM中额外维护一份完整的模型权重副本。这意味着在显存中只保留一份模型权重,但两个Engine都可以访问。
这一能力的底层基础,就是CUDA Virtual Memory Management(CUDA VMM)。
CUDA VMM:共享的是物理显存,而不是指针
使用cudaMalloc() 时,从应用程序视角看,申请GPU显存和获得一个可访问的GPU地址基本被封装在一次操作中。CUDA VMM则将GPU物理显存与虚拟地址空间进一步拆分。
通过cuMemCreate() 可以创建GPU物理显存,通过cuMemAddressReserve() 保留一段GPU虚拟地址空间,再使用cuMemMap() 建立两者之间的映射关系。
这意味着两个 Engine 可以拥有不同的虚拟地址:
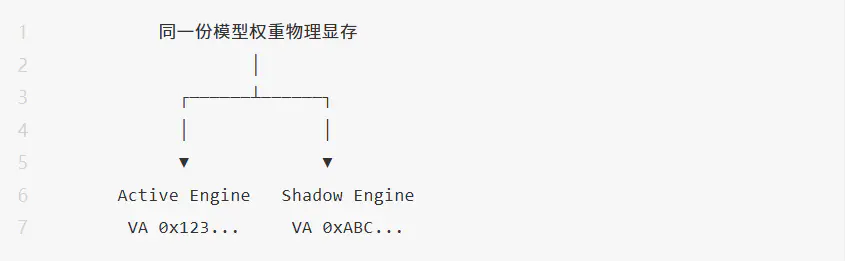
虽然两个Engine看到的虚拟地址不同,但最终可以访问同一份物理显存。因此,GMS实际共享的并不是某个GPU指针,而是底层的物理显存。Engine仍然在自己的地址空间中访问模型参数,GMS主要负责这部分GPU物理显存的持有和生命周期管理。
Shadow Engine:提前完成恢复路径中的高开销初始化
仅解决模型权重加载,还不足以实现秒级恢复。
一个Engine在启动过程中还需要初始化CUDA Context、NCCL通信器,并完成Kernel预热和CUDA Graph Capture。这些状态与具体Engine进程相关,无法简单从故障Engine迁移到另一个新进程。
Shadow Engine Recovery的做法,是在故障发生前预先启动一个备用Engine,并提前完成大部分初始化工作。
正常运行时:
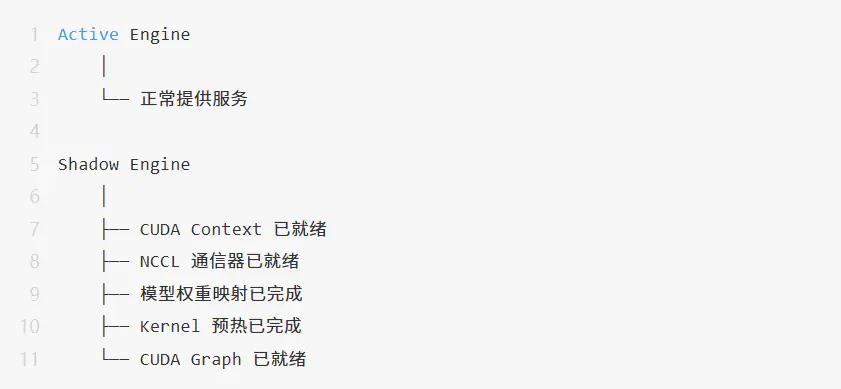
Shadow Engine 完成初始化后进入Standby,不参与正常请求处理。
因此,传统Cold Restart的恢复路径:
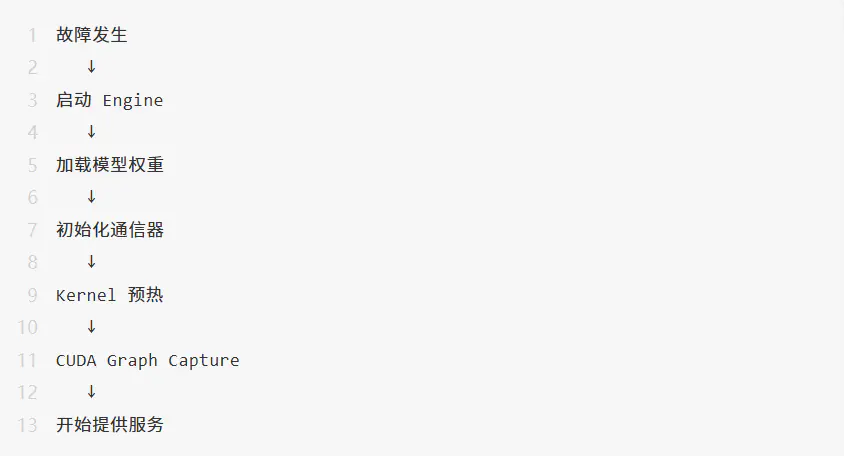
可以大幅缩短为:
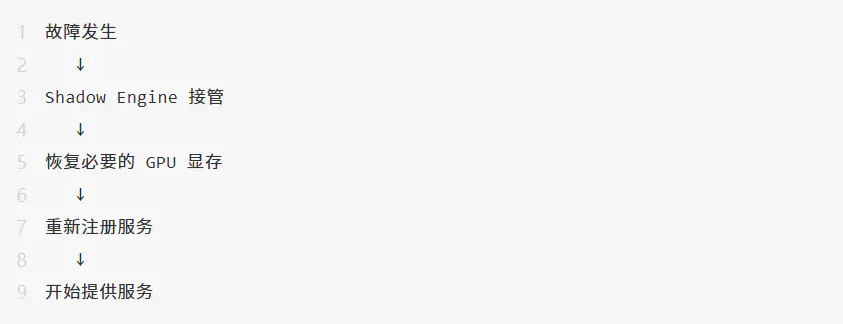
本质上,Shadow Engine并没有消除模型加载、通信器初始化或CUDA Graph Capture的开销,而是将这些操作提前执行,使其从故障恢复的关键路径中移除。
** Shadow Engine的显存开销控制**
为了让Shadow Engine可以长期处于待机状态,Dynamo还需要控制备用Engine的GPU显存开销。
其中,模型权重可以通过GMS在Active Engine和Shadow Engine之间共享,因此不需要保留两份模型权重物理显存。
KV Cache则采用不同的处理方式。Shadow Engine可以提前保留KV Cache所需的虚拟地址空间,但在待机状态下,并不需要为整段地址分配实际的物理显存。
因此,Shadow Engine可以提前建立运行所需的地址空间和运行时状态,而将大块KV Cache物理显存的实际分配推迟到真正接管时。发生故障后,Shadow Engine完成必要的显存分配和服务注册,即可开始接收请求。
原Active Engine随后可以由Kubernetes重新拉起,完成初始化后成为新的Shadow Engine:故障前:A = ActiveB = Shadow故障后:B = ActiveA = Shadow整个过程更接近Active/Standby的角色切换,而不是传统的“崩溃 → 冷重启 → 恢复”。
Shadow Engine Recovery优化的也正是这一点:不是单纯缩短进程重启时间,而是尽可能缩短推理容量下降的持续时间。
超擎数智AI Driver已完成NVIDIA Dynamo适配
Shadow Engine Recovery解决的是推理Engine层面的快速故障恢复问题,但在实际生产环境中,一个推理服务并不是独立运行的。从模型部署到服务上线,还涉及GPU资源分配、推理实例调度、服务生命周期管理、状态监控以及故障后的资源恢复等一系列平台能力。Dynamo提供了推理运行时层面的能力,而这些能力最终仍然需要与上层的集群管理和调度系统结合。目前,超擎数智AI Driver人工智能推理平台已完成 NVIDIA Dynamo 适配,可以将Dynamo作为底层推理运行时,纳入现有的模型服务和GPU资源管理体系。AI Driver本身提供模型管理、推理服务、集群与算力管理等能力。用户可以在平台中完成模型准备、推理实例创建以及服务生命周期管理,平台则负责底层GPU资源的统一调度和运行状态维护。对于上层用户来说,仍然是在AI Driver中选择模型、配置运行资源并发布推理服务;在底层,平台可以根据服务配置使用Dynamo提供的推理运行时能力,其中也包括本文介绍的GMS和 Shadow Engine Recovery。也就是说,Dynamo并不是作为一套独立于现有平台之外的系统存在,而是作为推理运行时的一部分被纳入AI Driver的统一管理体系: