从51.2T到102.4T:当AI集群突破万卡规模,网络成为新瓶颈,NVIDIA Spectrum-6如何重构下一代AI以太网
NVIDIA Spectrum-6 将单芯片交换容量从 51.2Tb/s 提升至 102.4Tb/s,SerDes 升级至 200G PAM4;SN6600 以 128×800G 高密度端口,让 1024 卡 Blackwell 集群交换机数量减半、光模块与线缆减少约 50%,显著降低大规模 AI Fabric 的 TCO。超擎数智提供全栈 AI 网络方案。
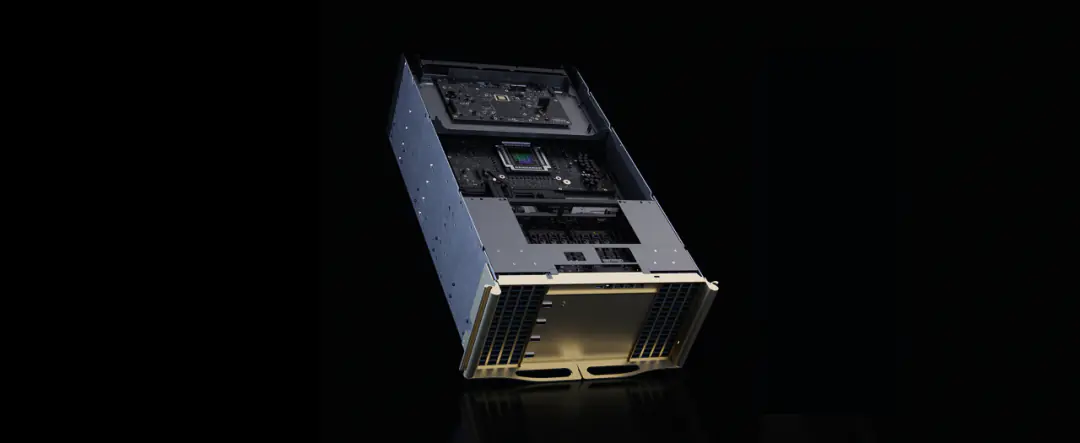
过去几年,AI服务器的演进速度明显快于传统数据中心基础设施。从Hopper到Blackwell再到Vera Rubin,GPU算力、HBM容量以及GPU间通信带宽都在快速提升。对于AI集群来说,网络已经不再只是服务器之间的数据通道,而正在成为决定GPU利用率、训练效率和集群扩展能力的关键基础设施。
尤其当AI集群从几百张GPU扩展到数千、数万甚至更大规模后,传统数据中心网络开始暴露出越来越明显的问题。GPU之间的通信往往具有高度同步、大流量和突发性强等特点,All-Reduce、All-Gather以及MoE场景下的All-to-All通信,都可能在短时间内对网络造成非常高的压力。如果交换机端口密度不足、网络层级过深,或者拥塞控制能力不足,最终结果往往不是网络"跑得慢一点",而是大量GPU等待网络完成同步。
在这样的背景下,NVIDIA推出了新一代Spectrum-6交换芯片,以及基于Spectrum-6打造的SN6000系列交换机。其中,SN6600是这一代产品中最具代表性的风冷、可插拔光模块交换机。
如果说上一代SN5610代表了Spectrum-4时代51.2Tb/s、800G以太网交换机的主流形态,那么SN6600则将单芯片交换容量进一步提升到102.4Tb/s,并将800G端口密度从64个提升到128个。
从产品演进的角度看,SN6600并不是简单把SN5610的性能翻倍,而是在交换容量、SerDes速率、端口Radix、光模块密度以及AI网络扩展能力上进行了一次系统升级。
作为NVIDIA Compute(GPU)、Networking(网络)双Elite精英级合作伙伴,超擎数智第一时间获得了Spectrum-6及SN6000系列的深度技术支持,并基于多年AI网络设计与交付经验,带来这篇深度解读。
一、Spectrum-6:102.4T只是表面上的变化
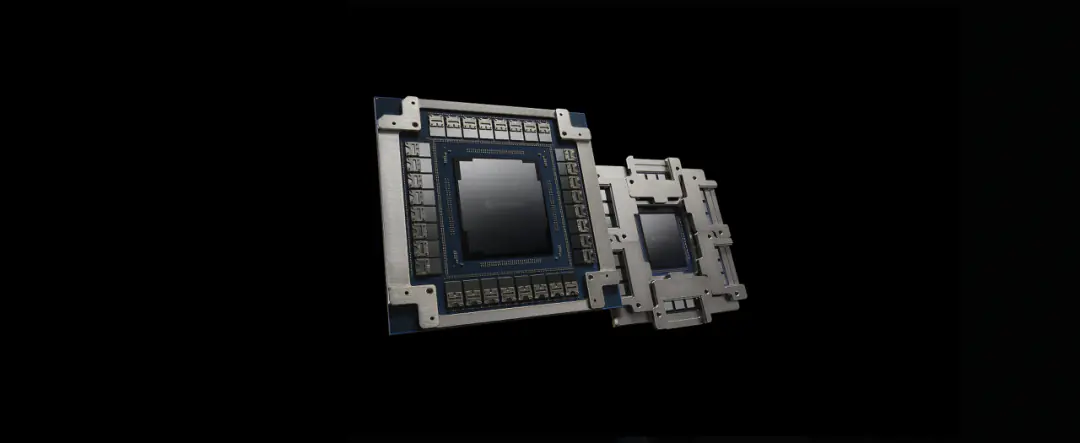
SN6600的核心是NVIDIA Spectrum-6交换ASIC。上一代Spectrum-4的单芯片交换容量为51.2Tb/s,而Spectrum-6将这一数字提升到了102.4Tb/s,交换容量正好翻倍。
单看这个数字,似乎只是"性能提高了一倍",但Spectrum-6真正值得关注的变化,是底层SerDes从100G PAM4提升到了200G PAM4。
上一代Spectrum-4在实现一个800G接口时,需要8条100G SerDes;到了Spectrum-6时代,同样一个800G接口只需要4条200G SerDes。
简单来说,单Lane速率提高以后,在相同的芯片I/O资源条件下,可以支持更高的端口密度。
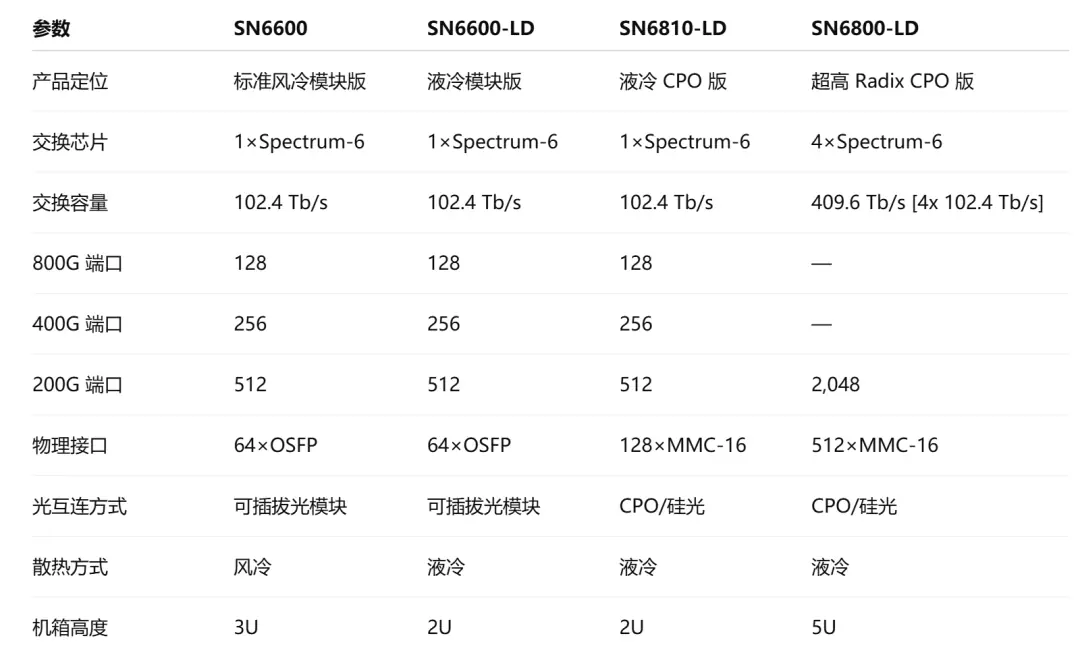
表格1 NV SN6000系列交换机参数
这一变化直接反映在SN6600的规格上。SN6600单机可以提供102.4Tb/s的交换容量,并支持最高128个800GbE逻辑端口;如果以400GbE方式使用,则最多可以提供256个400G端口。
对于传统数据中心交换机,交换容量提升通常意味着单机性能更强;但对于AI网络,更重要的是交换机Radix提升以后,一张网络能够以更少的节点连接更多服务器。
这也是Spectrum-6相对于Spectrum-4最核心的价值之一。
二、SN6600:一台交换机做到128个800G
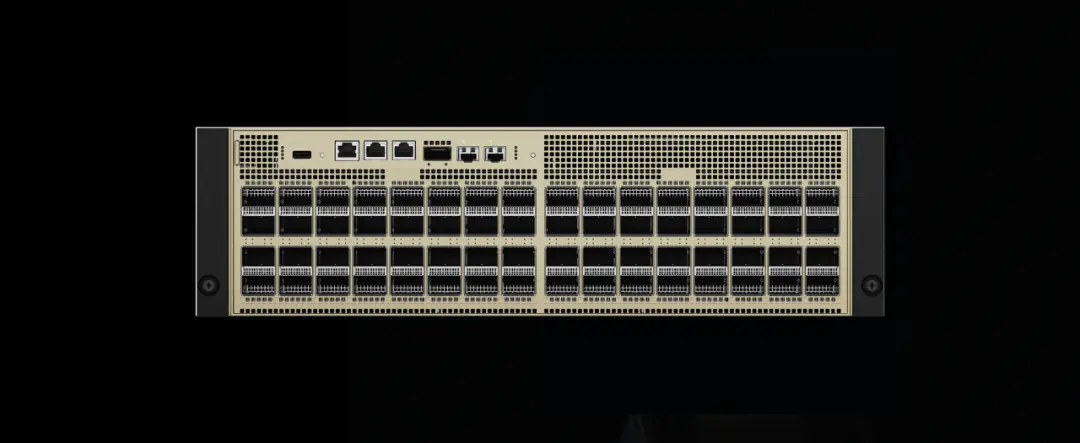
从产品形态上看,SN6600仍然是一台相对"传统"的数据中心交换机。它采用3U机箱、风冷设计以及可插拔高速光模块,这一点与很多用户现有的数据中心网络部署方式保持一致。
但在相似的运维模式下,它的端口密度已经发生了明显变化。
上一代SN5610基于Spectrum-4 ASIC,整机交换容量51.2Tb/s,可以提供64个800G端口。SN6600基于Spectrum-6后,交换容量提升到102.4Tb/s,同时将逻辑800G端口数提升到了128个。
因此两代产品之间最直观的变化可以概括为:SN5610是51.2Tb/s、64×800G,而SN6600则是102.4Tb/s、128×800G。
如果进一步拆分,SN6600还可以提供256×400G或512×200G的逻辑端口配置。
这种灵活性对于现阶段AI集群非常重要,因为并不是所有GPU服务器都会直接使用800G接口。例如B300平台搭配ConnectX-8时,服务器侧依然可能大量采用400G Ethernet,因此交换机能否高密度提供400G端口,直接决定了Leaf层需要多少台设备。
从这个角度看,SN6600虽然是一台"800G交换机",但其真正的价值并不局限于800G本身,而是提供了一个高密度的102.4T Ethernet交换平台,可以同时覆盖400G、800G乃至下一代更高速网络的部署需求。
三、为什么128×800G对AI网络非常重要
对于普通企业网络来说,一台交换机从64个端口增加到128个端口,可能只是设备密度提高。但对于大规模AI集群来说,这种Radix提升会对整个网络架构产生明显影响。
假设网络采用典型的两层Leaf-Spine架构,并按照1:1无阻塞方式设计。
对于一台64×800G的SN5610,可以将其中32个800G端口作为服务器Downlink,另外32个端口作为到Spine的Uplink。
如果换成128×800G的SN6600,同样按照1:1无阻塞方式设计,就可以使用64个800G端口连接服务器,另外64个800G端口连接Spine。
这意味着在服务器规模相同的情况下,Leaf交换机数量理论上可以减少约一半。
更重要的是,Spine层也会同时受益。因为SN6600本身的端口数量同样翻倍,一台Spine可以连接更多Leaf,所以整个Fabric的交换节点数量都可能明显减少。
例如一套原本需要32台Leaf和16台Spine的网络,在端口利用条件合适的情况下,采用SN6600后可能减少为16台Leaf和8台Spine。也就是说,整个网络可以从48台交换机下降到24台。
这也是为什么在评估Spectrum-6时,不能只比较"一台SN6600多少钱"和"一台SN5610多少钱"。
对于大规模AI Fabric来说,更有意义的问题应该是:同样规模的GPU集群,一共需要多少台交换机?多少个光模块?多少条光纤?需要多少机柜空间?整个Fabric功耗是多少?
一旦按照整个网络进行计算,Radix提升的价值就会被明显放大。
四、从Blackwell架构集群来看,SN6600带来的变化更加直观
如果把SN6600放到具体的Blackwell架构AI集群中看,它的高Radix优势会更加明显。
以1024卡Blackwell集群为例
假设1024张Blackwell GPU,对应128台8-GPU服务器;以每台服务器配置16×400G Scale-Out接口为例,则整个集群需要2048个400G服务器接入端口。网络采用两层Leaf-Spine,并按照1:1无阻塞设计。
- SN5610:可提供128×400G逻辑端口,其中64个用于服务器接入、64个用于上联,因此需要32台Leaf和16台Spine,共48台交换机。
- SN6600:可提供256×400G逻辑端口,其中128个用于服务器接入、128个用于上联,因此只需要16台Leaf和8台Spine,共24台交换机。
在光互连方面,SN5610基于100G SerDes,一个800G接口通常可拆分为2×400G;SN6600基于200G SerDes,一个1.6T接口可承载4×400G。因此,在相同400G逻辑链路数量下,SN6600交换机侧所需的高速光模块和物理连接数量理论上可进一步减少约50%。
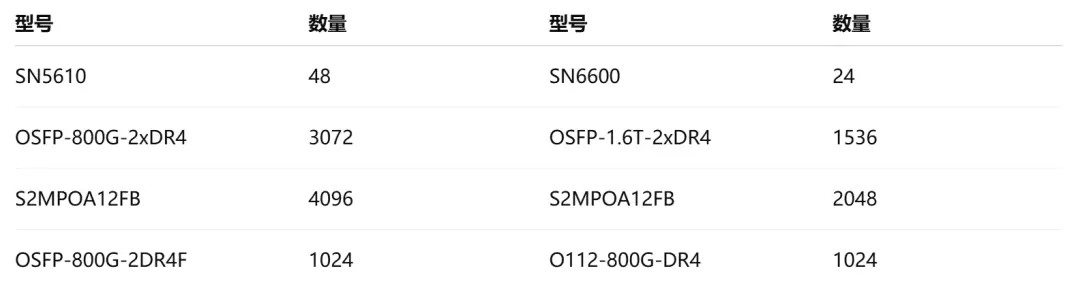
整个网络的400G逻辑链路数量并没有变化,减少的是交换机侧的物理模块和线缆组件数量。
最终带来的好处是:更少的交换机、更低的前面板连接密度,以及更简单的布线和运维。
因此,从1024卡Blackwell架构集群来看,SN6600的优势并不只是把单台交换容量从51.2Tb/s提高到102.4Tb/s。更高的端口密度可以让交换机数量从约48台减少到24台,同时通过1.6T级高速接口进一步降低交换机侧光模块和线缆组件数量。
Blackwell架构当前网卡侧仍以100G SerDes为主,而SN6600交换机侧已经进入200G SerDes时代。两端电侧SerDes速率不同,因此需要在光模块侧完成速率和Lane数量的适配。
一种可行的适配方案是在网卡侧采用O112-800G-DR4光模块,将网卡侧8×100G电接口转换为4×200G光信号。
这样虽然服务器侧和交换机侧的电SerDes代际不同,但进入光路后,两端均采用200G/lane的光信号,能够与SN6600侧的200G SerDes光互连体系保持一致。
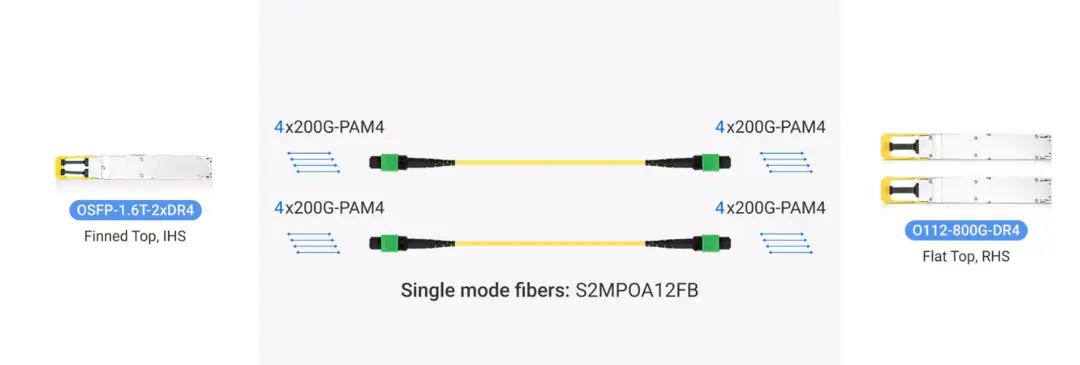
通过这种"8电4光"的转换方式,可以在不改变Blackwell服务器和网卡侧现有100G SerDes架构的前提下,直接接入Spectrum-6/SN6600的200G SerDes网络。既保护了现有Blackwell端侧投资,又能够发挥SN6600在102.4Tb/s交换容量、更高Radix以及更高端口密度方面的优势,实现Blackwell平台向Spectrum-6网络的平滑演进。这也是SP6相对于SP4最有价值的地方之一。
五、交换机数量减少,真正影响的是整个Fabric的TCO
对于大规模AI网络,交换机数量减少带来的价值往往会层层传导。
首先是设备本身。交换机数量下降,意味着采购设备数量减少,同时需要配置的电源、管理接口、备件数量都会下降。
其次是光互连。虽然同样规模的服务器最终需要传输的数据带宽并不会因为更换交换机而消失,但高Radix交换机能够减少网络节点数量,并降低部分交换机间互连的复杂度。在新一代1.6T光模块体系下,交换机侧的物理光模块密度也会进一步降低。
第三是机房空间。SN6600本身虽然是3U,而SN5610是2U,但当交换机总台数减少一半后,整个Fabric占用的机架空间依然可能明显下降。
最后是运维复杂度。对于数千甚至上万张GPU组成的AI集群来说,网络中的设备数量越多,出现端口、风扇、电源、光模块或者链路故障的概率也会越高。减少网络节点,本身就意味着减少潜在故障点。
因此SN6600真正带来的TCO优势,并不一定表现为单台设备更便宜,而更可能体现在整个网络需要更少的交换节点、更少的机柜资源以及更简单的网络架构。
六、SN6600并不只是"SN5610×2"
如果只看产品规格,SN6600很容易被理解成一台容量翻倍的SN5610。51.2T变成102.4T,64×800G变成128×800G,看起来只是简单的2倍关系。
但从系统角度来看,这种变化带来的结果并不是线性的。
因为交换机Radix提高以后,Leaf可以连接更多服务器,Spine可以连接更多Leaf,两边同时扩大,最终可支持的两层Clos网络规模会快速增长。
这会带来一个非常重要的价值:尽可能延长两层Leaf-Spine网络的生命周期。
在超大规模AI集群中,如果两层网络无法继续扩展,就必须增加Super-Spine,形成三层Fabric。网络增加一个层级以后,意味着增加一组交换机、一组光模块和大量互联光纤,同时也会增加网络跳数和故障域。
因此对于AI网络而言,一个高Radix交换芯片的重要价值,就是让集群在更大规模下仍然有机会保持两层架构。
从这个角度来看,Spectrum-6的102.4T并不仅仅是在提升性能,而是在提高整个AI Fabric架构的上限。
七、SN6600适合什么场景?
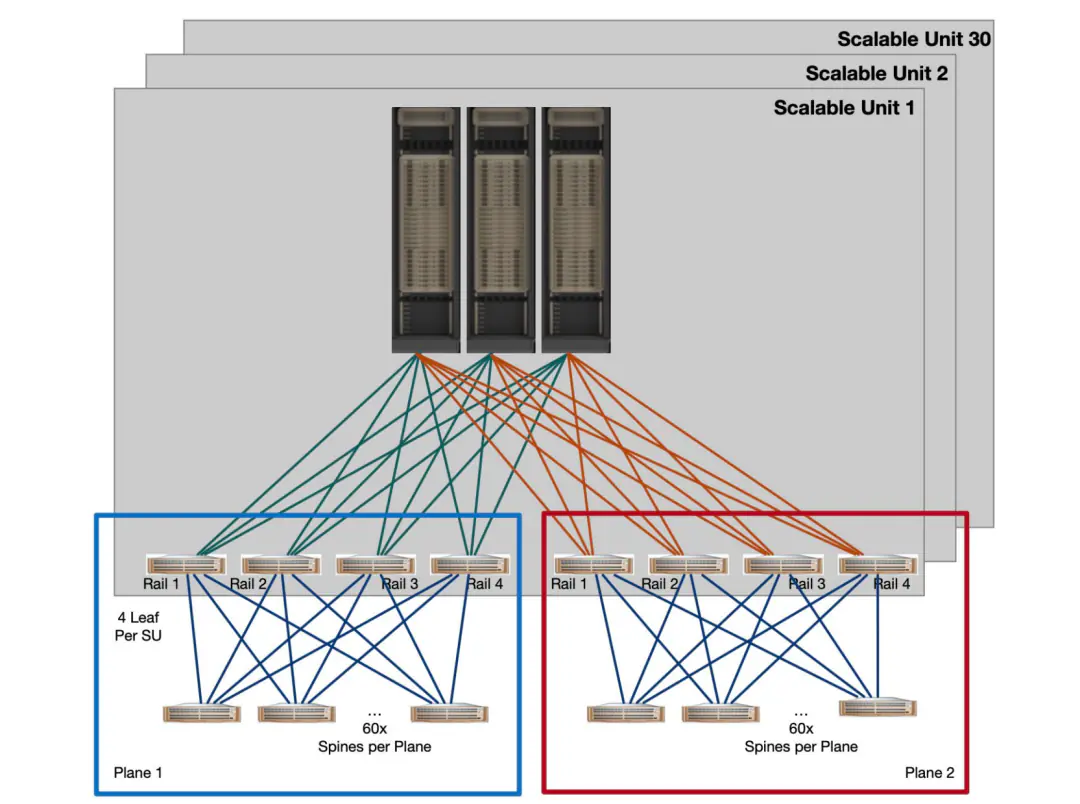
如果从实际部署角度判断,SN6600比较适合几类典型场景。
第一类是新建的大型AI集群。 对于计划部署数千到数万GPU、同时希望网络长期向800G乃至更高速率演进的项目,102.4T交换容量和128×800G端口能力可以明显提高Fabric扩展空间。
第二类是已经大量采用Spectrum-X、希望从Spectrum-4逐步升级的用户。 SN6600依然采用风冷、可插拔光模块和标准交换机形态,因此对现有数据中心运维体系的影响相对较小。
第三类是对交换机数量、机柜空间和网络层级非常敏感的项目。 尤其在GPU规模不断扩大以后,Radix往往比单端口速率更加重要。
当然,如果项目规模并不大,例如只有几百张GPU,而且现有SN5610两层网络已经能够满足需求,那么升级到SN6600未必能够立刻体现明显经济收益。SP6真正的优势,会随着集群规模扩大而逐渐放大。
八、超擎数智:从产品到方案的全栈AI网络能力
作为NVIDIA Compute(GPU)、Networking(网络)双Elite精英级合作伙伴,超擎数智在Spectrum-6及SN6000系列产品发布后,第一时间完成了方案适配。
在产品层面,超擎数智提供相关系列交换机,以及覆盖1.6T、800G、400G全速率等级的高速光模块和结构化布线解决方案,确保从交换到互连的完整高速通路。
在方案层面,超擎数智基于多年AI集群设计与交付经验,为客户提供从网络拓扑设计、设备选型、光互连方案到工程实施的端到端服务。尤其在Blackwell平台向Spectrum-6网络演进过程中,超擎数智能帮助客户实现跨SerDes代际的平滑升级。
在服务层面,超擎数智通过CQIS服务,为AI集群提供从交付验收、性能基线建立到持续优化的完整保障,确保网络在全生命周期内持续释放价值。
九、从SN6600可以看到下一代AI网络的方向
过去我们评价一台交换机,通常会关注交换容量、端口速率、转发时延和功能特性。到了AI时代,这些指标依然重要,但评价方式正在变化。
越来越多用户开始关注一个新的问题:在同样数量的GPU下,到底需要多少台交换机才能把网络搭起来?
这背后实际上代表了AI网络设计逻辑的改变。GPU越来越贵,AI计算集群越来越庞大以后,网络的核心任务已经不仅仅是"提供足够带宽",而是尽可能减少GPU因为通信而等待的时间,同时降低整个Fabric的复杂度和成本。
Spectrum-6通过102.4Tb/s交换容量和200G SerDes提高单芯片Radix,而SN6600则把这种能力封装成一台风冷、可插拔光模块、可以直接进入数据中心部署的交换机。
因此,如果要给SN6600一个更准确的定位,它并不仅仅是一台"128口800G交换机"。
更准确的说法应该是:SN6600是NVIDIA把Spectrum-X Ethernet从51.2T时代推进到102.4T时代的核心产品,也是下一代大规模AI Scale-Out网络从"提高单链路速度"转向"提高整个Fabric效率"的关键节点。
从SN5610到SN6600,表面上是51.2T到102.4T,实际上变化的是整个AI网络能够承载的规模。而超擎数智,正在与NVIDIA及产业伙伴一起,将这种变化转化为可落地的AI基础设施方案,助力千行百业构建更高效、更可靠、更具扩展性的AI算力底座。