ODCC AI存储实验室 | 第三批KV Cache测试成果发布,UbiPower 18000实现推理性能量级跃升,超擎数智助力AI推理存储标准化验证
随着大模型技术快速普及,长上下文交互、高并发在线推理、复杂Agent任务逐步成为业务主流,AI产业全面进入大Token高效处理时代。推理环节的响应速度、并发承载能力与落地成本,直接决定AI业务用户体验与商业化成效。KV Cache作为大模型推理核心缓存技术,是提升推理效率、降低算力损耗的关键抓手。
随着大模型技术快速普及,长上下文交互、高并发在线推理、复杂 Agent 任务逐步成为业务主流,AI 产业全面进入大 Token 高效处理时代。推理环节的响应速度、并发承载能力与落地成本,直接决定 AI 业务用户体验与商业化成效。KV Cache 作为大模型推理核心缓存技术,是提升推理效率、降低算力损耗的关键抓手。
面对这一产业趋势,开放数据中心委员会(ODCC)专门成立面向 AI 存储领域的测试与研究平台——ODCC AI 存储实验室。实验室由超擎数智作为承载单位,聚焦大模型推理、KV Cache、存储加速等关键方向,致力于构建贴近真实生产环境、覆盖多元场景、可复现可推广的测评体系。通过构建真实业务链路,开展多模型、多架构、多算力、多传输路径的系统验证,为 AI 存储技术选型、部署规范与产业标准提供实测依据。
一、第三批测试:聚焦 KV Cache 卸载性能验证
本次为 ODCC AI 存储实验室 KV Cache 第三批测试,重点对泛联UbiPower 18000存储系统进行验证。测试覆盖 DeepSeek-R1、Qwen-235B 等主流大模型,涵盖 PD 一体与 PD 分离两类推理架构,采用高端 HBM 与中端 GDDR 两类 GPU 计算节点,并对比 GDR 与通用RDMA两种传输路径。
超擎数智为本次测试提供高性能算网环境支撑,确保测试环境的真实性与权威性。
二、UbiPower 18000:性能跃升、全场景适配、成本重构三重突破
针对大模型推理的核心问题,泛联 UbiPower 18000 通过内置 GPU KV Cache 智能代理,融合 GPU Direct RDMA(GDR)能力,绕过宿主机 CPU 调度与传统文件系统元数据操作开销,实现 GPU 显存与分布式存储池之间 KV Cache 张量块的高速直连读取。该架构突破 GPU 物理显存容量限制,将 GPU 工作内存扩展至高性能外部存储池,在无需升级 GPU 硬件的前提下,显著提升显卡并发承载能力,从架构层面解决长上下文推理、高并发场景下的性能问题。
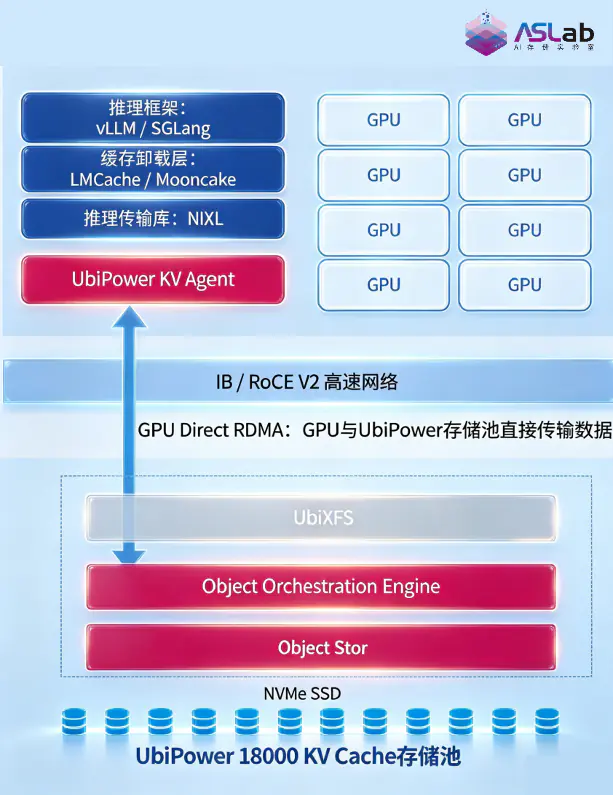
依托上述架构能力,UbiPower 18000 实现了:
显著降低TTFT(Time To First Token,首 Token 时延),降幅达 98%,优化推理响应速度;
大幅提升系统TPS(Tokens Per Second,每秒生成 Token 数),最大提升 65 倍,压低单位 Token 成本,提高 GPU 硬件投资回报率。
测试环境说明
为保障测评结果的真实性、通用性与权威性,实验室搭建多元化测试环境:
- 测试存储:泛联UbiPower18000 AI 原生分布式全闪存储集群,搭载自研 UbiXFS 分布式文件系统,支持 GPU Direct RDMA 与通用 RDMA 高速访问,承担本次全部 KV Cache 卸载存储能力;
- 模型适配:覆盖 DeepSeek-R1、Qwen-235B 等主流超大参数大模型,适配通用对话、长文本理解、复杂 Agent 推理等多元业务场景;
- 推理架构:同时验证 PD 一体、PD 分离两类主流部署模式,兼顾中小规模轻量化部署与大型智算集群分布式部署需求;
- 算力适配:采用高端 HBM GPU 与中端 GDDR GPU 两类计算节点开展验证,校验不同档位算力下的存储加速效果与性价比;
- 传输链路:分别测试 GPU Direct RDMA、通用 RDMA 两种传输路径,验证系统在不同传输方式下的性能表现。
整套测试体系极大还原企业真实生产环境,测评结论可直接指导产业规模化落地。
本次测试三大亮点
1.性能量级跃升,长上下文&高并发场景优势突出
在 8 卡 HBM GPU 服务器、DeepSeek R1 模型、Prefill-Only 场景、单网卡 400G 的测试环境下,测试对比了缓存重算(Cold)与 KV Cache 卸载至 UbiPower 18000(Warm)两种模式下的实际表现。结果显示,在 2K-100K 全区间上下文长度下,TTFT 均大幅下降,最高降幅达 98.4%;TPS 指标同步实现大幅增长,最高提升 65 倍。如下图所示。
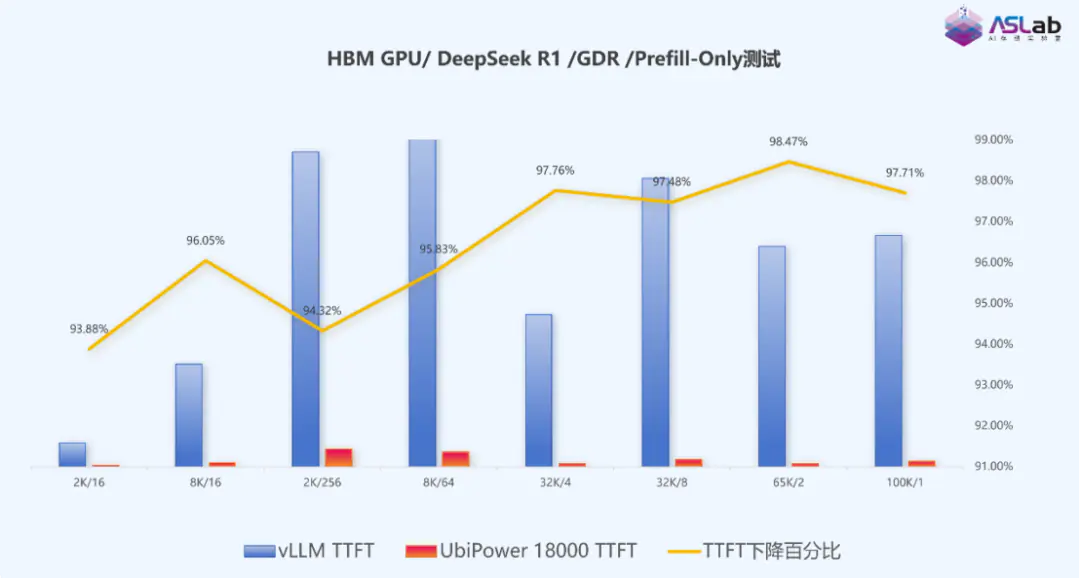
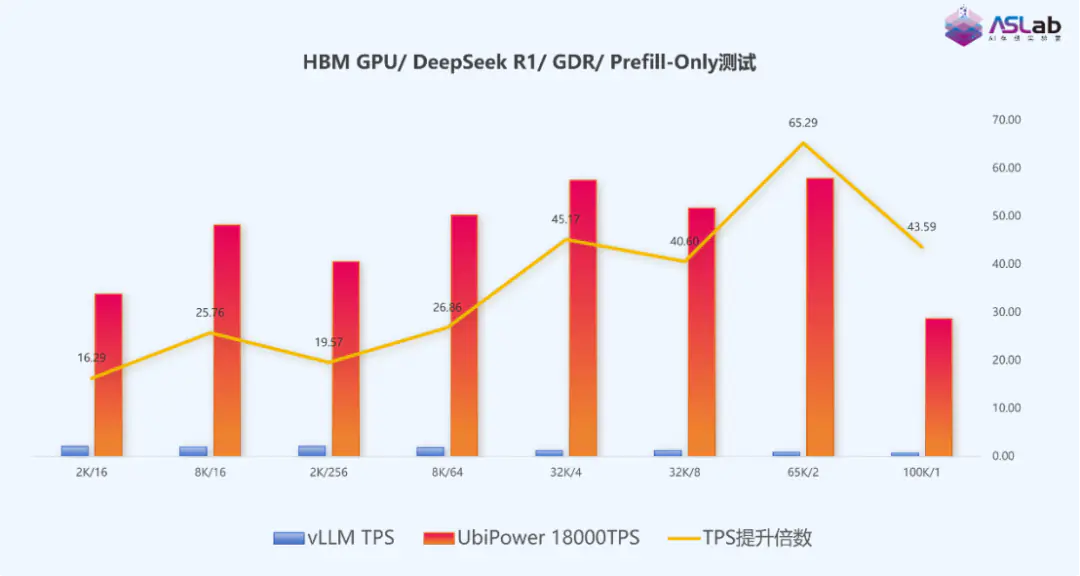
实测数据表明,对比 KV Cache 命中(Warm)与缓存重算(Cold)的性能差异,UbiPower 18000 的首 Token 时延(TTFT)最高降幅达 98%,Token 吞吐量(TPS)最大提升 65 倍。这一结果对应明确的业务价值:实现快速响应,使系统能够同时服务更多并发用户请求,并降低单 Token 成本。
因此,在 2K 至 100K 跨度的长上下文业务场景中,将 KV Cache 卸载至 UbiPower 18000 均可带来显著的推理性能增益;即使面对超高并发压力,系统仍能维持低 TTFT 时延,运行稳定,无明显性能抖动。
2.双 RDMA 路径全面适配,打破硬件生态壁垒
UbiPower18000 可支持 GPU Direct RDMA(GDR)、普通 RDMA 两种传输路径的 KV Cache 卸载系统,企业可依据现有硬件环境灵活选择,覆盖绝大多数 AI 集群部署场景。
对于硬件条件完备的高端算力集群,启用 GDR 直连通路,绕过主机内存完成 GPU 与存储之间零拷贝数据搬运,最大限度压低推理时延,释放极致性能;对于不具备 GDR 硬件条件的集群,可采用通用 RDMA 路径,经由主机内存中转完成 KV Cache 读写,同样完整实现 KV Cache 卸载能力。
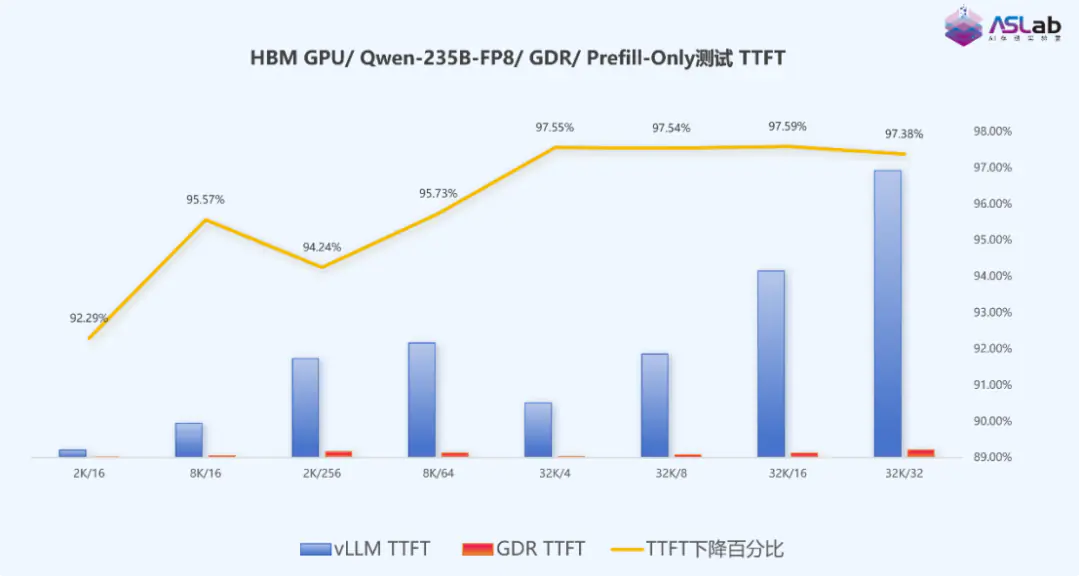
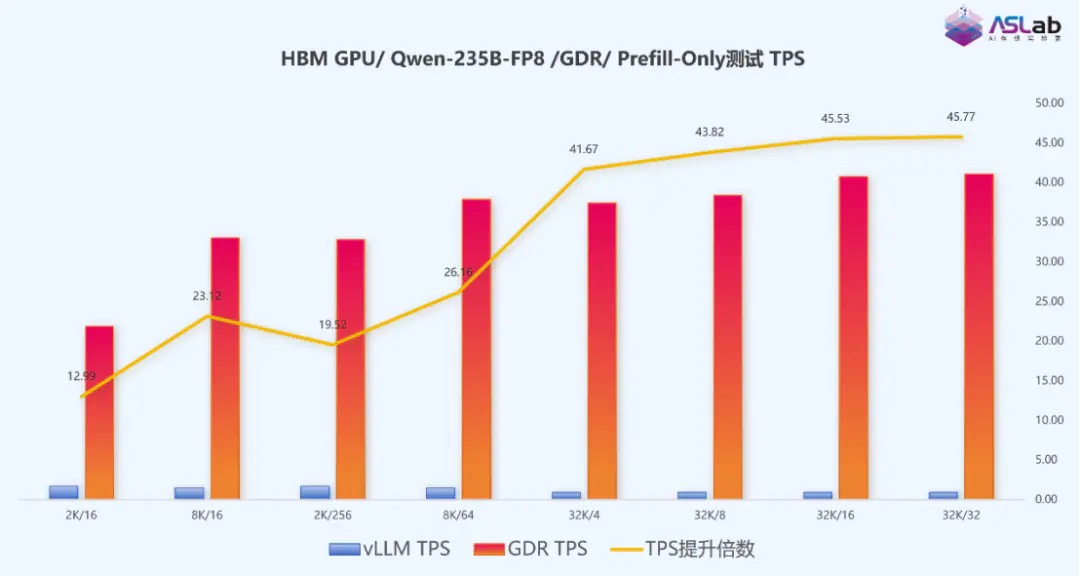
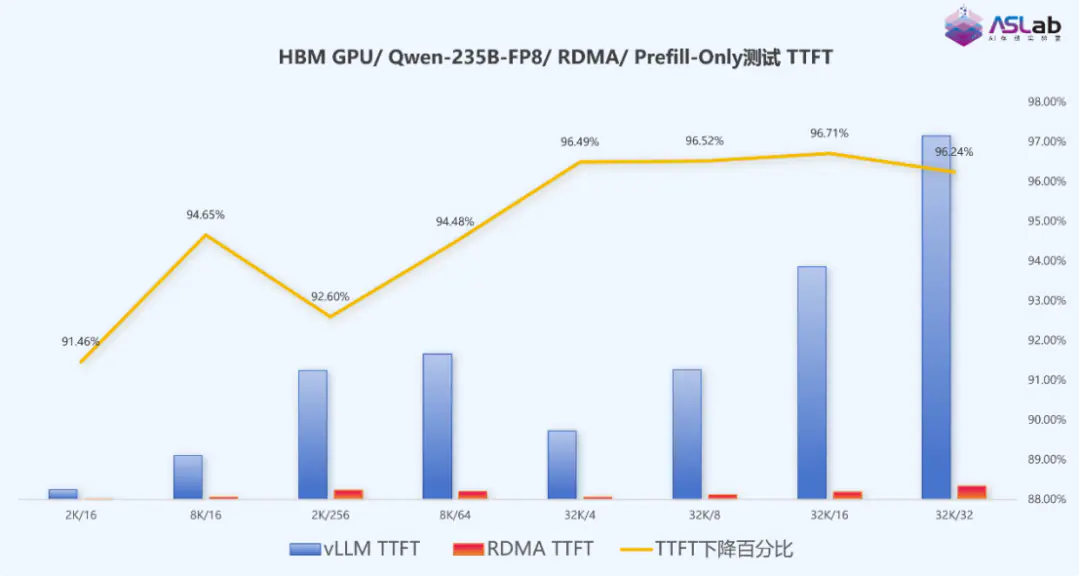
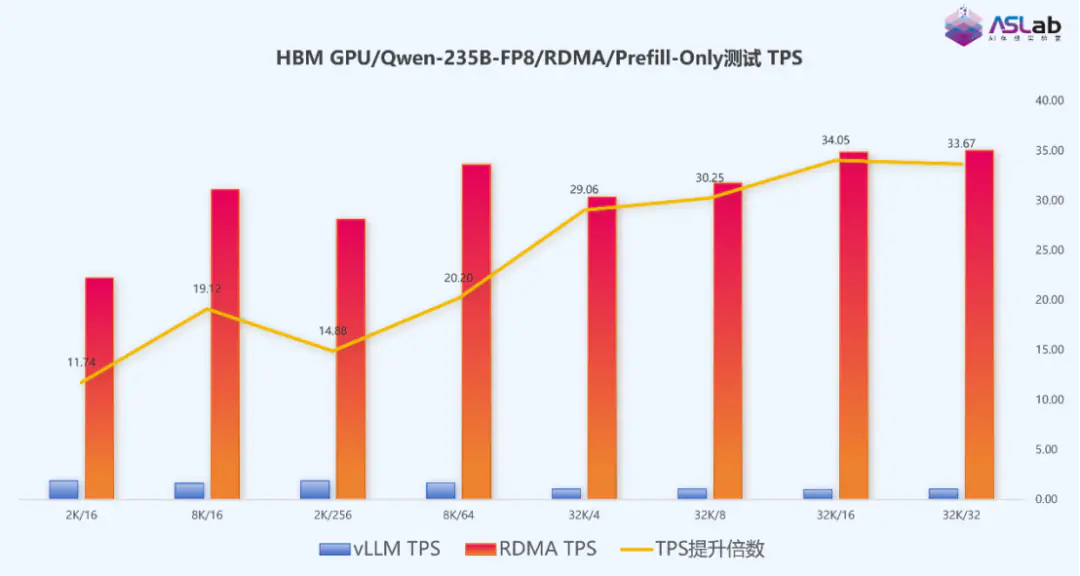
在 8 卡 HBM GPU 服务器、Qwen 235B 模型、Prefill-Only 负载、单网卡 400G 的测试环境下,分别对 GDR 传输与通用 RDMA 传输进行了测试。两组测试结果表明:两种传输路径均可带来显著推理性能提升,其中 GDR 模式的性能收益更为突出。
【通用 GDR 传输测试数据】
【通用 RDMA 传输测试数据】
3.缩小高低配算力差距,实现推理业务结构性降本
针对高端 HBM GPU 成本高昂、算力资源紧缺,而中端 GDDR GPU 推理性能不足的产业痛点,本次测评重点校验了 UbiPower 18000 在缩小高低配算力差距、降低推理成本方面的实际价值。
从测试结果来看,当 KV Cache 卸载至 UbiPower 18000 后,中端 GDDR GPU 的推理性能大幅提升,基于两类 GPU 服务器的 TTFT 时延差距明显收窄,部分测试场景下,基于中端 GDDR GPU 服务器的时延表现甚至优于 HBM GPU 服务器;在 TPS 维度,经过 UbiPower 18000 加速,两类服务器之间的性能差距同样显著缩小,部分场景下基于 GDDR GPU 的并发能力甚至更好。
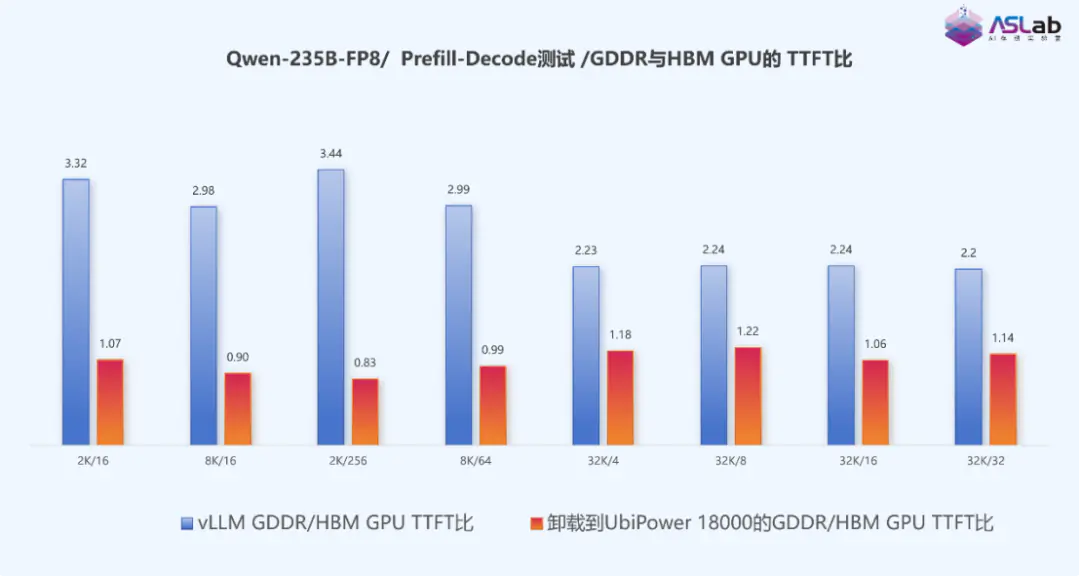
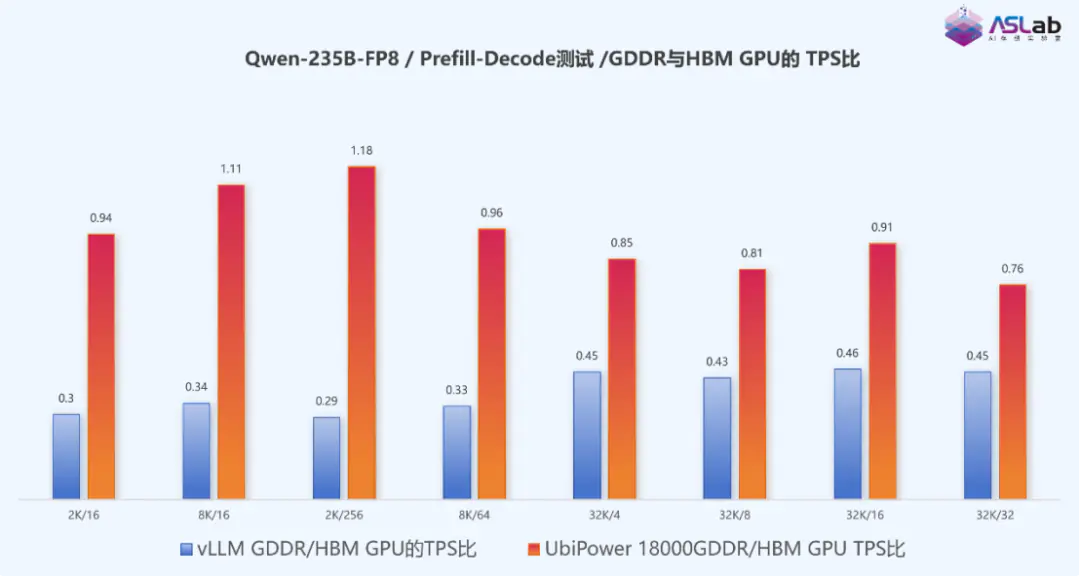
由此可以得出,针对企业大模型推理成本问题,企业无需大规模采购价格昂贵的高端 HBM GPU,转而采用中端算力集群与存储系统组合方案,即可获得接近高端算力的推理效果,从而有效降低大模型业务的落地门槛。
三、ODCC AI 存储实验室:从技术验证到规模化产业应用
此次 ODCC AI 存储实验室第三批测试顺利完成,测试中泛联 UbiPower 18000 在 TTFT、TPS 等关键指标上的表现,为 AI 推理存储的性能边界与成本空间提供了可复用的实测参照,也为后续测试方法、评价指标与部署规范的完善积累了重要依据。
作为 ODCC AI 存储实验室承载单位,超擎数智将持续依托自身在存算网协同领域的技术积累,为实验室测试验证工作提供高性能算网环境支撑,携手产业链伙伴推动 AI 存储测试体系建设,促进技术验证、标准研究与产业应用之间的有效连接。
未来,ODCC AI 存储实验室将继续围绕长上下文、高并发等核心场景,推进 KV Cache 测试体系持续迭代。我们欢迎更多存储厂商、GPU 厂商、模型服务商与行业用户加入后续测试与标准共建,把单点验证扩展为产业共识,让每一项测试结果都能转化为可落地、可复制、可推广的 AI 推理存储实践,共同推动大模型推理走向更高效率、更低成本、更广覆盖。