长飞光纤AI算力集群建设实践:以CQIS交钥匙工程与AI Driver平台构建智能制造AI落地新范式
超擎数智为长飞光纤交付 72 卡 80GB HBM3 AI 算力集群(9 台 SXM5 节点 + 400G InfiniBand 无收敛网络),依托超擎数智CQIS(CHAOQING Infrastructure Service)交钥匙集群交付服务完成规划、部署与调优,一周现场验收七大项一次性通过:NCCL 调优后 64 卡 AllReduce 达 441 GB/s,6 小时压测 186 万次请求成功率 99.98%;AI Driver 平台则将算力封装为可被业务调用的智能体服务。
随着生成式AI与行业大模型从概念验证走向工业级生产落地,制造业龙头企业对于AI算力基础设施的需求正在发生深刻变革。如今,企业真正需要的是一套能够跨越"算力建设、平台调度、智能体编排与业务系统融合"的全栈式智算体系。
在这一背景下,全球领先的光纤预制棒、光纤及光缆供应商,长飞光纤光缆股份有限公司(以下简称"长飞光纤")携手超擎数智,共同打造了新一代生产级72卡80GB HBM3 AI 算力集群及企业级智能应用底座。该项目由9台高性能SXM5计算节点组成,搭载 InfiniBand NDR 400无阻塞计算网络,依托超擎数智CQIS(CHAOQING Infrastructure Service)交钥匙集群交付服务与自研企业级Agentic AI平台AI Driver,在为期一周的严苛现场验收中,全部七大项测试一次性高分判定为"通过(合格)"。
本项目不仅是一次高性能算力底座的零故障交付,更是一次覆盖"算力底座、高速网络、智能体平台、交钥匙工程、量化验收"的系统级实践。超擎数智通过成熟的集群工程能力与全栈 AI 软件生态,助力长飞光纤从"建好集群"到"用好集群",再到"让集群里的模型真正走进业务流程"。
一、项目背景:AI 深度嵌入制造全链路,企业亟需生产级"算力+平台"双底座
在智能制造迈向深水区的今天,真正能为制造企业创造核心价值的,不再是单纯部署一个开源模型或搭建一个内部聊天窗口,而是将大模型能力与企业私域工艺知识、研发设计、质量管控及生产运营深度耦合,形成可自主执行复杂任务的 AI 生产力。
在推进 AI 规模化落地的过程中,长飞光纤面临三类典型的演进需求:
第一,高规格大模型训推对底层算力与互联提出极致要求。面向复杂工业场景的模型微调与高并发推理,需要具备超大显存带宽与满速互联能力的集群底座,任何单卡降频或网络通信瓶颈都会直接拖慢研发与生产响应效率。
第二,AI 能力亟需从"对话问答"升级为"业务自主执行"。企业需要将底层算力转化为业务部门可直接调用的智能服务,通过结合内部知识库、业务接口与多智能体(Multi-Agent)工作流,让模型按照企业规范自动完成工艺检索、数据分析与报告生成。
第三,高复杂度集群建设需要标准化、全链路工程交付保障。72卡高密SXM5集群涉及机房风火水电、400G IB胖树组网、全栈软硬件联调及严苛的性能压测,亟需专业团队提供"交钥匙"式工程服务,确保集群高起点规划、零故障上线。
本项目的核心建设目标,正是为长飞光纤构建一套达到官方满速标准、高稳可靠的72卡GPU生产级算力底座,并借由AI Driver平台打通算力向智能制造业务转化的"最后一公里"。
二、客户核心挑战
1. 高密 SXM5 集群硬件一致性与零故障交付挑战
项目包含9台高密度GPU节点、总计72张80GB HBM3 SXM5加速卡。大规模高功耗硬件在交付初期极易出现隐性硬件瑕疵(如ECC显存报错、退役页、掉卡或性能无法稳定在最高功耗态),如何确保全部节点与加速卡实现100%满血、零瑕疵交付,是保障后续长周期训练与推理稳定的首要前提。
2. 多机分布式通信瓶颈与网络满速调优挑战
在大模型分布式训练与大规模并行推理中,节点内NVLink与节点间InfiniBand网络的通信效率直接决定集群的线性加速比。若仅完成物理连线而缺乏深度的拓扑优化与集合通信(NCCL)调优,昂贵的400G IB网络往往无法跑满线速,导致算力资源在通信等待中被严重浪费。
3. 高并发生产环境下的长稳运行与吞吐极限挑战
工业级生产环境不同于实验室测试,平台上线后需承载多部门、多任务的持续高并发调用。集群能否在长时间、高负载的模型推理压测下保持极高的请求成功率与稳定的吞吐表现,直接关系到业务系统的可用性。
4. 传统 AI 平台难以跨越"模型部署"到"业务落地"的鸿沟
传统算力交付往往止步于IaaS层硬件连通或简单的模型部署,缺乏面向企业级应用的RAG知识检索、工具调用、安全沙箱与可视化工作流编排能力,导致 IT 部门建好了集群,业务部门却难以将其快速转化为研发、质检和运维助手。
5. 跨专业、长链路的集群建设与标准化验收难题
从机房选址勘探、三网分离设计、高密机柜布线,到软硬件全栈部署与性能验证,整个交付链路涵盖十余个专业环节。客户需要一套可量化、可追溯、标准化的交钥匙工程与验收体系,缩短投产周期并实现自主运维平稳交接。
三、方案设计:构建"算力底座 + 高速网络 + AI Driver 平台"三层协同架构
围绕长飞光纤对极致算力性能、无损网络互联与企业级智能体应用落地的综合需求,超擎数智采用"高性能算力资源池、400G IB 无收敛网络、AI Driver 智能体平台"三层协同设计,打造面向智能制造的全栈智算解决方案。
本次交付的 AI 算力集群由9台GPU计算节点组成,单机配置 8 张 80GB HBM3 SXM5 AI 加速卡,整机搭载双路Intel Xeon Platinum 8558、约 2TB DDR5 内存与 6 块三星 PM9A3 NVMe SSD,节点间通过 ConnectX-7 NDR 400G 网卡组成两级 InfiniBand fat-tree 网络。
1. 硬件本体:零故障交付
- 9 台节点 72 张 GPU 规格完全一致,0 Xid、0 ECC、0 退役页、0 掉卡,所有 GPU 处于 P0 最高性能态。
- HBM3 显存带宽实测约 3.2 TB/s(标称 3.35 TB/s 的约 95%),8 卡间离散度 CV≤0.01。
- BF16 稠密算力实测 849–857 TFLOPS,FP64 达到理论峰值的 98%。
2. 互联与网络:满速级集合通信
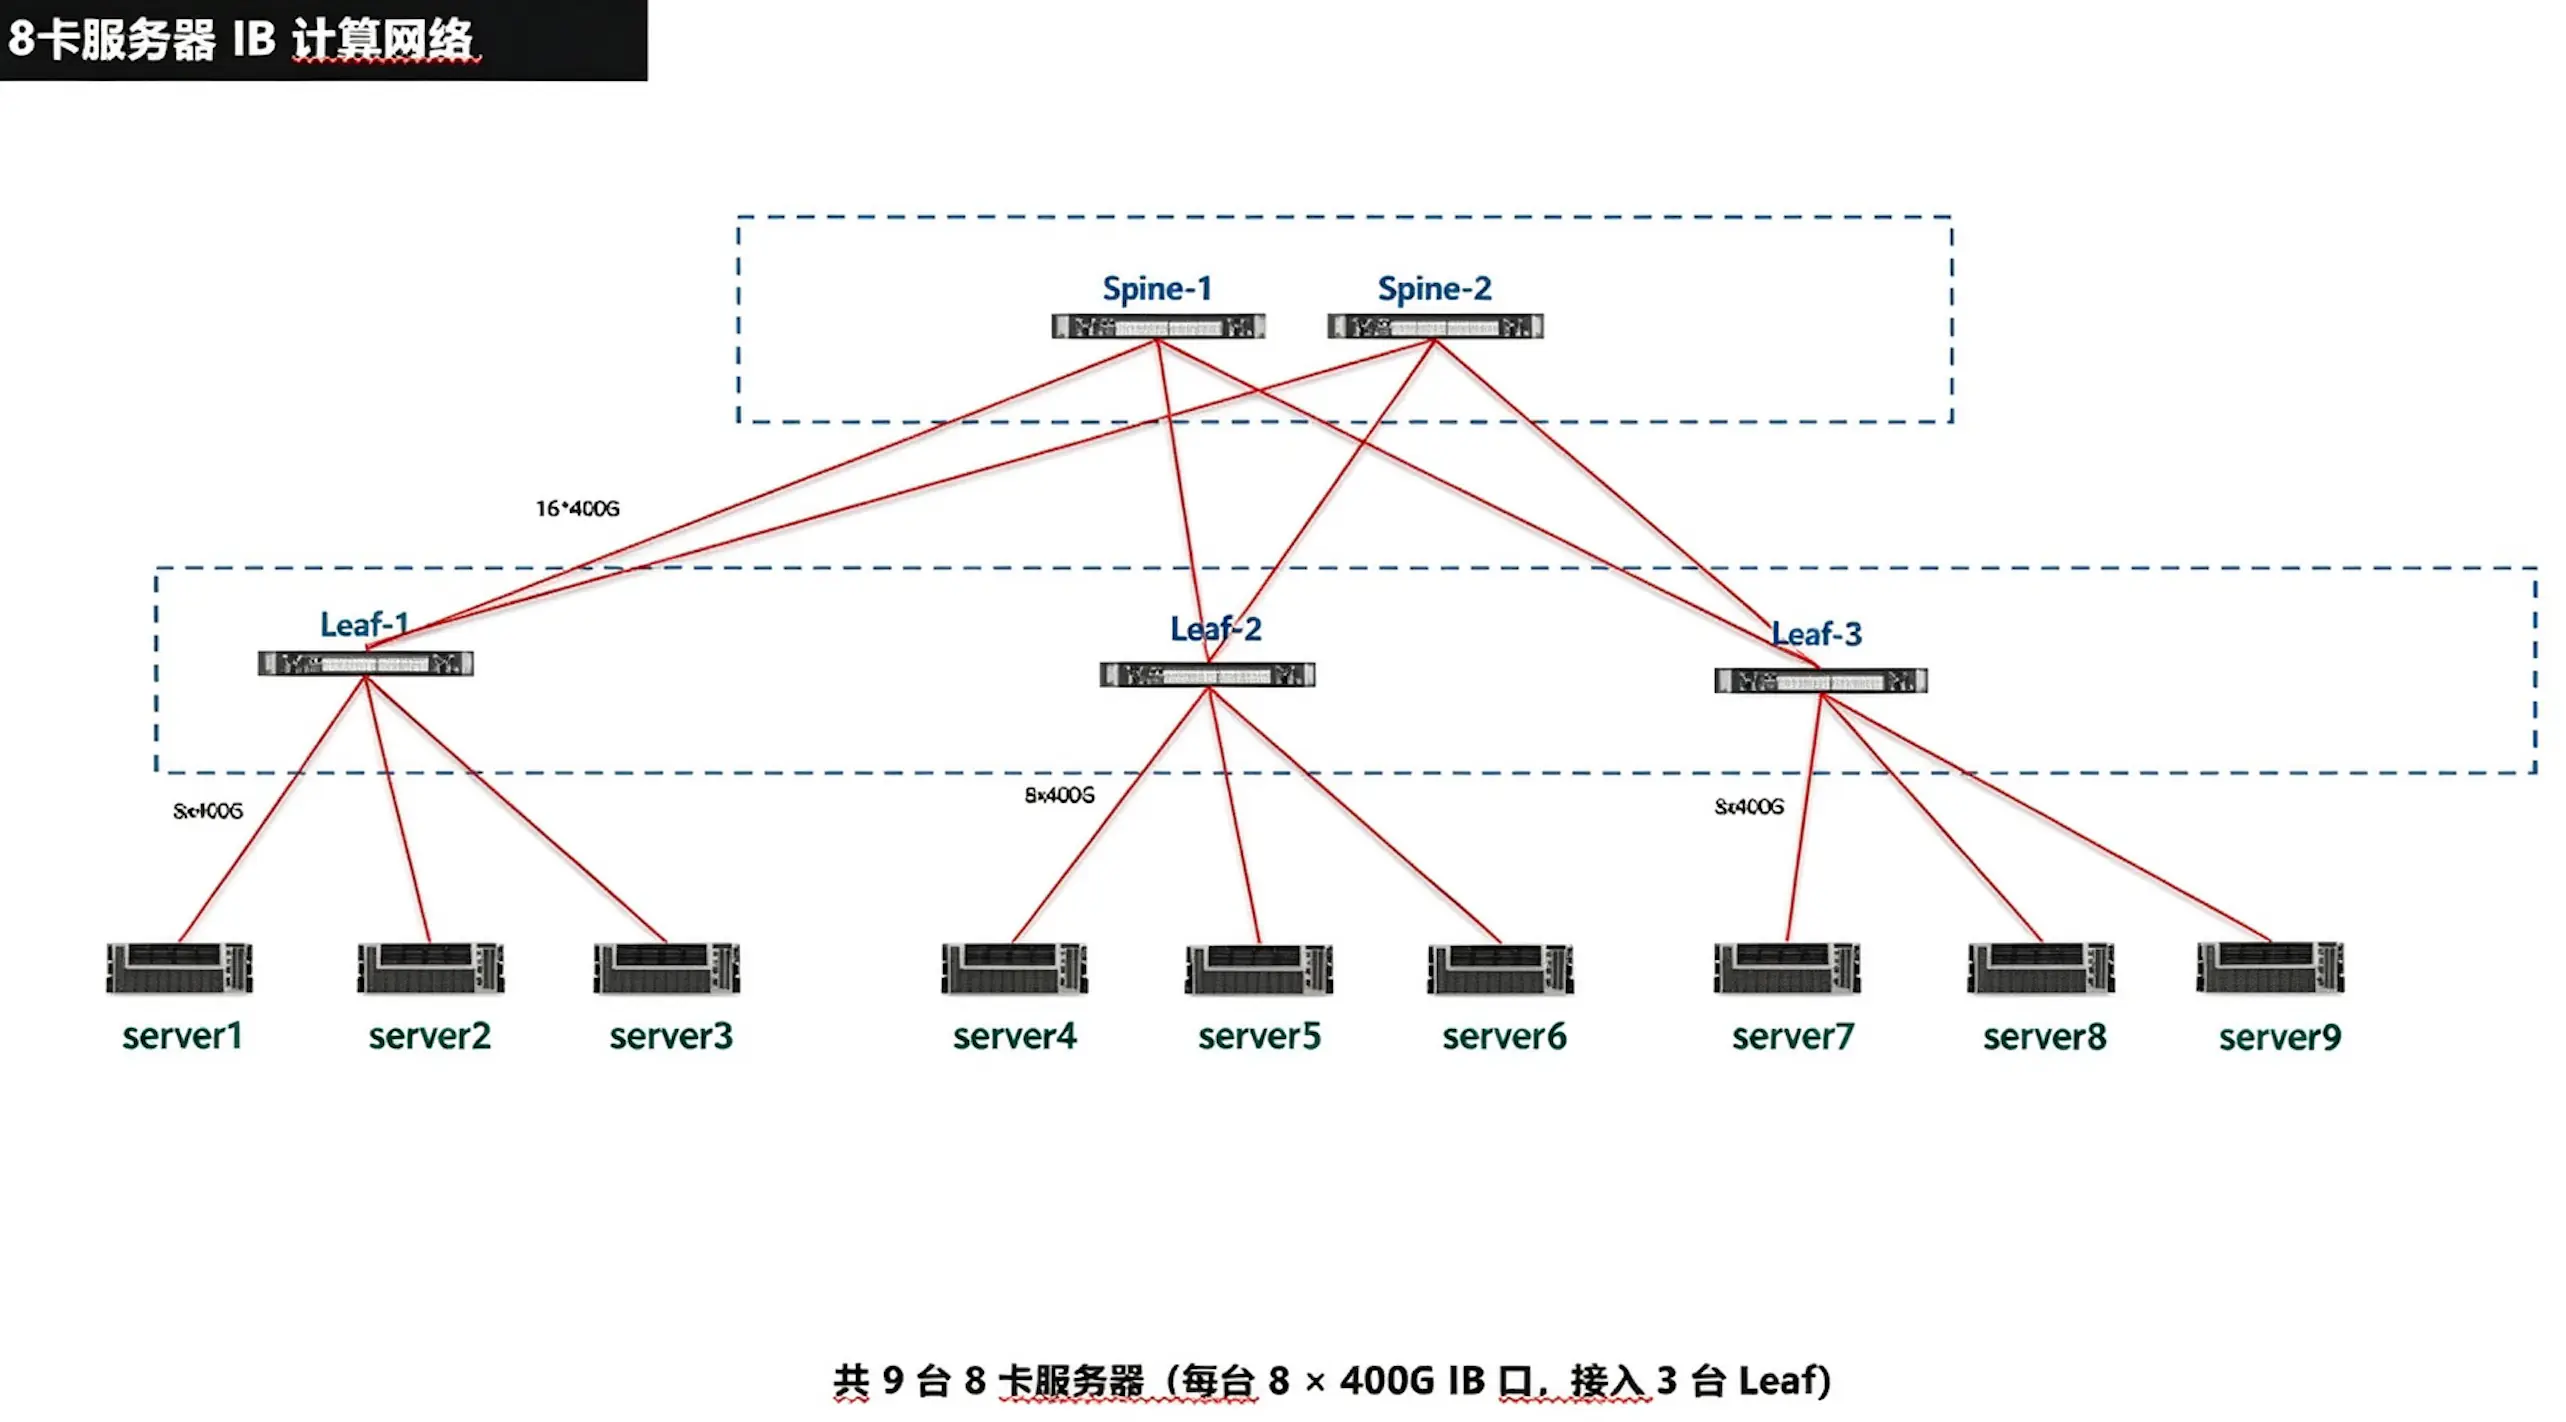
图:两层胖树 IB 网络拓扑(server-1 ~ server-9)
网络采用 2×Spine + 3×Leaf 两级胖树,每台服务器 8×400G IB 口接入 Leaf,每台 Leaf 上行 16×400G 口到 Spine,Leaf:Server = 1:1 无收敛。
- 单机 8 卡 8×8 全 NVSwitch 互联(NV18),56 对 P2P 全部 Enabled;单机 NCCL AllReduce 带宽达 480 GB/s,为单机 NVLink 互联公认满速标志。
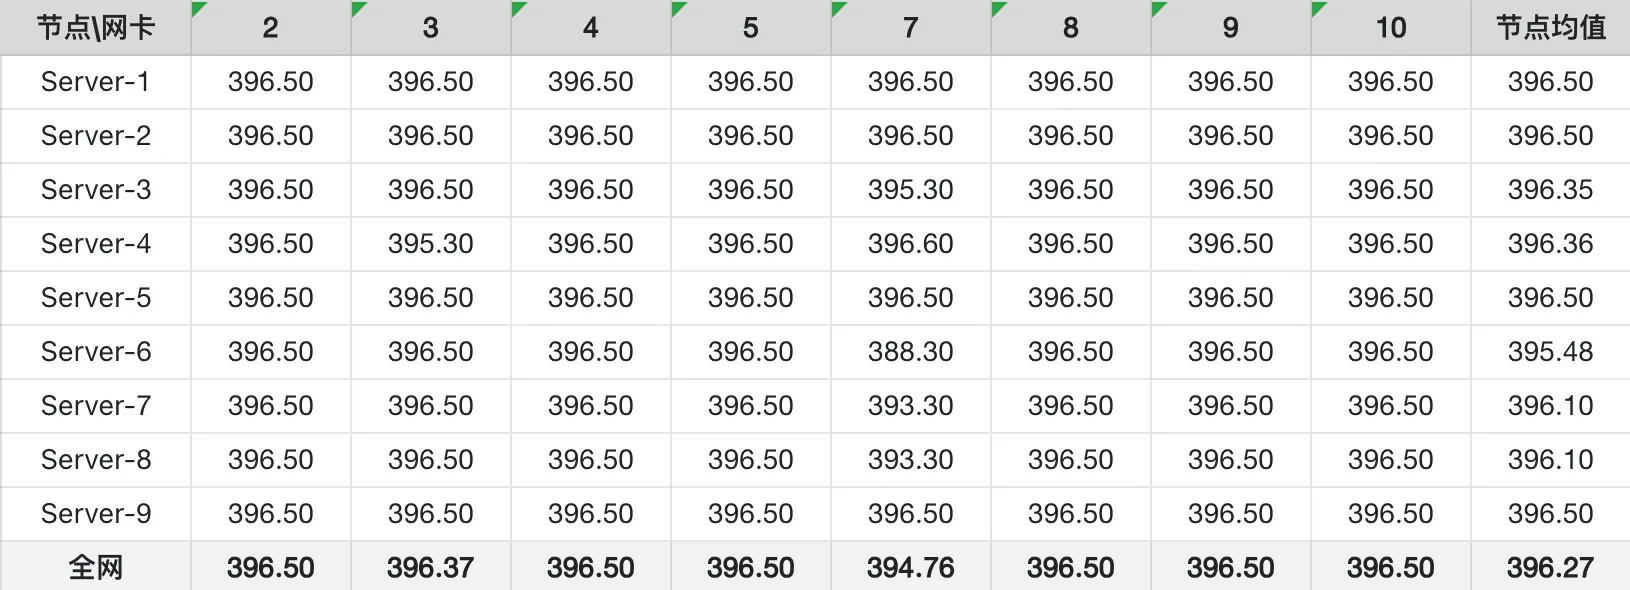
- 多机 InfiniBand 网络 72 条链路中 72 条跑满 396.5 Gbps(400G 线速的 99.1%),延迟 1.95–3.42 µs。
经过 CQIS 调优后,多机 NCCL AllReduce 总线带宽显著提升:32 卡 323.66 → 433.88 GB/s(+34%)、48 卡 319.57 → 439.14 GB/s(+37%)、64 卡 334.13 → 441.24 GB/s(+32%),大模型分布式训练的通信瓶颈被进一步压平。
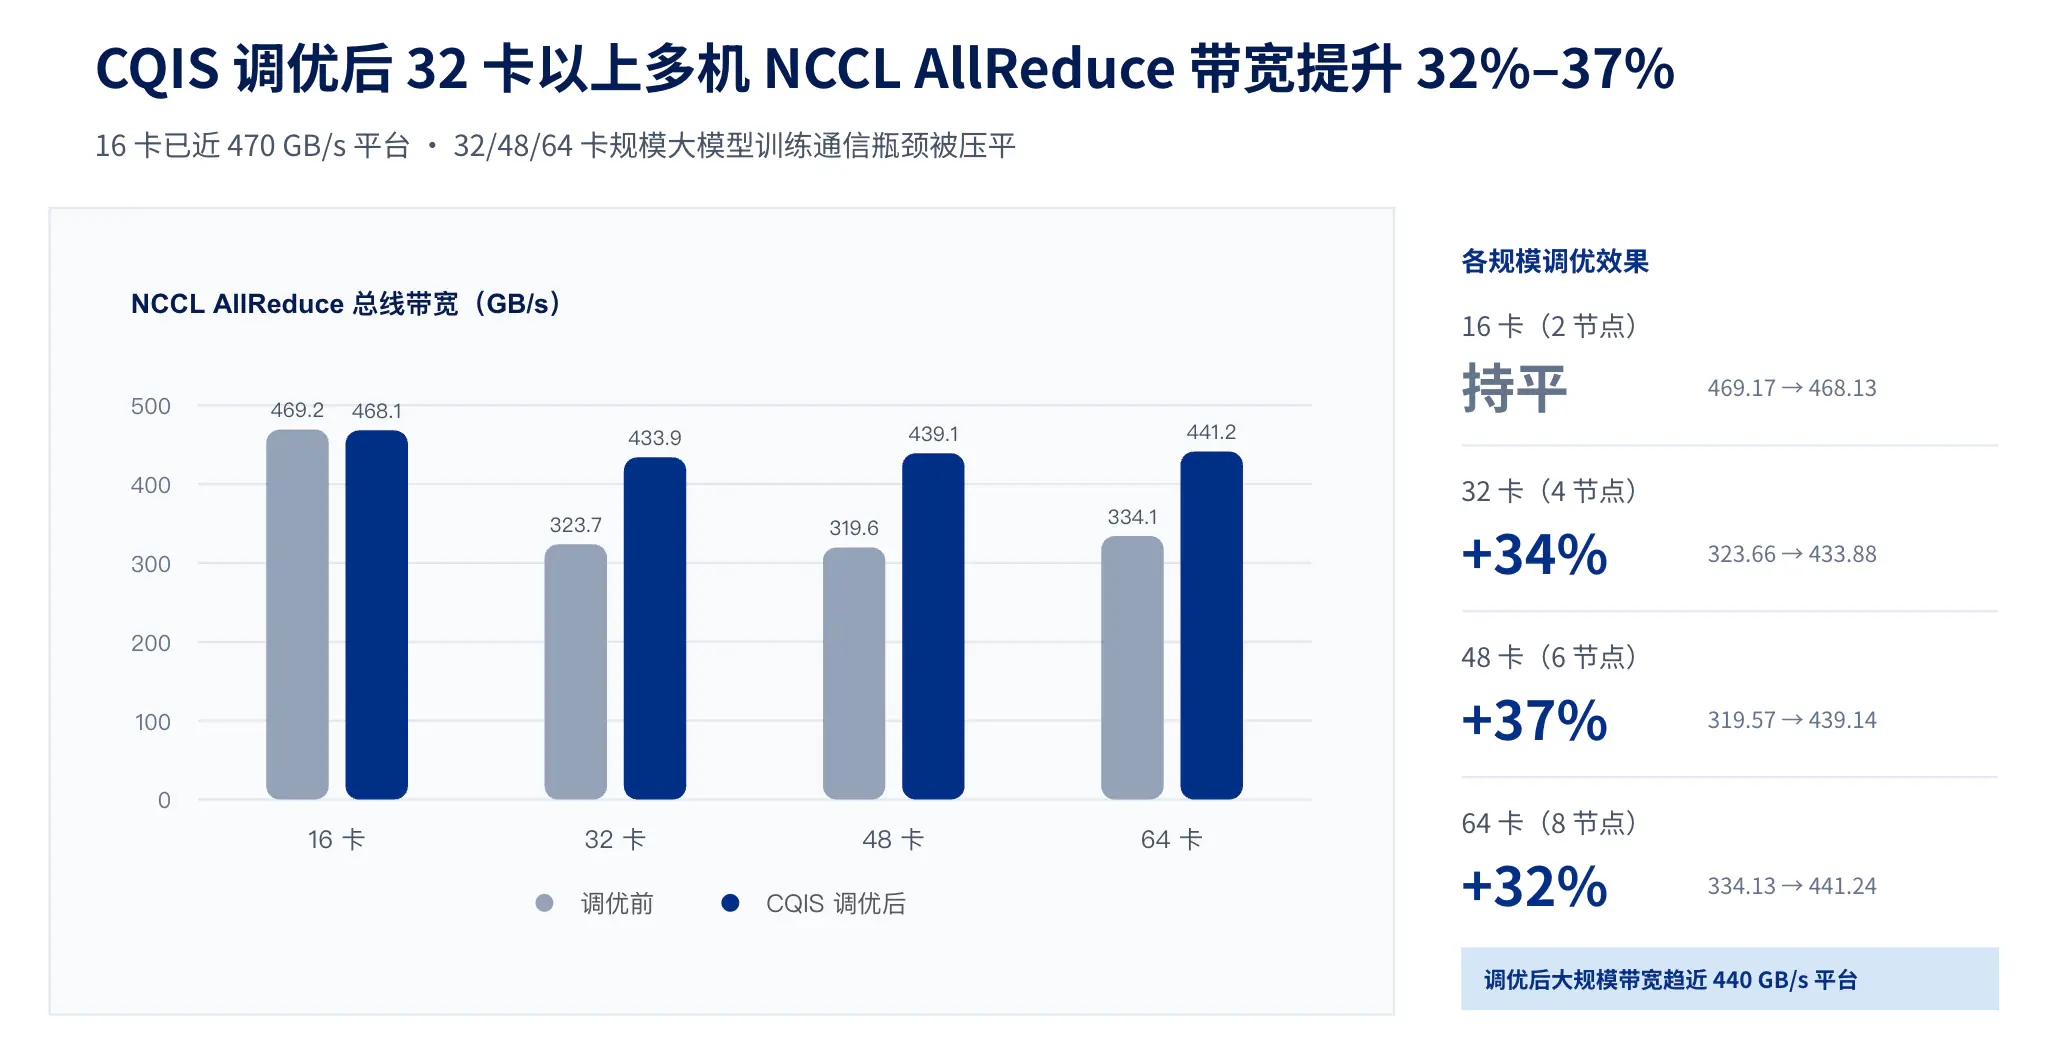
图:NCCL AllReduce 总线带宽 · 调优前 vs 调优后
3. 模型压测:6小时长稳运行,成功率 99.98%
在集群上以 TP=8、PP=3、DP=3 部署 vLLM 兼容推理服务,对 Qwen3-0.6B 进行 6 小时固定并发压测与 33 档并发扩展测试:
- 累计完成 186 万次请求,输出吞吐 88,248 tok/s,请求吞吐 86.18 req/s,成功率 99.98%。
- 短输入长输出场景峰值吞吐达 128,640 tok/s(并发 2048 仍未饱和)。
- 360 个时间窗口吞吐变异系数约 11%,长时运行平稳,未出现服务端故障。
这意味着:长飞光纤拿到的不是一堆"堆在一起的 GPU",而是一个经过严格验收、达到 NVLink 全互联与 400G IB 官方满速水平、可直接承载大模型训练与推理业务的生产级 AI 算力底座。
4. 平台中枢:AI Driver,把算力变成"可被业务调用的智能"
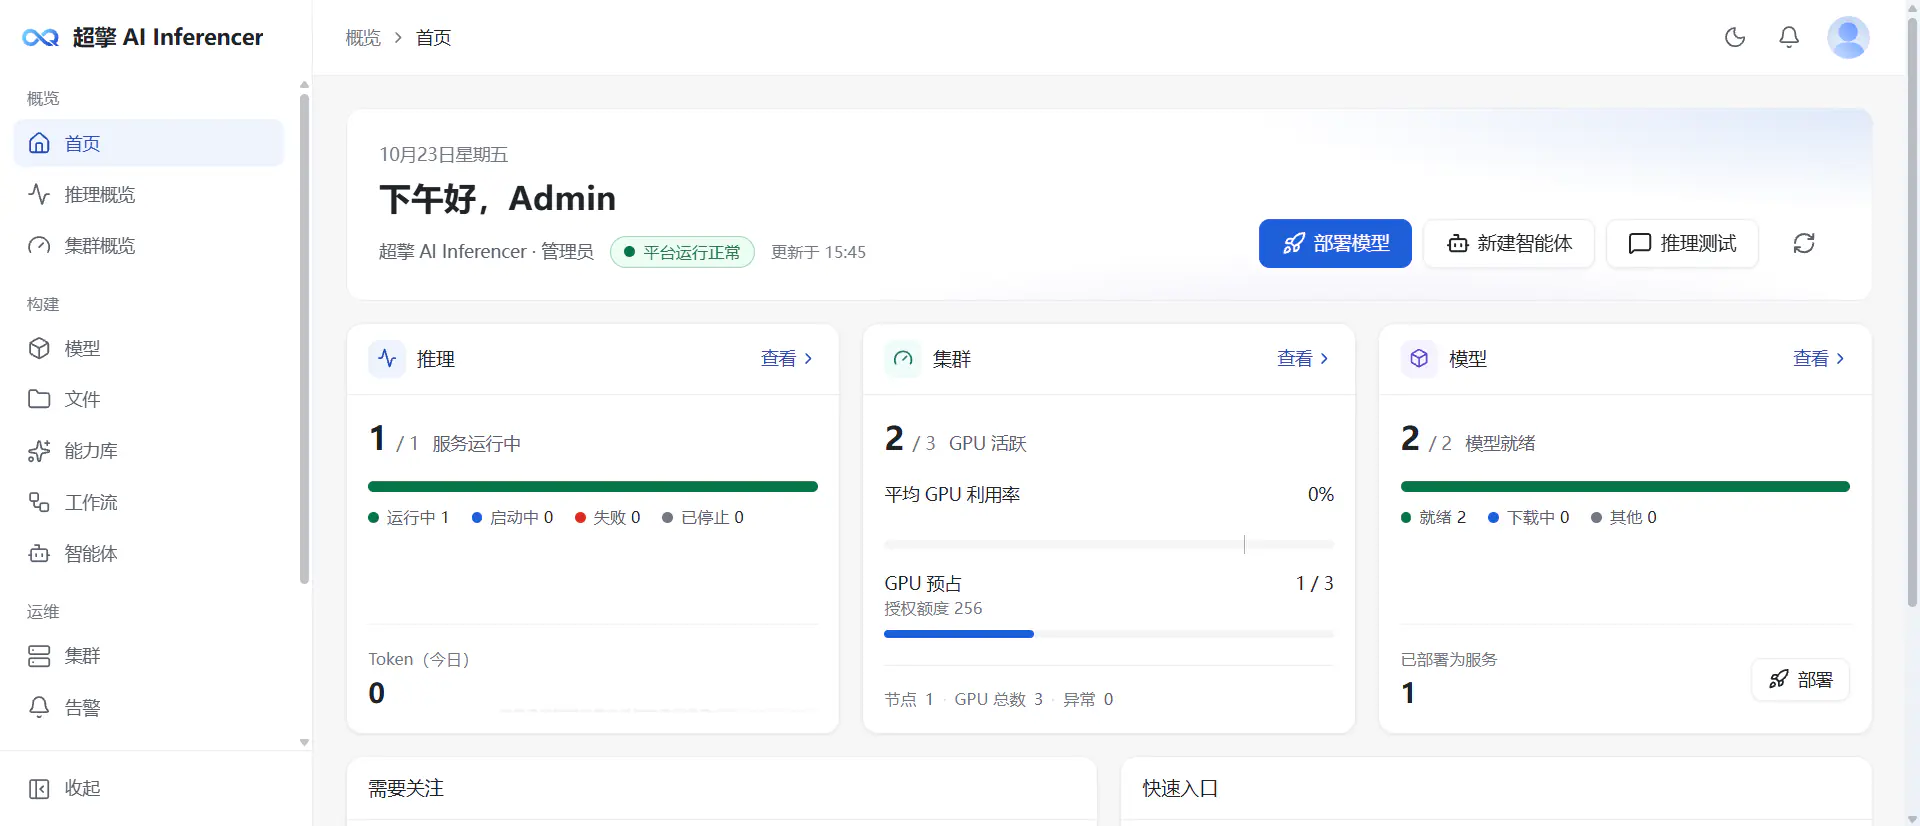
在坚实的硬件底座之上,项目部署了超擎数智自主研发的企业级 Agentic AI 平台——AI Driver。平台面向大模型私有化部署与智能应用建设,以六层全栈架构打通企业 AI 落地全链路:
- 基础设施层:GPU 节点接入、BMC 带外管理、健康监测——直接纳管本次交付的 72 卡 GPU 集群。
- 平台层:模型管理、推理服务、用户权限、日志任务与算力集群运维统一调度。
- 模型层:本地大模型、Embedding 模型与 OpenAI 兼容服务,支持主流模型仓库与本地模型导入。
- 能力层:RAG 检索、知识图谱(Graph RAG)、Skills、工具调用与文件操作。
- 智能体层:AI Agent、多轮任务、多 Agent 协作与可视化 Workflow 编排。
- 应用层:面向智能制造、知识助手、研发与运维助手等长飞真实业务场景。
5. 安全与业务执行闭环:安全沙箱 + 多 Agent 工作流
针对制造企业对数据合规与业务准确性的严苛要求,AI Driver 突破了传统"聊天框"模式。通过企业知识库 + 安全沙箱 + Skills/工具生态 + 多 Agent 工作流,让大模型从"回答问题"升级为"按企业规则完成一件具体工作"——检索企业知识库中的工艺文档、调用内部业务系统接口、分析生产数据、生成分析报告,全过程在隔离沙箱中留下完整的执行轨迹与文件变更记录,确保安全可控、有据可查。
四、交钥匙服务:CQIS 交钥匙工程,从需求规划到验收移交的全链路标准化交付
高规格 AI 集群从"采购设备"到"业务投产",中间横亘着十余个复杂工程环节。超擎数智依托标准化的CQIS(CHAOQING Infrastructure Service)交钥匙服务体系,组建1对1负责专属交付验收小组,为长飞光纤提供全周期工程保障。
1. 前期规划:让集群"按设计落地"
- 项目需求分析:深入沟通长飞业务需求,输出项目计划书、集群BOM、集群拓扑设计。
- 机房选址规划:从地理位置、电力供应、制冷、网络连接、安全性、可扩展性六个维度出具机房勘探建议书。
- 整网设计规划:输出BOM物料表、计算网/存储网/管理网三套拓扑图、设备落位图、机柜落位图、连线表与IP地址规划表。
- 项目管理规划:基于可视化项目管理工具,创建工作分解结构、里程碑、风险清单与质量标准。
2. 实施交付:让设备"按标准上线"
- 设备到货验货:设备签收、SN 对比、配置核对、完整性验货、规范上架。
- 机房布线管理:规范线缆标签、按标准扎线理线、点对点检查连通性。
- 全栈部署实施:机房布线、网络侧、GPU服务器侧、存储侧、集群安全侧、管理侧、软件侧七大方向统一部署。
3. 测试验收:让交付"可量化、可追溯"
- 整网网络性能测试、GPU集群性能测试、存储侧测试、AI软件测试、安全及可靠性测试五大类测试全部完成。
- 输出集群性能测试报告、验收报告与培训材料,确保长飞IT团队能够独立运维。
从"买设备"到"用集群",中间隔着规划、布线、部署、测试等十几个环节。CQIS把这些环节打包成标准化服务,长飞只需提出需求,其余全部由超擎数智交付团队负责。
五、项目验收:七大项测试一次性全部达标,以量化指标验证生产级品质
为彻底杜绝 AI 集群"只通电、不达标"的行业乱象,超擎数智为本次项目制定了覆盖整网网络性能、GPU 集群算力性能、存储侧性能、AI 软件功能及安全可靠性的五大类、七大项严苛验收标准。在为期一周的现场实测中,集群不仅一次性全部合格通过,更在生产级大模型压测中交出亮眼答卷。
1. 硬件与基础算力基准验证
通过全节点压力测试与浮点运算基准测试,验证 72 张 HBM3 加速卡在满载工况下的稳定性、显存带宽(3.2 TB/s)及 BF16/FP64 算力达成率(98% 理论峰值),确保底层算力无短板。
2. 单机与多机集合通信(NCCL)极限验证
对单机 NVLink 及跨机 400G InfiniBand 网络进行全尺寸消息集合通信测试,验证 72 条 IB 链路 99.1% 线速达成率,以及 32 卡、48 卡、64 卡规模下超 430–440 GB/s 的调优后总线带宽,确保分布式通信零阻塞。
3. 生产级大模型 6 小时长稳与高并发极限压测
为真实模拟工业生产环境的业务调用负载,验收团队在集群上以 TP=8、PP=3、DP=3 的分布式策略部署 vLLM 兼容推理服务,基于 Qwen3-0.6B 模型开展了长达 6 小时的固定并发长稳压测以及 33 档阶梯并发扩展测试:
- 高可靠海量吞吐:累计顺利完成 186 万次请求,平均输出吞吐高达 88,248 tokens/s,请求吞吐达 86.18 req/s,整体请求成功率高达 99.98%。
- 极限并发承载力:在短输入、长输出重载场景下,集群峰值输出吞吐突破 128,640 tokens/s,且在 2048 路高并发下仍未出现性能饱和。
- 长周期平稳运行:连续 360 个监测时间窗口内,吞吐变异系数稳定在约 11%,全程未发生任何服务端故障或掉线,充分验证了集群直接承载核心生产业务的工业级稳定性。
六、客户收益:从高性能算力底座到智能制造生产力引擎
1. 获得零故障、满速级的生产级 AI 算力底座
长飞光纤收获的不仅是一批高规格 GPU 硬件,而是一套经过深度调优、达到 NVLink 全互联与 400G IB 官方满速标准、通过 186 万次请求压测验证的高可用智算集群,可直接支撑大规模模型训练与高并发推理。
2. 实现"算力即服务(CaaS)",赋能多部门按需调用
72 卡 GPU 集群通过 AI Driver 平台完成统一池化与封装,对外提供标准化、OpenAI 兼容的高性能推理 API,使长飞内部各业务部门无需关注底层硬件复杂性即可按需获取智能算力。
3. 推动"流程即工作流",加速 AI 深入核心制造环节
借助 AI Driver 的多 Agent 协同与可视化 Workflow 编排能力,长飞光纤能够将复杂的质量判定、生产数据分析、报告自动生成及研发工艺辅助等业务沉淀为可复用的智能体工作流,真正让大模型承担具体生产任务。
4. 大幅缩短集群建设周期,降低工程与运维风险
超擎数智 CQIS 交钥匙服务将繁杂的规划、勘探、布线、调优与测试打包为标准化工程交付,不仅帮助长飞光纤实现了"一周一次性验收通过"的高效上线,也为后续集群扩容与长期运维建立了标准化基线。
5. 筑牢制造业私有化数据安全与合规底线
通过全栈私有化部署、多租户细粒度权限管控以及智能体安全隔离沙箱机制,确保长飞光纤核心工艺文档、研发数据与生产指令不出域、可审计、可追溯,全面满足高端制造业严苛的安全合规要求。
七、结语
长飞光纤 72 卡 GPU 集群的一次性满速验收与 AI Driver 平台的成功落地,清晰地印证了制造业智能化转型的核心逻辑:企业级 AI 建设绝不是简单采购几台服务器、部署一个开源聊天窗口,而是需要构建"坚实算力底座 + 智能体中枢平台 + 深度业务工作流"的三层协同体系。
在本项目中,超擎数智凭借业界领先的 CQIS 交钥匙集群工程交付能力、深厚的 InfiniBand 高速网络与 NCCL 调优经验,以及自研 AI Driver 企业级智能体平台,成功助力长飞光纤打通了从底层高性能算力到上层制造业务应用的完整闭环。
算力底座已经就位,智能平台已经跑通,业务场景正在逐一激活。未来,超擎数智将继续携手长飞光纤及更多行业领军企业,以全栈 AI 基础设施与工程化落地能力,持续驱动智能制造产业的高质量跃升。