高效、耐用、可互换:NVIDIA AI 工厂如何实现投资回报最大化
AI 工厂每兆瓦造价约 6000 万美元,靠什么回本?NVIDIA 用高效、耐用、可互换三个词给出答案,并以 Vera Rubin NVL72、A100 与 GB300 NVL72 的第三方数据逐项验证。
AI 工厂按兆瓦建设,甚至按吉瓦建设。每兆瓦的造价约为 6000 万美元,运营商只有在看清投资回报之后,才会投入这个量级的资本。决定 AI 工厂回报的关键因素有三个:
- 创收能力(Earning capacity):如果工厂把产出的每一个 Token 全部售出,一年能获得多少收入。
- 有效寿命(Useful life):AI 硬件能够持续创造收益的时间。
- 需求(Demand):这些 Token 的市场需求有多大。
三者之间无法相互替代。创收能力再强,若只能卖出部分产能,意义有限;需求再旺盛,若一年后便无法满负荷运行,同样无从兑现。三者也不彼此独立:能承载更多类型负载的工厂,自然能触达更多需求,从而年复一年持续创收。
NVIDIA AI 工厂的设计目标,是让这三项同时达到最优:
-
高效(Productive):每兆瓦吞吐最高、单位 Token 成本最低,从而最大化创收能力。
-
耐用(Durable):GPU 与系统在交付多年后仍能持续创收,延长有效寿命。
-
可互换(Fungible):同一套算力可被各类 AI 负载互换使用——覆盖所有阶段与所有场景——也能承载大量与 AI 无关的负载,从而同时拓宽并加深可服务的需求。
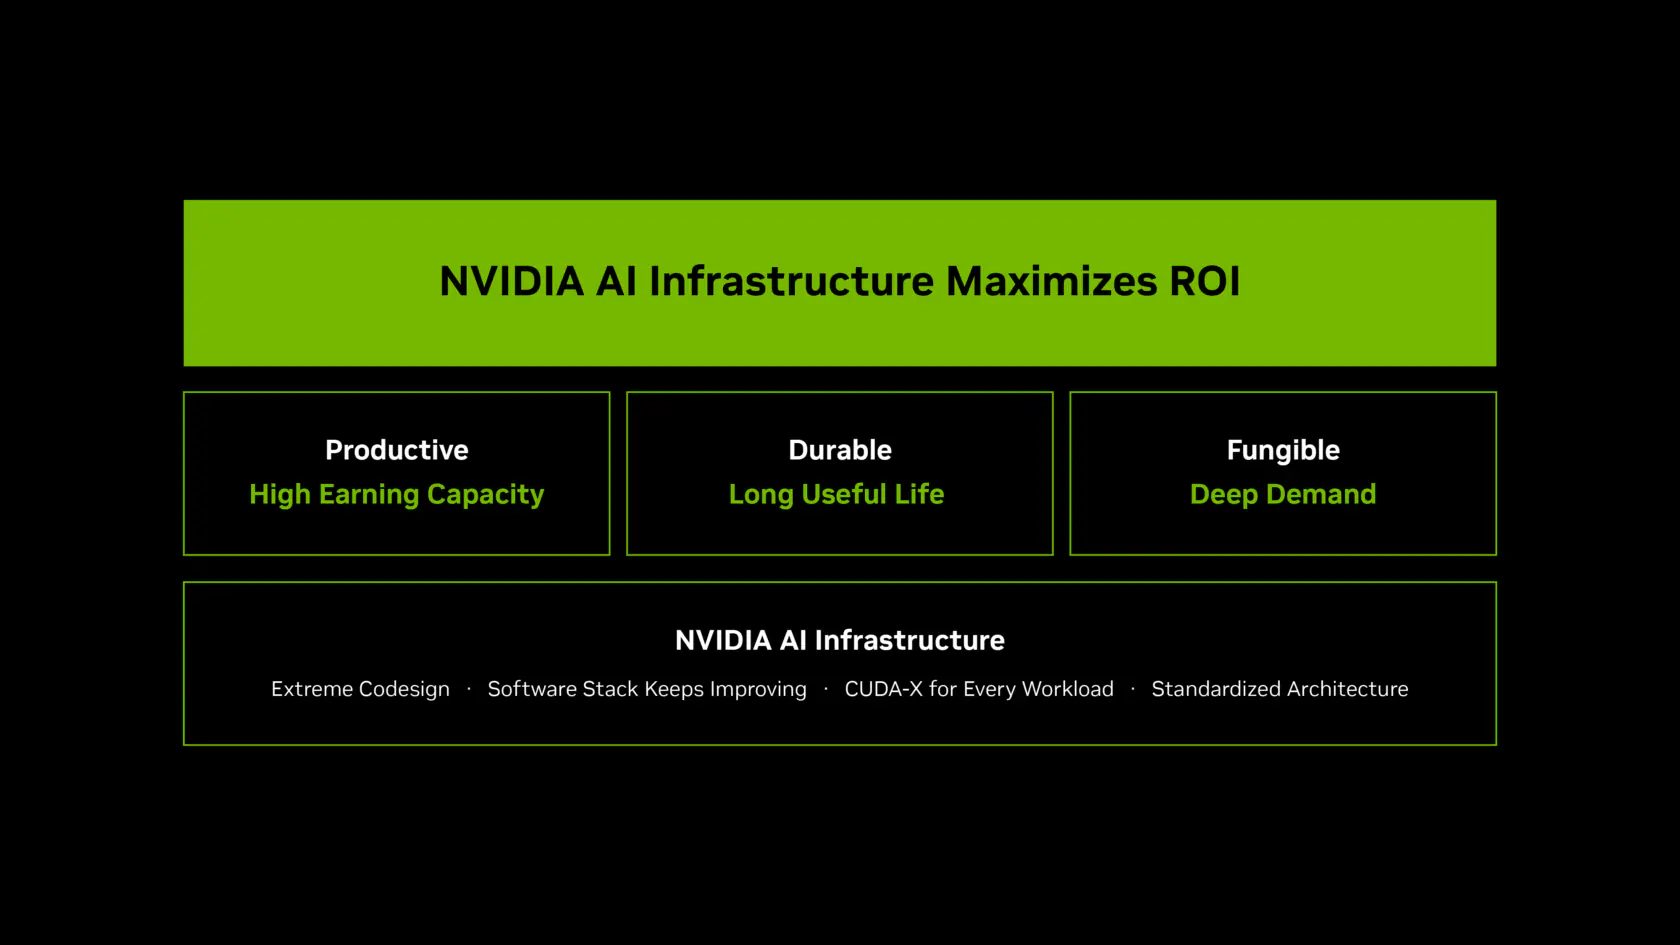
NVIDIA 平台兼具高效、耐用与可互换三重特性,从而最大化 AI 工厂的回报。
全栈的工程协同设计(codesign)最大化了 AI 工厂的吞吐;持续的软件优化,则让已交付的硬件在数年之后依然保持产出能力。NVIDIA CUDA-X 库使工厂能够运行任何加速计算负载;标准化的架构进一步让这一切对任何运营商都可及——基于经验证的参考设计即可完成部署。
一、高效:每兆瓦 Token 吞吐最高,单位 Token 成本最低
电力是 AI 工厂的刚性约束。因此,“每兆瓦每秒 Token 数”成为决定创收能力的核心指标:在固定功耗范围内产出更多 Token,收入就更高;单位 Token 成本更低,利润空间就更大。
SemiAnalysis AgentX的数据显示,NVIDIA Vera Rubin NVL72 系统的每兆瓦吞吐量达到 NVIDIA GB300 NVL72 的 30 倍以上;在 DeepSeek V4 Pro 模型上,每百万 Token 成本最低可降至后者的 1/45。这样的量级提升,源于全栈的极致协同设计:从模型与负载,向下贯穿软件,直至计算、网络与内存,所有环节被放在一起优化。
SemiAnalysis AgentX 对 NVIDIA GB300 NVL72 运行 GLM 5.3 的性能分析。
由此引出两个问题。如果每一代产品都让 Token 大幅降价,算力需求会随之萎缩吗?
不会,需求会扩张。
Token 变便宜,会让更多用例具备经济性;而这些新增用例消耗的 Token,远超过效率提升所节省的部分。
第二个问题关乎耐用性:如果每一代性能都远超上一代,老一代产品会怎样?
二、耐用:存量设备持续创造收益
并非所有负载都需要最新系统。适配与否,取决于负载的复杂度与形态——这正是上一代产品在下一代上市后仍能持续创收的原因。
2020 年出货的 NVIDIA A100 GPU,六年后仍在商用,持续证明其经济价值;CoreWeave 近期将 2020 年首批投放机型的预订期延长至 2029 年。多年来,主流运营商都在延长服务器的折旧年限——这本质上是对“硬件何时停止盈利”的预估,而这个时间点正不断后移。Sprout 于 2026 年 9 月发布的分析《数据中心 GPU 的有效寿命》,梳理了各主要运营商折旧年限的调整轨迹。
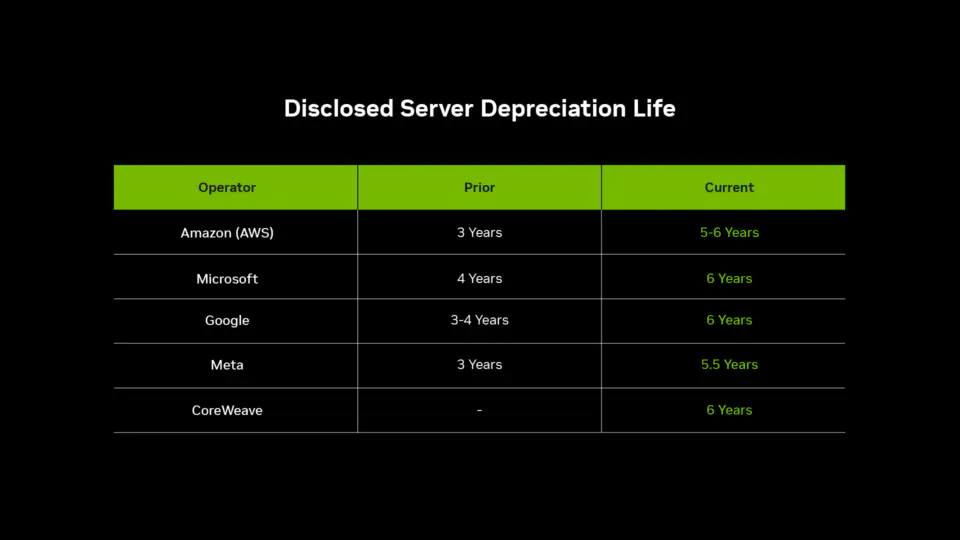
主流运营商均在延长服务器使用寿命。来源:Sprout《数据中心 GPU 的有效寿命》,2026 年 9 月。数据由 Sprout 依据企业披露与媒体报道整理。会计折旧年限是物理寿命的保守参照——微软的 NVIDIA V100 集群实际运行 8.4 年,而账面折旧年限为 6 年。
Barkr依据二手转售价格测算,八卡 H100 系统的有效寿命为 5 至 6 年,GB300 NVL72 则为 9 至 10 年。Silicon Data的数据显示,一块服役六年的 A100 仍保有原价的四分之一,而按五年折旧计算,它在一年多前就应归零。Ornn Data发现,市场为五年期合约租用 A100 支付的价格,仍达到一个月期合约的 80%。
用于为 GPU 编程的软件平台 CUDA 可跨代运行,因此新架构到来时,运营商已有的设备不会陷于搁浅。持续的软件与内核优化,则不断抬升现有硬件的性能上限。
同一平台先后承载了机器学习、深度学习、生成式 AI、推理、智能体 AI 与物理 AI。每一类新工作出现时,落地的都是已经部署好的硬件。
这就是可互换性:系统能承接的工作种类越多,找到用武之地的时间就越长。
三、可互换:各类 AI,所有阶段,所有场景
只为单一工作负载而建的工厂,本质上是在押注这类需求长期不变。而能运行多种负载的工厂,即便业务形态改变,依然有用、依然创收。
NVIDIA AI 工厂可运行各类 AI 模型——无论开源还是闭源——覆盖语言、视觉、生物、物理与机器人等领域;覆盖从数据处理、预训练、后训练到推理的每个阶段;也覆盖从超大规模云、AI 云到主权 AI 项目、企业数据中心与边缘的各类场景。
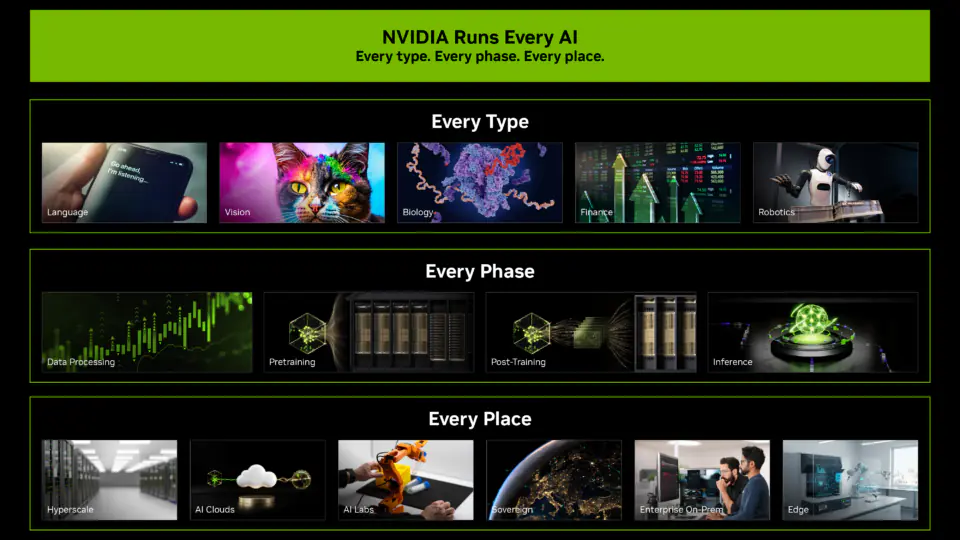
NVIDIA 平台具备可互换性,可在所有阶段与场景运行各类 AI 负载。
这其中并不只有 AI 模型的构建与运行。同一套基础设施同样承载数据处理、科学计算、仿真、图形等任务。
这些负载无论是否属于 AI,最终都归约为同一类并行数学运算,而 NVIDIA GPU 正是为在数千个核心上并行执行这类运算而设计。一块芯片之所以既能模拟光线、折叠蛋白质,又能预测下一个 Token,原因就在 CUDA。其上是超过 1000 个开箱即用的 CUDA-X 库与模型,覆盖深度神经网络、计算光刻、量子电路模拟,直至向量检索与气候建模,并有超过 1000 万开发者在其上构建。
这正是 NVIDIA GPU 属于通用加速计算、而非为单一负载定制的 ASIC 的原因。可互换不等于泛化:Tensor Core 与 Transformer 引擎把面向 AI 优化的硬件置于可编程架构之中,让同一块芯片兼具专用性与灵活性。以一套架构承载全部负载,是维持高利用率、进而维持回报的关键。
这种可互换性体现在客户的生产环境中:
-
礼来(Lilly) :在 1016 张 GPU 的本地集群上构建并运行蛋白质、小分子与基因组模型,同时为内部团队提供聊天机器人与智能体工作流。
-
Pinterest :在超大规模云上完成视觉语言模型的后训练与部署,规模达 14000 张 GPU,横跨 NVIDIA Blackwell、Hopper 及更早架构。
-
Revolut :以 NVIDIA cuDF 处理数十亿条交易记录,随后在 AI 云上训练并部署基础模型。
-
Runway :在 NVIDIA Hopper 上训练世界模型,并通过云基础设施在 NVIDIA Blackwell 平台提供推理服务。
-
德克萨斯农工大学(Texas A&M University):在超级计算机上运行分子模拟与 AI 药物研发,在 26 个项目、7 家机构间维持 95%—98% 的利用率。
AI 之外同样如此。Cosm运营由 NVIDIA 驱动的分布式数据中心,为高分辨率视频播放、流媒体、实时图形与同步显示提供弹性算力。达索系统(Dassault Systèmes)以虚拟孪生仿真支撑威奇托州立大学的飞机认证与 Lucid Motors 的车辆设计。联合利华(Unilever)则以数字孪生生成产品图像,取代实景拍摄,将制作成本降低一半。
这样的案例无法穷举——而这恰恰是重点。
NVIDIA AI 工厂被设计为高效、耐用且可互换:更高的 Token 利润、更长的有效寿命、更深层的需求。这正是投资回报最大化的根源。