NVIDIA Blackwell 在首个智能体 AI 基础设施基准中领跑
业界首个智能体 AI 基准 AgentPerf 首轮结果:以 DeepSeek V4 Pro 测试,NVIDIA GB300 NVL72 每兆瓦可运行的智能体数量最高为 HGX H200 的 20 倍;工具调用以 CPU 时间模拟。
Artificial Analysis 公布的全新 AgentPerf 结果显示,加速计算系统应对真实智能体负载的能力究竟如何——其中 NVIDIA GB300 NVL72 每兆瓦可运行的智能体数量最高为 NVIDIA Hopper 的 20 倍。*
作为业界首个智能体 AI 基准测试,Artificial Analysis 推出的 AgentPerf 让开发者、企业与基础设施提供商有了一套明确的办法,用来比较不同系统在智能体 AI 上的表现。在首批公布的结果中,NVIDIA Blackwell Ultra NVL72 平台在所测的各个智能体 AI 负载上均取得领先性能,每兆瓦可运行的智能体数量为 NVIDIA Hopper 的 20 倍。
智能体 AI 与对话式 AI 是本质不同的两类负载。一次对话补全更像短跑:调用一次大语言模型(LLM),拿到一次回复。智能体则更接近接力:它把一个目标拆成许多步,直到任务完成才停下。
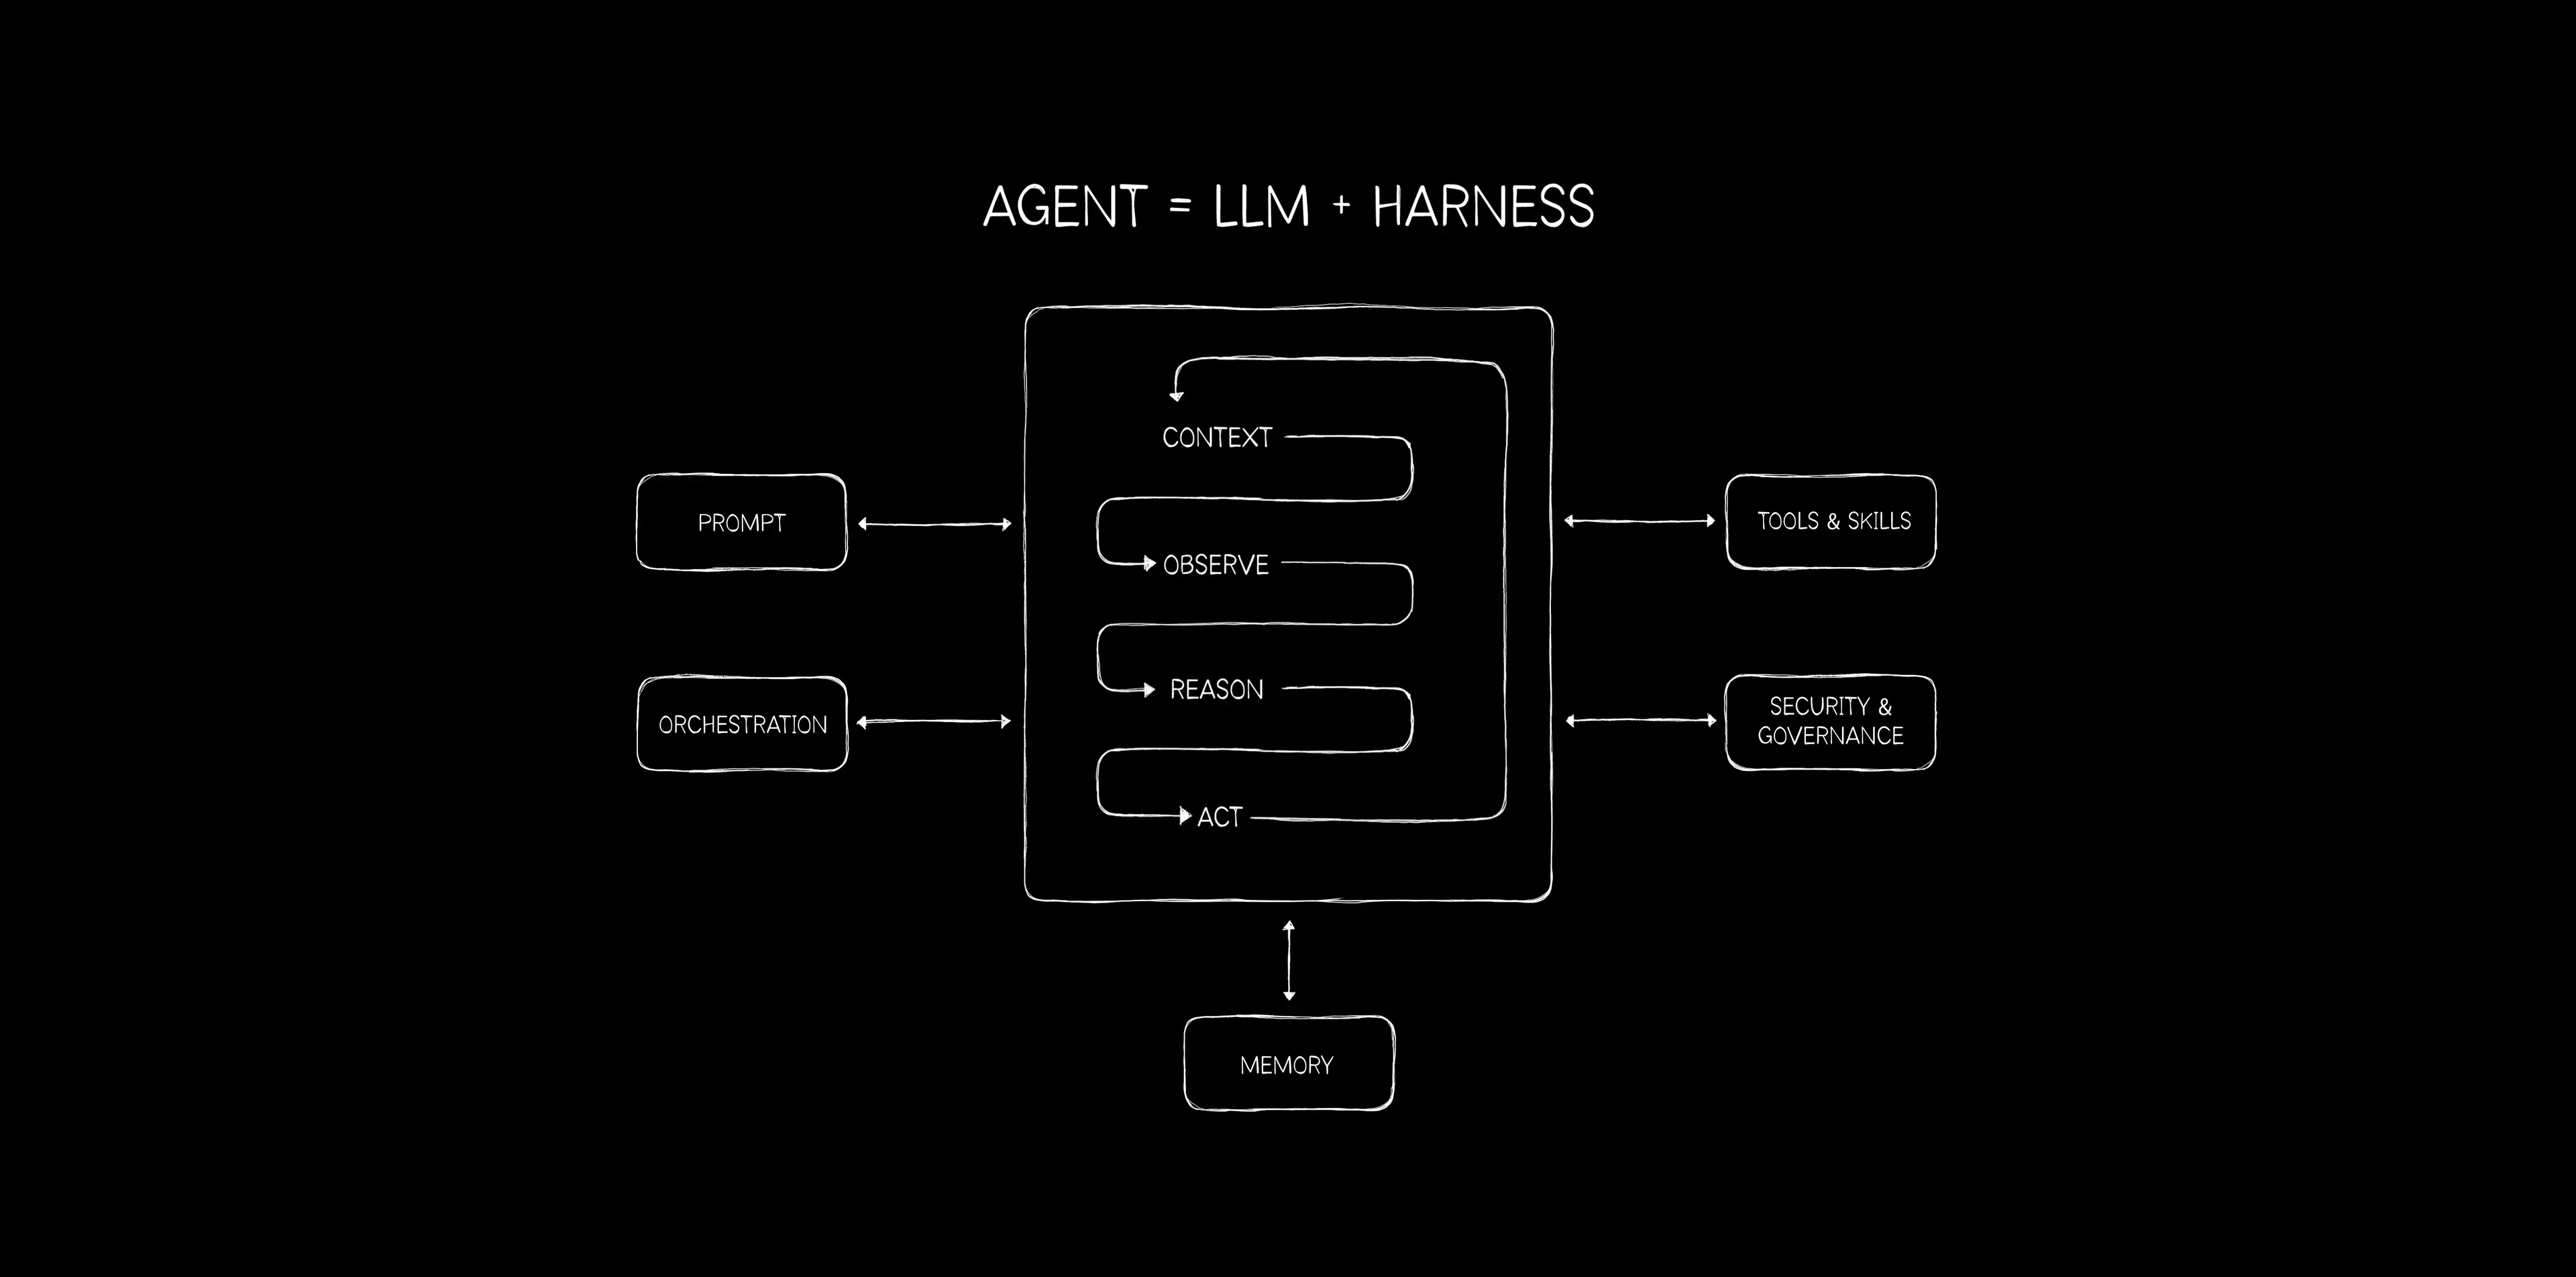
为了取上下文、观察、推理、执行,智能体会把多次 LLM 调用与工具调用串接起来。于是一条链上会累积几十到上百次 LLM 调用,每一次都把不断变长的上下文传给下一环,而每一次交接都伴随代码编译与执行、数据库检索、网页浏览之类的工具调用。这种复杂度不是逐项相加,而是成倍放大。
这一区别对性能测量至关重要。现有的 AI 推理基准测的是一次 LLM 调用——模型响应单个请求有多快,系统能同时处理多少请求。它们并非为智能体负载而设计;在智能体负载里,链式的 LLM 调用、工具调用的等待、不断增长的上下文,对加速计算系统的施压方式与单次调用完全不同。
对大规模构建和部署智能体的企业来说,有三件事必须搞清楚:智能体的响应有多快、能同时部署多少个、以及每一美元、每一瓦投入究竟能换来多少有效工作量。
NVIDIA GB300 NVL72 每兆瓦运行的智能体多 20 倍
本轮测试中,AgentPerf 采用 DeepSeek V4 Pro 衡量智能体性能。这是一款大型混合专家(MoE)模型,代表当下最强智能体所依托的那一类前沿模型。在该负载上,NVIDIA GB300 NVL72 取得本次基准的最高性能,每兆瓦可运行的智能体数量最高为 NVIDIA HGX H200 系统的 20 倍。
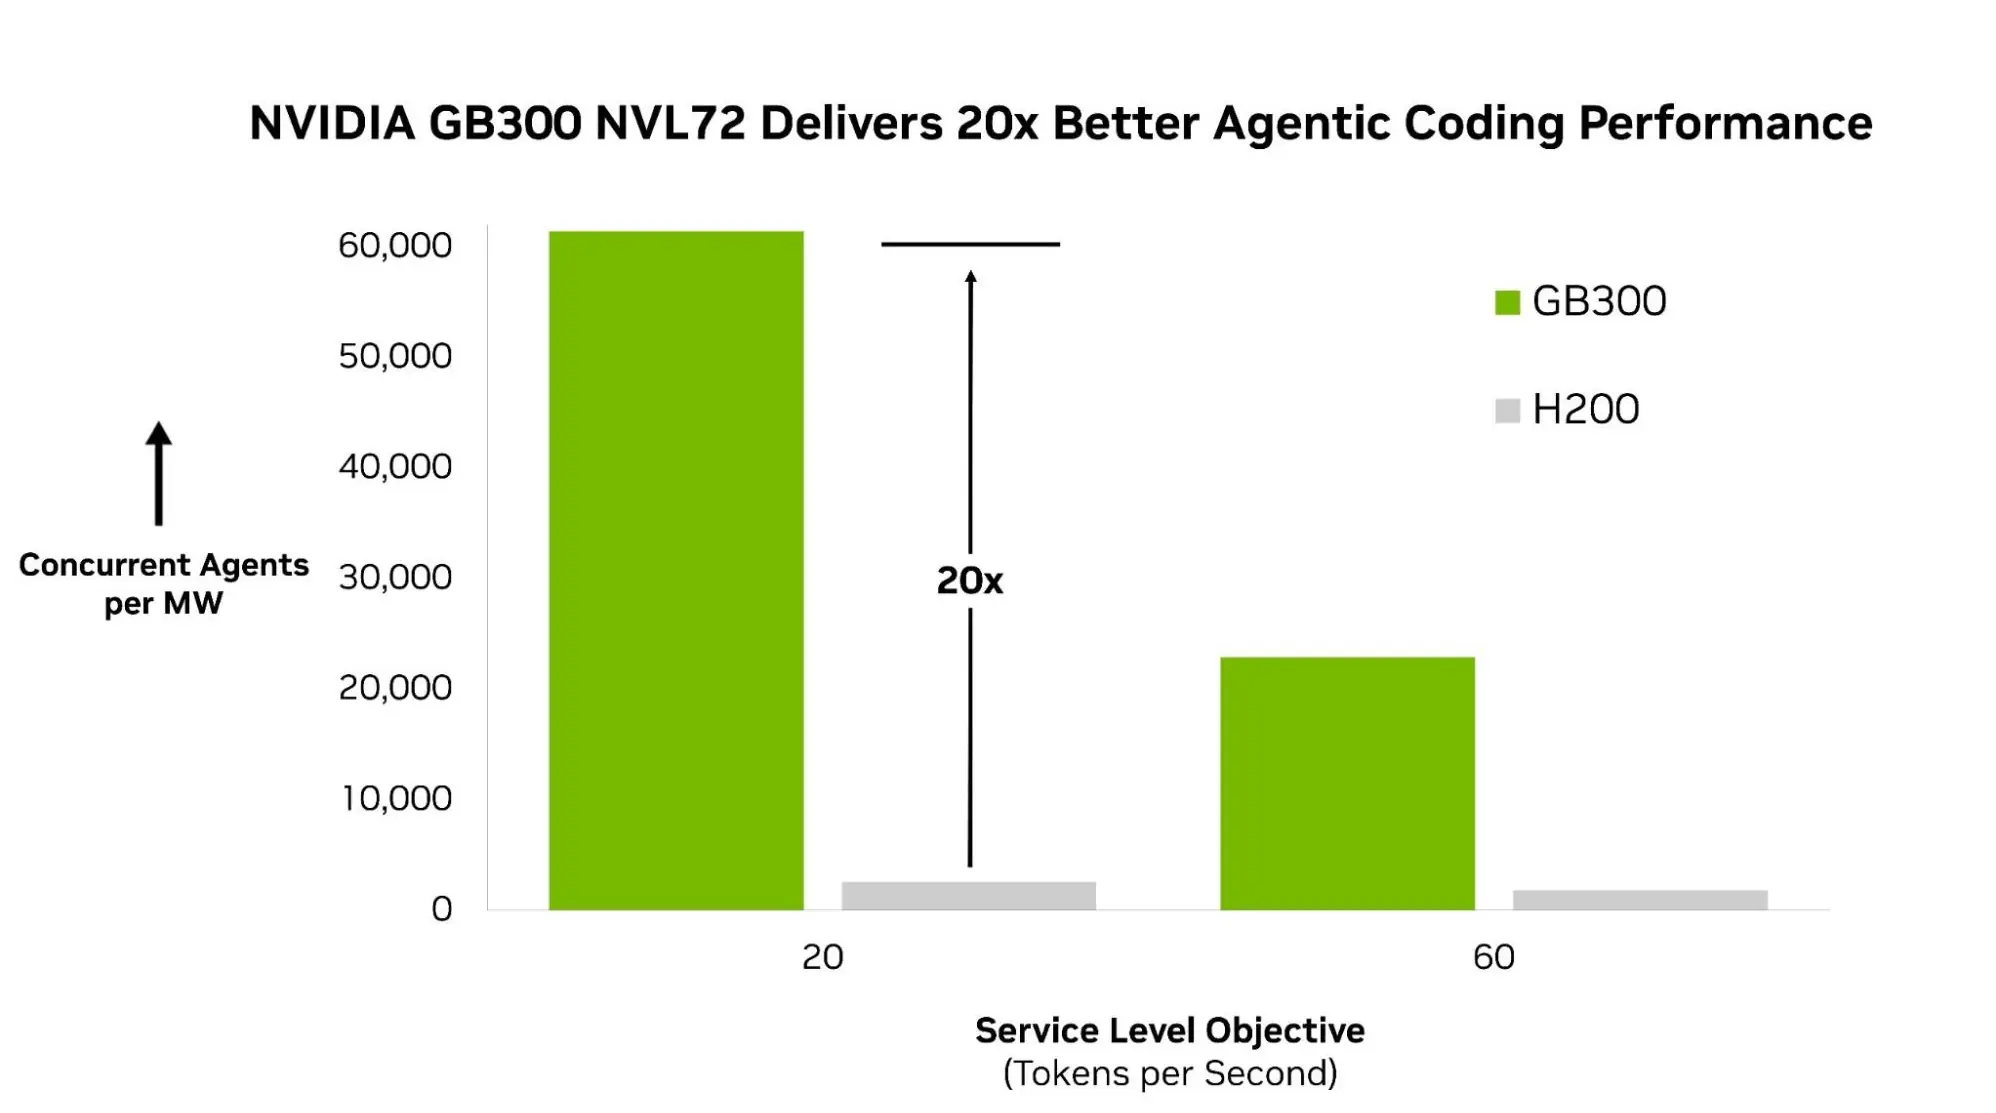
无论以每智能体每秒 20 个 Token 还是 60 个 Token 作为服务等级目标(SLO),NVIDIA GB300 NVL72 每兆瓦支持的并发智能体数量都远高于 NVIDIA H200。
性能优势来自全栈的极致协同设计。GB300 NVL72 把 72 张 GPU 连接成一台机架级系统,让 DeepSeek V4 Pro 这类大型 MoE 模型能够在大规模下高效地分布模型执行。
CUDA 内核在此基础上再进一步:它让通信与计算相互重叠,跨专家协调的代价因此被吸收掉,而不是叠加到时延上。
随着并发智能体会话规模扩大,NVIDIA TensorRT LLM 依然能守住效率。举例来说,它把输入处理与输出生成分开,两者可以各自独立优化。
这些结果依托于一套从零搭建的基准方法——它要还原的正是智能体 AI 在生产环境中的真实运行方式。
Artificial Analysis AgentPerf:基于真实智能体负载搭建
AgentPerf 以真实的编码智能体轨迹为依据:智能体接到任务,读取文件,编写与修改代码,执行命令,再根据执行结果反复迭代——这些轨迹全部取自真实的公开代码仓库,覆盖 12 种以上编程语言。其长上下文序列、工具调用模式与等待时间,都来自真实的编码工作流。
在此基础上,AgentPerf 衡量的是:在满足既定响应速度与输出 Token 速率阈值的前提下,一个平台能同时支撑多少个这样的智能体任务。工具调用本身并不实际执行,而是以具有代表性的 CPU 处理时间来模拟——这样,结果差异只反映加速计算的性能。
这些结果可以直接落到基础设施决策上:每张加速卡、每兆瓦电力能跑多少个并发智能体任务。对大规模部署 AI 智能体的企业而言,正是这些数字决定了既定基础设施投资实际能产出多少有效工作量。
NVIDIA 生态伙伴发挥 Blackwell 的领先性能
Baseten、DeepInfra 与 Together AI 等领先推理服务商,已经在 NVIDIA Blackwell 上为 DeepSeek V4 Pro 这类前沿模型提供智能体负载服务,并把智能体应用推入生产。
Together AI 在 NVIDIA Blackwell 上为 Cursor 提供实时推理。Cursor 是一款 AI 驱动的智能体编码平台,它的智能体负责排查问题、生成功能、执行重构,而开发者可以继续手头的工作。
DeepInfra 为 Pam.ai 提供动力。Pam.ai 是一款面向汽车经销商的 AI 劳动力平台,在上面部署的智能体负责预约服务、接听来电、开展外呼销售活动,全部运行在 NVIDIA Blackwell 上。
随着 NVIDIA 与开源生态持续优化推理软件,智能体负载上的性能与效率只会越来越好。NVIDIA Vera Rubin 架构现已全面投产,将带来下一代基础设施容量,以承接智能体 AI 在大规模上的增长需求。