OCP 全球峰会:在生态系统广泛采用之际,NVIDIA 开放 Vera Rubin 架构,助力全球 AI 工厂规模化
NVIDIA 在 OCP 全球峰会开放 Vera Rubin 架构:MGX 1.2 机架规范、DSX OS 开源组件、AI 工厂设计标准、800VDC 供电与 USFP 光模块等六项发布集中落地。
当 AI 工厂的规模从兆瓦级迈向吉瓦级,建设它们所需的已不只是先进的计算能力。开放标准正在帮助整个行业以更快的速度、更高的效率与更强的可靠性扩展 AI 基础设施。
在圣何塞 McEnery 会议中心举行的开放计算项目(Open Compute Project,OCP)全球峰会上,NVIDIA 宣布了一系列新的合作与技术贡献,目标是共同为下一代 AI 基础设施建立通用基础。
NVIDIA 通过开放的 NVIDIA MGX 架构,向 OCP 贡献了 NVIDIA Vera Rubin 机架与计算托盘(compute tray)的关键设计,为系统集成商开发下一代 AI 工厂基础设施提供了通用基础。
这些工作合起来,覆盖 AI 工厂本体、为其供电的公用电网,以及处于现代加速计算核心位置的机架级架构。
一、NVIDIA 与合作伙伴公布开放架构进展
在本次 OCP 活动上,NVIDIA 与合作伙伴发布了以下消息:
-
NVIDIA 与超大规模云服务商联合发布面向下一代 AI 工厂的开放标准,涵盖 AI 工厂设计标准与电网韧性标准。
-
NVIDIA 为 NVIDIA DSX AI Factory 平台推出新的开源软件组件。
-
Meta 与 NVIDIA 借助 NVIDIA Spectrum-X 以太网 SuperNIC 与 Spectrum-6 的创新,推进开放 AI 网络。
-
Visionbay 发布面向 Vera Rubin 时代的 800V DC AI 工厂设计。
-
NVIDIA 与 Cisco 发布超密集小尺寸可插拔(Ultra-Dense Small Form Factor Pluggable,USFP)标准,这是业界首个面向 400Gb/s 网络架构的模块形态。
-
NVIDIA 与 Google 宣布,未来的 NVIDIA ConnectX-10 SuperNIC 与 BlueField DPU 将支持 Falcon Transport。
在全场座无虚席的听众面前,NVIDIA 超大规模与高性能计算副总裁 Ian Buck 阐述了开放基础设施如何成为全球 AI 工厂规模化的关键要素。
OCP 上发布的这些消息表明,NVIDIA 的极致协同设计(extreme codesign)与开放标准相结合,正在加快部署速度、提升电能效率,并推动每瓦 Token 数(tokens-per-watt)这一性能指标的提升。
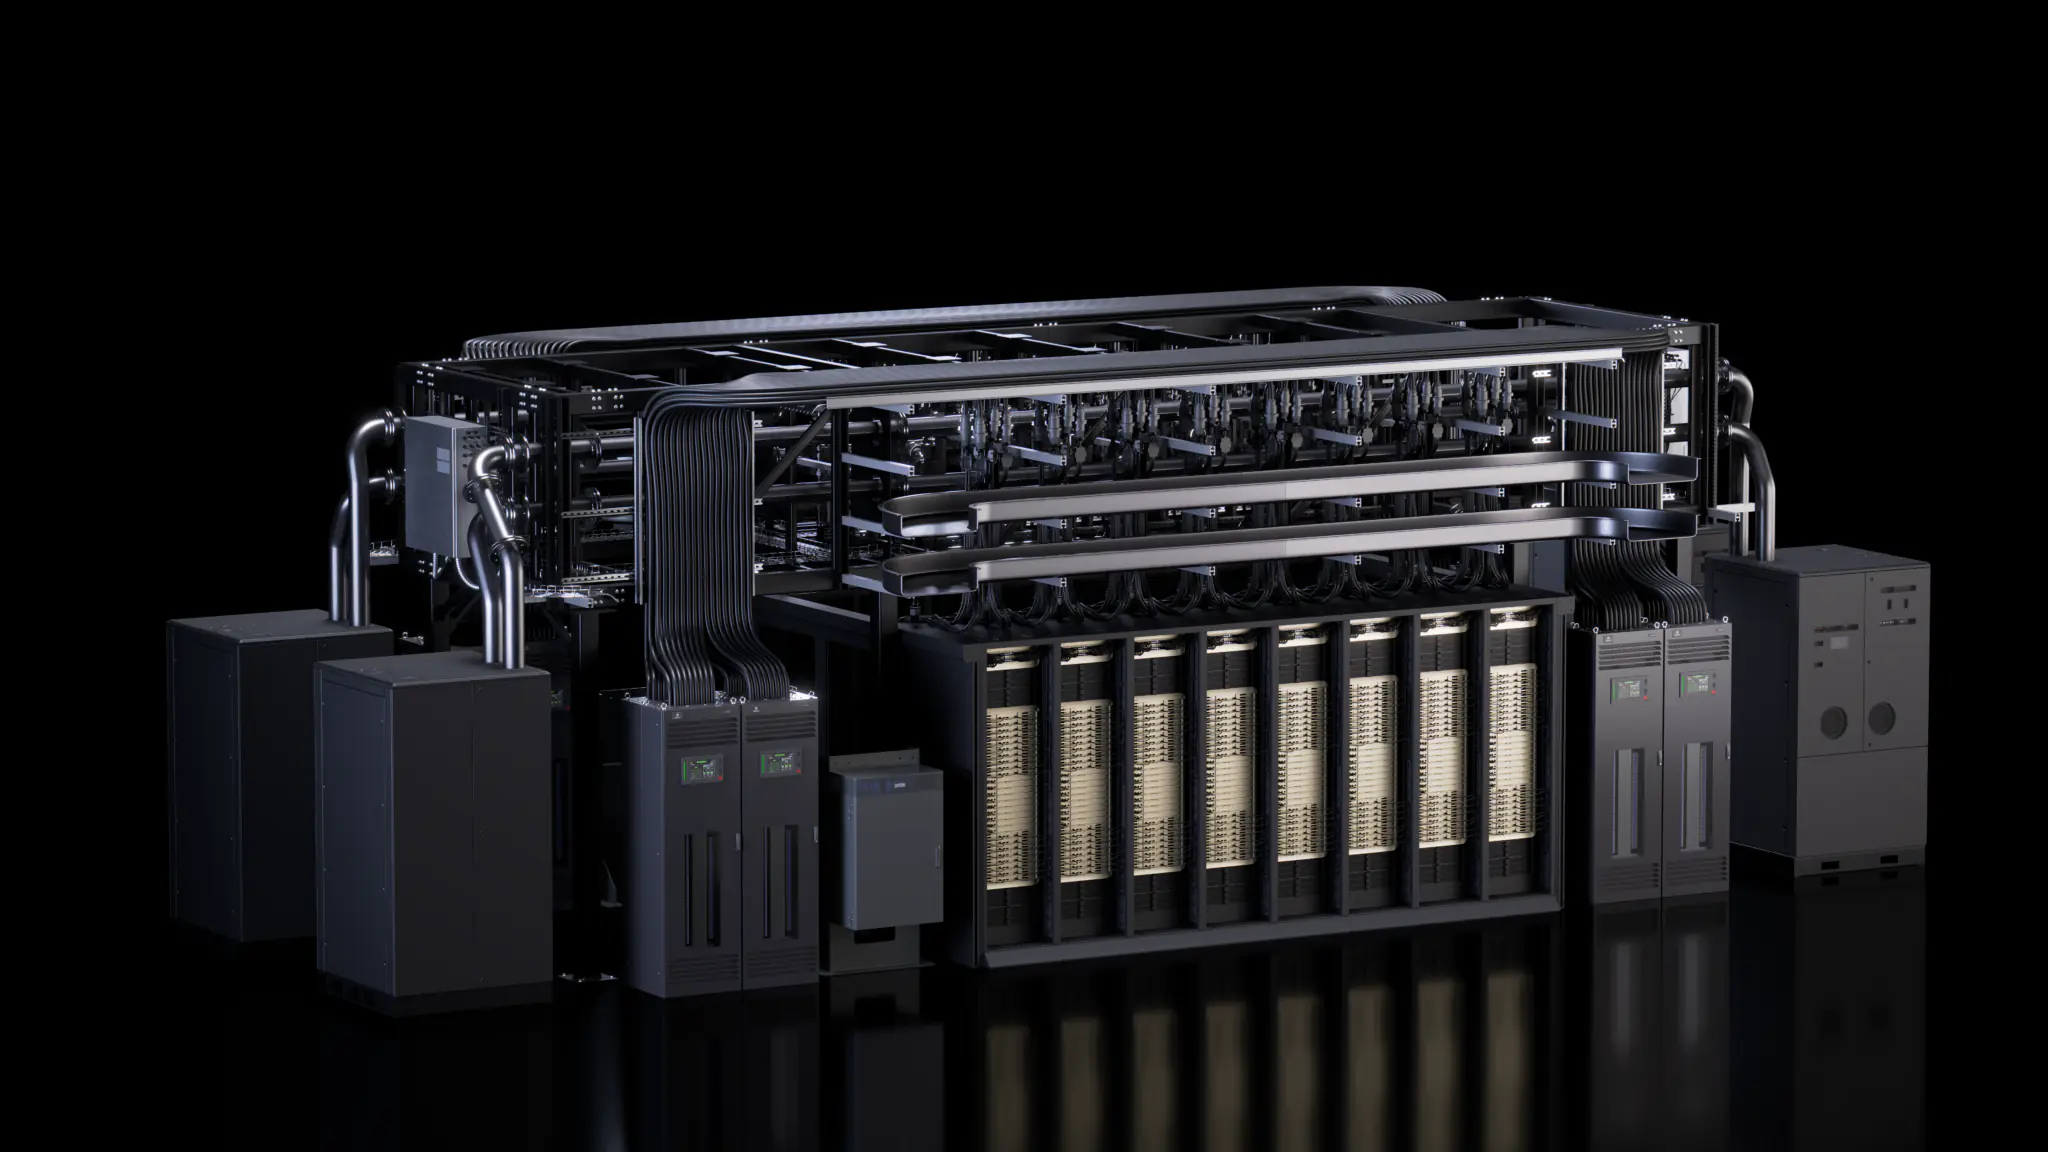
二、Vera Rubin AI 工厂借助 OCP 的 MGX 机架贡献向前推进
NVIDIA 与行业领军企业共同通过 OCP 的开放数据中心倡议(Open DC Initiative),为第三代 MGX AI 数据中心参考设计做出贡献。
结合 MQD、MQDB 等开放液冷技术,这项工作有助于将经过验证的 AI 工厂设计转化为行业标准,供其他厂商采纳、制造并规模化推广。
面向 NVIDIA Vera Rubin AI 工厂,更新后的 MGX 1.2 规范进一步扩展了 AI 工厂开放架构,新增机架级盲插(blind-mate)液冷、可互操作的机架级互连基础设施,以及为更高功率 AI 系统设计的液冷 5000A 母排。该规范还增加了对原生 19 英寸设备的支持与更高密度的机架设计。
MGX 1.2 通过可配置 I/O 仓、无风扇液冷计算托盘、标准化的供电与散热接口,以及帮助生态伙伴构建可互操作加速计算平台的通用基础设施,进一步增强了模块化能力。它缩短了装配、测试与维护时间,使制造与现场服务更加顺畅,从而支持更快、更高效的基础设施建设。该架构支持单机架最高 250kW 的部署,同时简化了可维护性、部署与基础设施复用。
Vera CPU 机架设计规范将 NVIDIA MGX 开放架构延伸至加速计算之外,为不断成长的智能体 AI 时代提供专用平台。Vera Rubin NVL72 是大规模训练与推理的基础平台,而 NVIDIA Vera CPU 机架则用于支撑工具调用、任务编排与沙箱化执行,帮助 AI 智能体实时与应用、数据和服务交互。
Vera CPU 机架基于第三代 NVIDIA MGX 机架架构构建,与后者共享同一套机架级设计原则——将计算、网络、供电与散热统一到通用的模块化平台上。这一方式使合作伙伴在部署专用基础设施的同时,仍可受益于共享的生态、简化的集成,以及面向下一代 AI 工厂的一致基础。
三、NVIDIA 为 DSX AI 工厂推出新的开源软件组件
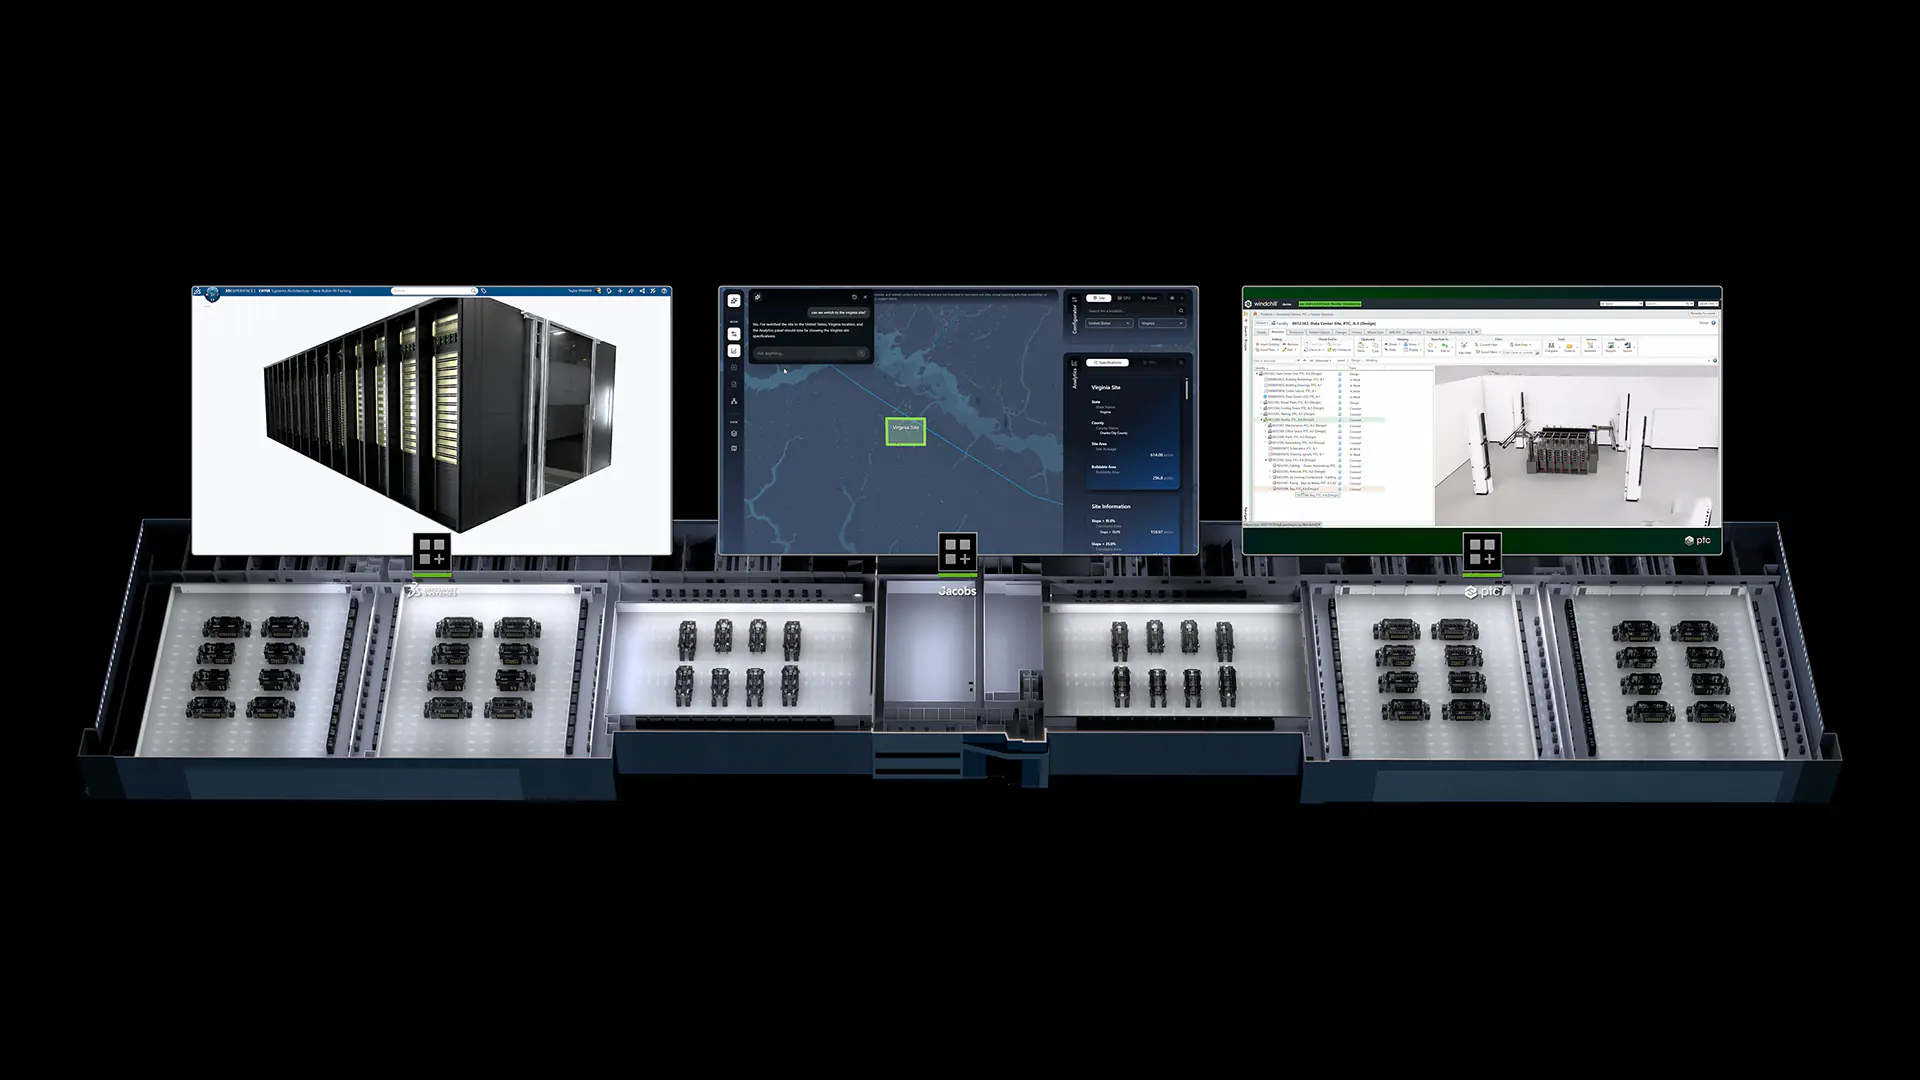
NVIDIA DSX AI 工厂平台以极致协同设计将计算、网络、供电、散热、设施与软件统一起来,使 AI 工厂作为一个整体优化的系统运行,在既有基础设施约束下最大化 AI 产出。这个统一系统的核心是 DSX OS——一层开放的操作层,它将 DSX 架构转化为规模化、可协调、可重复的运维流程。
在 OCP 上,NVIDIA 为 DSX OS 扩充了四款开源组件,分别用于网络配置、集群验证、机架管理与裸金属置备:
-
NVIDIA Config Manager :大规模自动化交换机配置,使客户能够以极少甚至零人工干预,完成 AI 工厂网络架构的部署、验证与一致性维护。
-
NVIDIA Cluster Readiness Engine :通过真实负载模拟对 GPU 集群进行压力测试,在训练开始前确认硬件健康状态,从而避免代价高昂的作业崩溃。
-
NVIDIA Rack Management Service :提供机架硬件抽象与运维方案,将机架作为一等单元(first-class unit)管理,提升 AI 工厂规模化场景下的固件管理能力。
-
Cluster API Provider for NVIDIA Infrastructure Controller :加快裸金属部署与租户接入,将裸机 AI 硬件在数小时内而非数日内转变为生产就绪的集群。
这些开源组件源自 NVIDIA 运营 NVIDIA DGX Cloud 的实践经验,可帮助云服务商与软件伙伴将 AI 工厂能力直接集成到自身的多租户平台中。
开发者可访问 DSX AI Factory 的 GitHub 页面,了解并为 NVIDIA DSX AI 工厂平台新增及既有的开源软件组件做出贡献。
四、NVIDIA 与超大规模云服务商发布下一代 AI 工厂开放标准
AI 基础设施要在全球范围内实现规模化,需要的不仅是先进硬件,还需要一个全行业都能在其上构建的通用基础。
在 OCP 上,NVIDIA 与 AMD、Google、Meta 共同发布了一项建立这一基础的新开放规范。Open Data Center Specification v0.7(开放数据中心规范 v0.7)为下一代 AI 工厂的设施设计定义了统一蓝图,覆盖从供电架构、散热基础设施到物理布局的各个环节。
由 Google、Meta、Microsoft 与 NVIDIA 共同发布的 OCP Grid Resilience Specification(OCP 电网韧性规范),规定了大规模 AI 基础设施在公用电网扰动期间应具备的行为:保持并网、自动响应,并在不到两秒内恢复至接近满载。
随着这些标准对外开放,全球制造商有了共同的构建目标。设备制造商、托管数据中心服务商与数据中心运营商可以着手设计、制造并交付支撑全球在建 AI 工厂的基础设施层,而无需等待个别客户的私有规范。
这些规范与 NVIDIA DSX 参考设计兼容,为上述两项规范提供了经过验证、可直接部署的实现——从设施布局、供电架构,到实时监测并响应电网信号的软件。对正在建设 Vera Rubin AI 工厂的运营方而言,从开放社区标准到一套运行中的系统,如今已是一条直线。
五、Visionbay.ai 为 Vera Rubin 时代设计 800VDC AI 工厂
随着 AI 工厂规模更大、算力更强,一个共同挑战始终悬在它们之上:如何为驱动下一代 AI 的加速计算系统输送足够的电力。
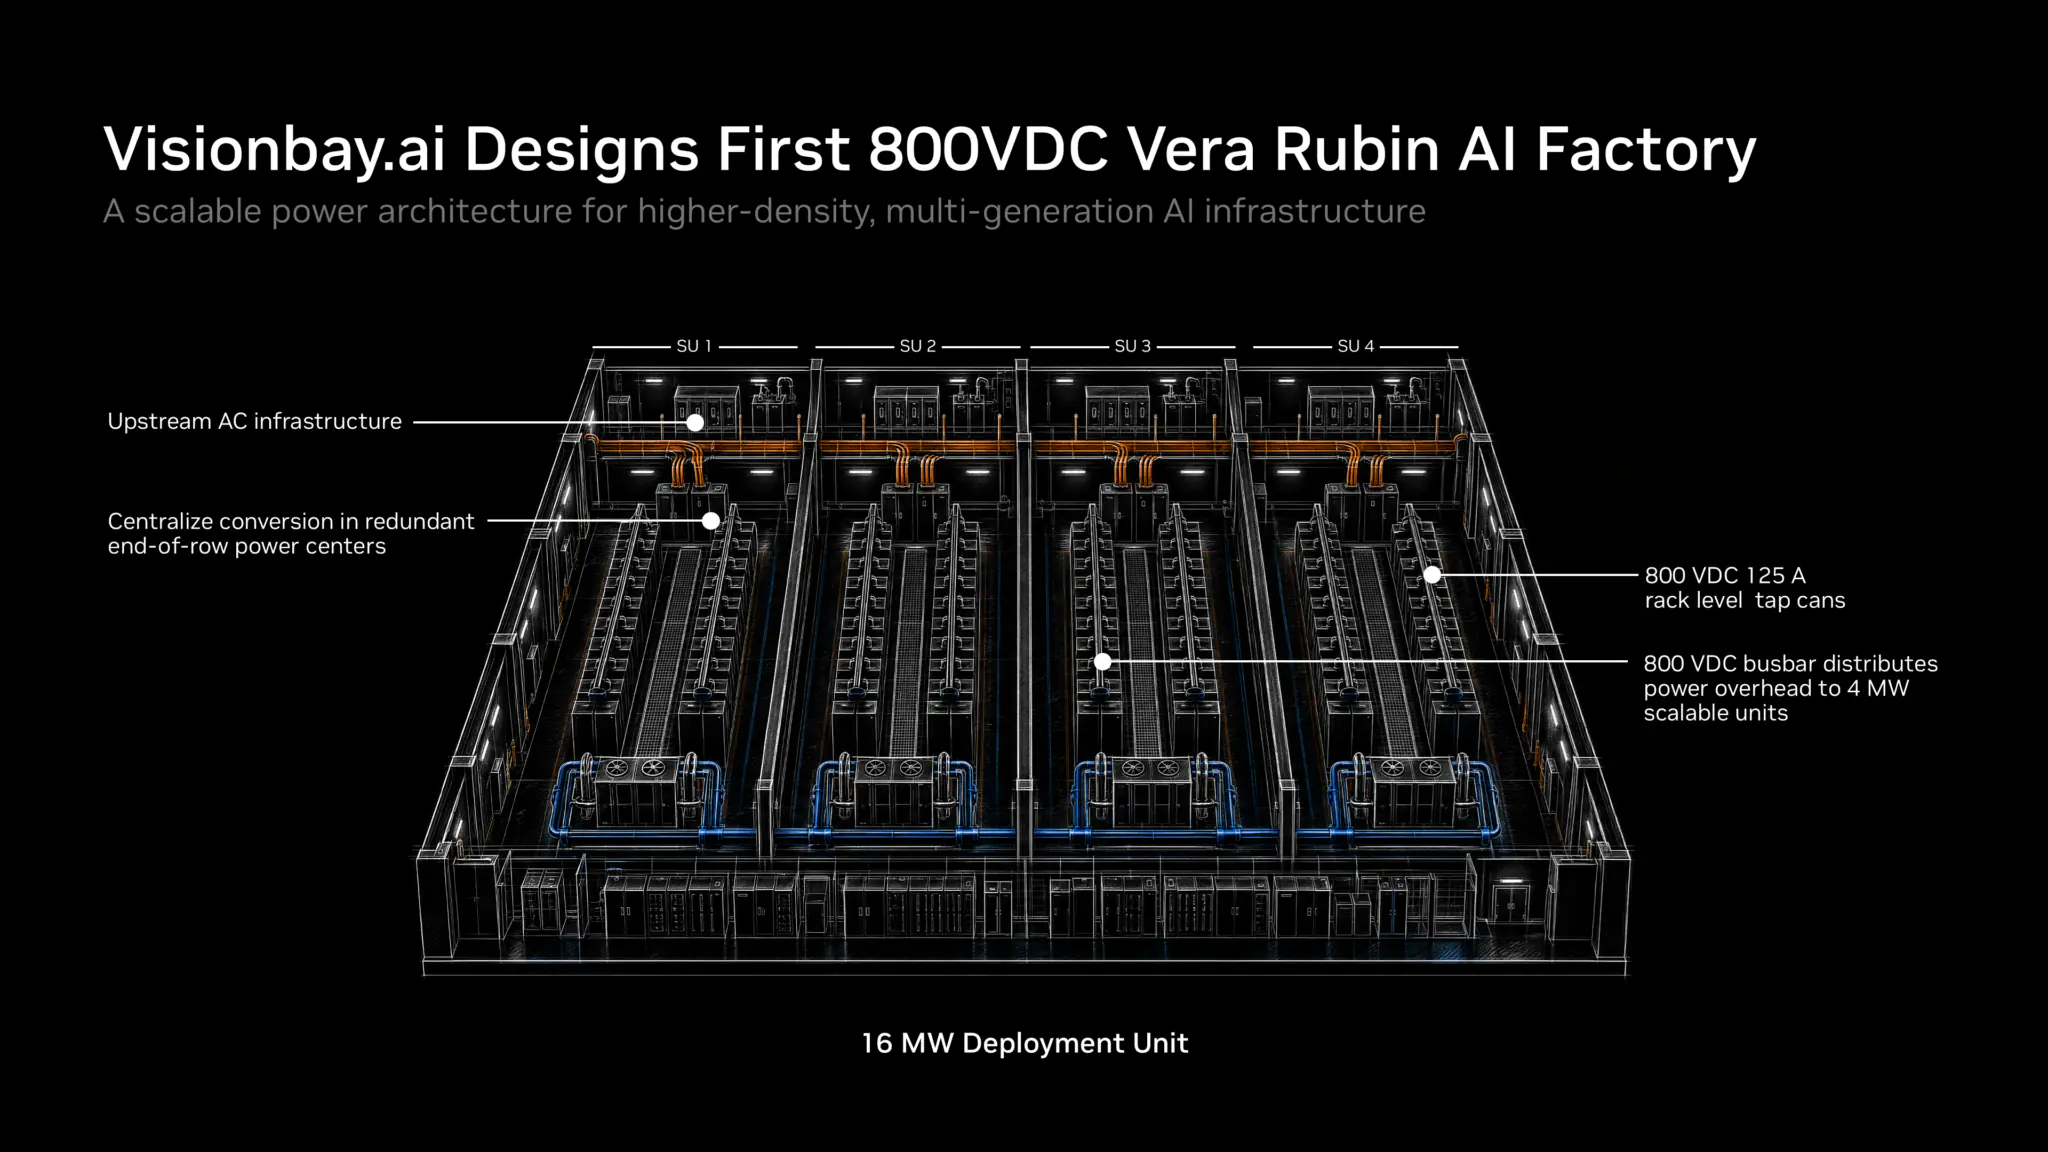
在 OCP 上,Visionbay 公布了 K-1 的设计方案——这是一个围绕 800 VDC 架构设计、面向未来 NVIDIA Vera Rubin 部署的下一代 AI 工厂平台。该项目将 NVIDIA 的 800 VDC 参考架构与 Vertiv 的供电及热管理技术相结合,为高密度 AI 基础设施构建可扩展的基础。
该设计回应的是日益突出的行业难题。随着 AI 训练、推理与深度推理(reasoning)负载持续扩张,机架功率密度不断攀升,传统低压配电越来越难以扩展,需要更多的铜材、更多的线缆和更多的电源转换设备。
通过采用 NVIDIA 的 800 VDC 架构,K-1 为更高密度的 AI 基础设施开辟了路径,同时保留了对既有部署的灵活性。该平台并不要求在第一天就完成整体切换,而是设计为在收益最大的环节分阶段引入 800 VDC 配电,帮助运营方为未来几代加速计算做好准备,而无需对设施进行大规模改造。
该架构围绕集群级供电中心设计,将交流转直流(AC-DC)转换集中处理,并把 800 VDC 配电延伸至更靠近计算资源的位置。这一做法简化了下游供配电,支持模块化扩展,并为未来 AI 工厂的增长提供了可复用的构建单元。
K-1 也体现了 NVIDIA AI 工厂背后的系统级设计理念——供电、散热与计算被放在一起设计。凭借对液冷基础设施、可扩展配电以及未来 Vera Rubin 级部署的支持,该项目展示了生态伙伴如何将 NVIDIA 的 AI 工厂架构转化为可部署的基础设施,以承接加速计算的下一个时代。
六、Meta 与 NVIDIA 以 Spectrum-6 与多平面技术推进 AI 网络
在本次活动上,Meta 与 NVIDIA 宣布,Meta 正在采用 NVIDIA Spectrum-6 102.4Tb/s 以太网交换机,以开放网络构建规模更大、性能更高的 NVIDIA Vera Rubin AI 工厂。
Spectrum-6 的交换容量与单通道带宽均为 Spectrum-4 的两倍,可提供每通道 200G 的无损以太网 AI 网络,具备高有效带宽与性能隔离能力,使一个作业的流量不会拖慢另一个作业。
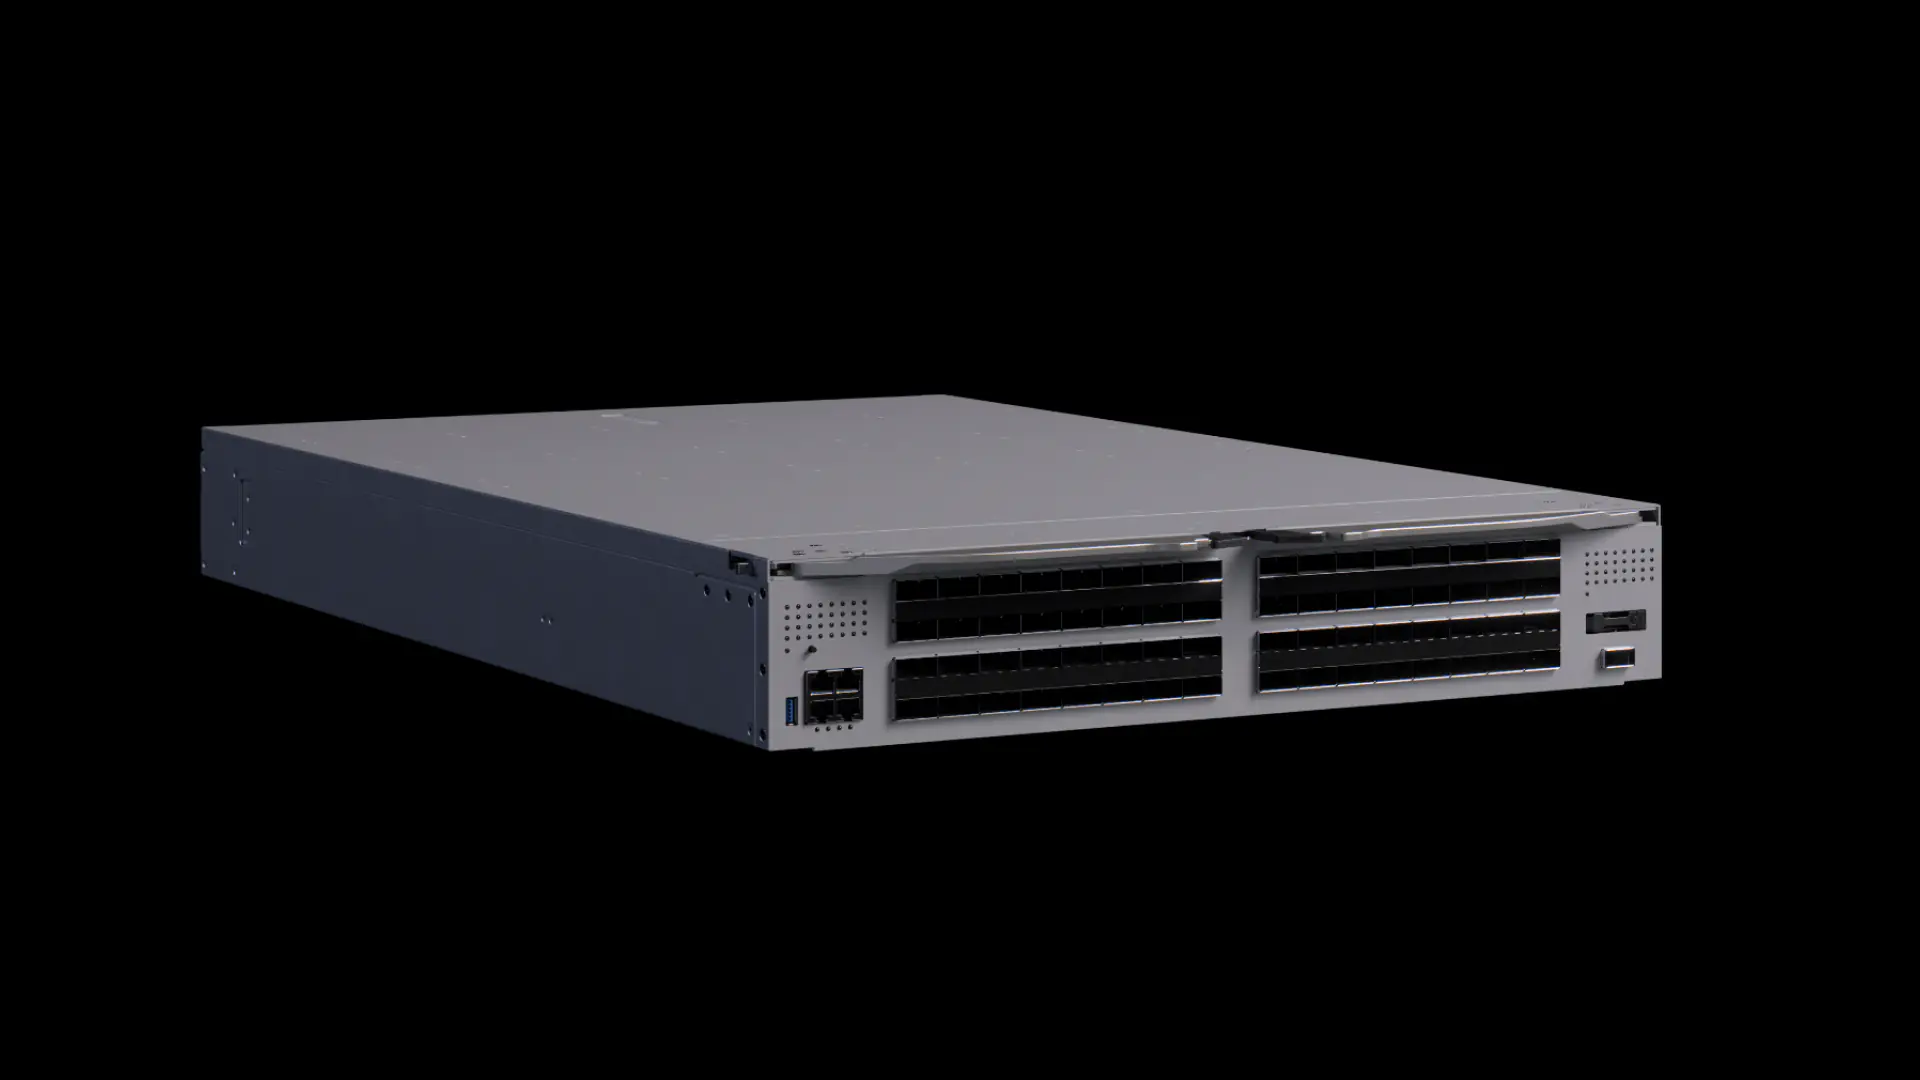
Meta 基于 Spectrum-6 的交换机 N-IceCube 可插入 IcePack——Meta 的 100T 液冷机架。N-IceCube 运行 Facebook 开放交换系统(FBOSS),这是 Meta 贡献给 OCP 的开源网络操作系统,用于支撑超大规模场景下的高效网络。
FBOSS 构建在交换抽象接口(Switch Abstraction Interface,SAI)之上——这是 NVIDIA 参与制定的 OCP 标准,提供了与厂商无关的交换机硬件控制方式。这些技术共同支撑起超过 10 万张 GPU 的智能体 AI 工厂,用于训练并服务大规模混合专家(MoE)模型。
此次发布标志着双方合作的又一步——它把 Meta 在超大规模场景下运营 AI 基础设施的经验,与 NVIDIA 的网络技术结合起来。
这项合作的核心是 Spectrum-X 多平面(Multiplane)技术,由 Spectrum-6 交换机与 ConnectX-9 SuperNIC 实现。多平面技术通过硬件将 GPU 流量分发到最多 8 个独立网络平面,使 AI 工厂能够以更少的交换层级和更低的基础设施成本扩展至 10 万张 GPU 以上。GPU 之间的多条路径提升了网络利用率与韧性:当某个组件发生故障时,流量会转移到其余平面,使 GPU 保持高效运转、AI 应用持续运行,即便带宽有所下降。
Meta 与 NVIDIA 通过部署经验与快速工程迭代共同强化了这种韧性,双方团队在本地部署与云环境中验证了相关改进。
“我们与 NVIDIA 的紧密合作,让多平面网络在运维层面具备可扩展性与高性能,我们对此感到振奋。这既是我们自身基础设施建设的关键要求,也是我们共同云合作伙伴的关键要求,”Meta 数据中心与 AI 网络高级总监 Omar Baldonado 表示。“将 FBOSS 扩展到 Spectrum ASIC,意味着我们可以在自有网络上运行同一套软件栈;Meta 基于 Spectrum 的新交换机 N-IceCube 将其带入 Icepack——这是我们用于横向扩展(scale-out)的 102.4T 液冷网络机架,用于连接我们机队中即将部署的新一代加速器。”
Meta 与 NVIDIA 正在共同制定一套架构与运维方法,供其他 AI 基础设施运营商采纳,将严苛生产负载中积累的经验转化为更具可扩展性、韧性与效率的 AI 工厂。
七、借 USFP,NVIDIA 与 Cisco 为 AI 工厂规模重塑可插拔光模块
随着 AI 工厂为支撑更大的模型与激增的推理需求而不断扩展,基础设施栈中的每一个组件都必须提供更高的性能、效率与简洁性——直到网络连接这一层。
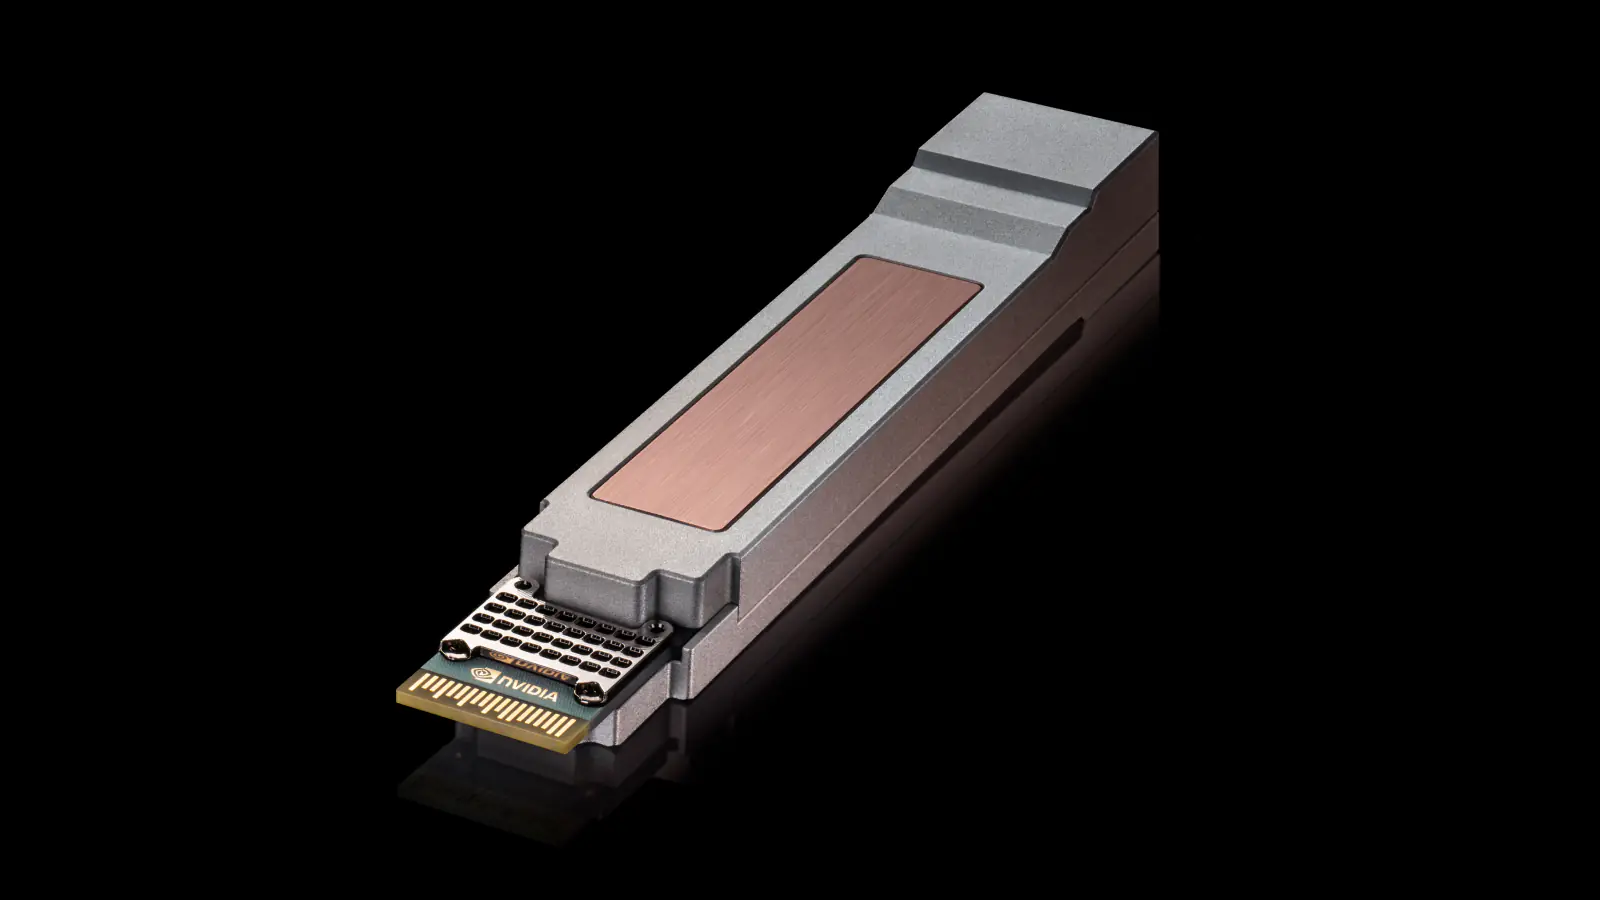
在 OCP 上,NVIDIA 与 Cisco 公布了 USFP 的计划——这是一种全新的可插拔光收发模块形态,旨在帮助 AI 工厂建设者扩展下一代 AI 网络,同时提升带宽密度与电能效率。
USFP 的占位面积与广泛采用的 200Gb/s 单通道 OSFP 形态大致相当,却为 400Gb/s 单通道网络提供了路径,并延续了已在数代数据中心网络中验证过的、基于光收发模块的部署模式。USFP 集成 16 条全双工通道,并计划扩展至 32 条,其带宽密度将达到传统 200Gb/s 单通道可插拔光模块的四倍。
由此带来的结果是:可以在不增加网络层级的前提下连接更多计算资源——而增加层级会推高时延、功耗与复杂度。
这一新形态针对下一代 AI 工厂在规模与效率上的需求而设计,在支持更高带宽网络的同时,保留了可插拔光模块成为现代数据中心主流的灵活性与可维护性。它还将带来约 1.3 倍的电能效率提升,帮助运营方以更少的能耗搬运更多数据。
为构建开放生态,NVIDIA 与 Cisco 正与 TE Connectivity、Amphenol 在笼体(cage)、连接器与模块方面开展合作,并计划通过社区主导、多供应商供货的方式推进 USFP。几家公司正在共同为更具可扩展性、效率与互操作性的 AI 工厂网络奠定基础。
八、Google Falcon Transport 支持 NVIDIA ConnectX-10,实现可互操作的 AI 网络
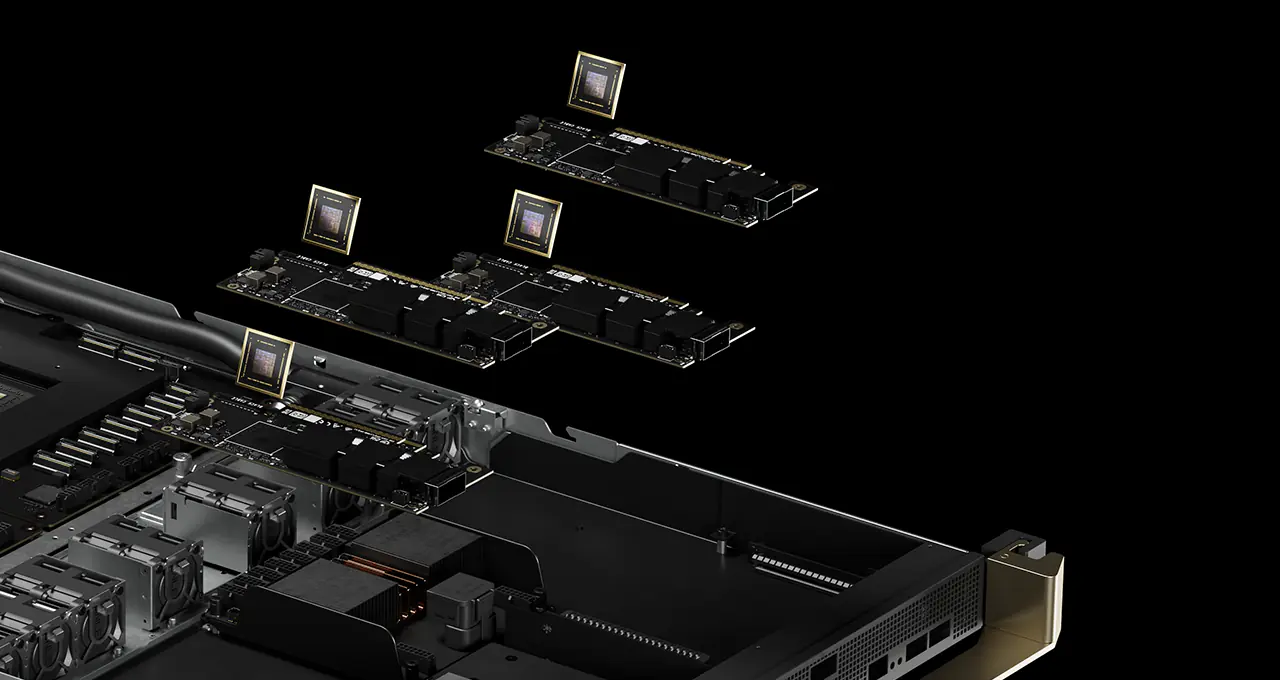
NVIDIA 与 Google 还宣布,未来的 NVIDIA ConnectX-10 SuperNIC 与 BlueField DPU 将支持 Falcon Transport,以提升大规模 AI 基础设施的网络效率。
Falcon 是一种传输协议,旨在以太网之上可靠地传输数据——以太网在拥塞时可能发生丢包。它通过多路径负载均衡、可编程拥塞控制、硬件丢包恢复与逐连接安全机制,支撑 AI 与存储负载。
这项合作将 NVIDIA 的硬件加速与 DOCA 软件结合,用以实现 Falcon,并把 NVIDIA 的网络能力延伸至 Google 数据中心的传输层。NVIDIA 与 Google 的网卡可以通过统一的传输协议通信,同时应用仍可沿用标准 RDMA 编程接口。
通过在多条路径间分发流量、适应拥塞、恢复丢包并保护连接,Falcon 帮助负载更好地利用可用带宽,并在以太网网络扩展时保持可预期的性能。