每瓦工作量最高提升 30 倍:NVIDIA Vera Rubin NVL72 为 AI 智能体树立能效新标准
SemiAnalysis AgentX 智能体负载实测:Vera Rubin NVL72 每兆瓦吞吐最高为 GB300 NVL72 的 30 倍,每百万 Token 成本最低降至 1/45。
OpenRouter 的数据显示,智能体 AI 负载消耗的 Token 是普通聊天请求的 15 倍。原因何在?
设想一个 AI 智能体为投资决策调研某家公司:它查询财务数据库,检索新闻与公告文件,调用子智能体完成同业对比与估值建模,最终把这些综合成一份建议。智能体与子智能体会持续推理,直到任务完成,Token 需求也随之放大。每推进一步,已累积的 Token 都会成为下一步的输入——长上下文处理能力,因此成为智能体 AI 性能的核心。
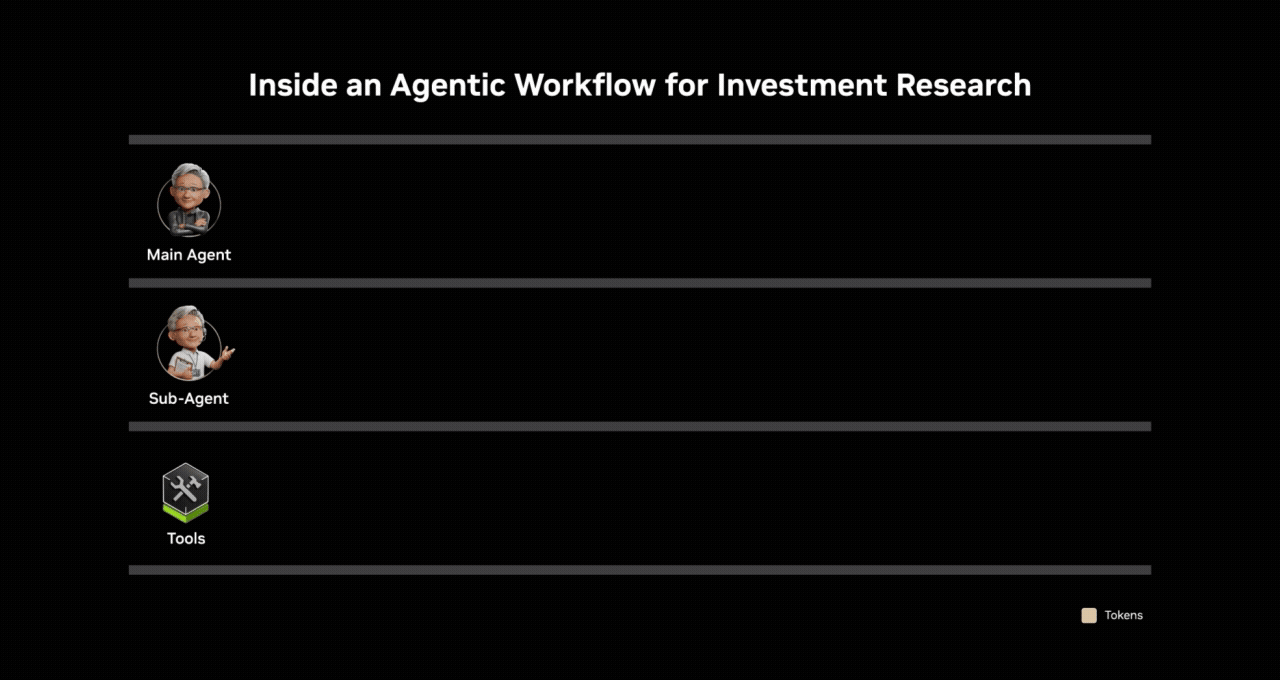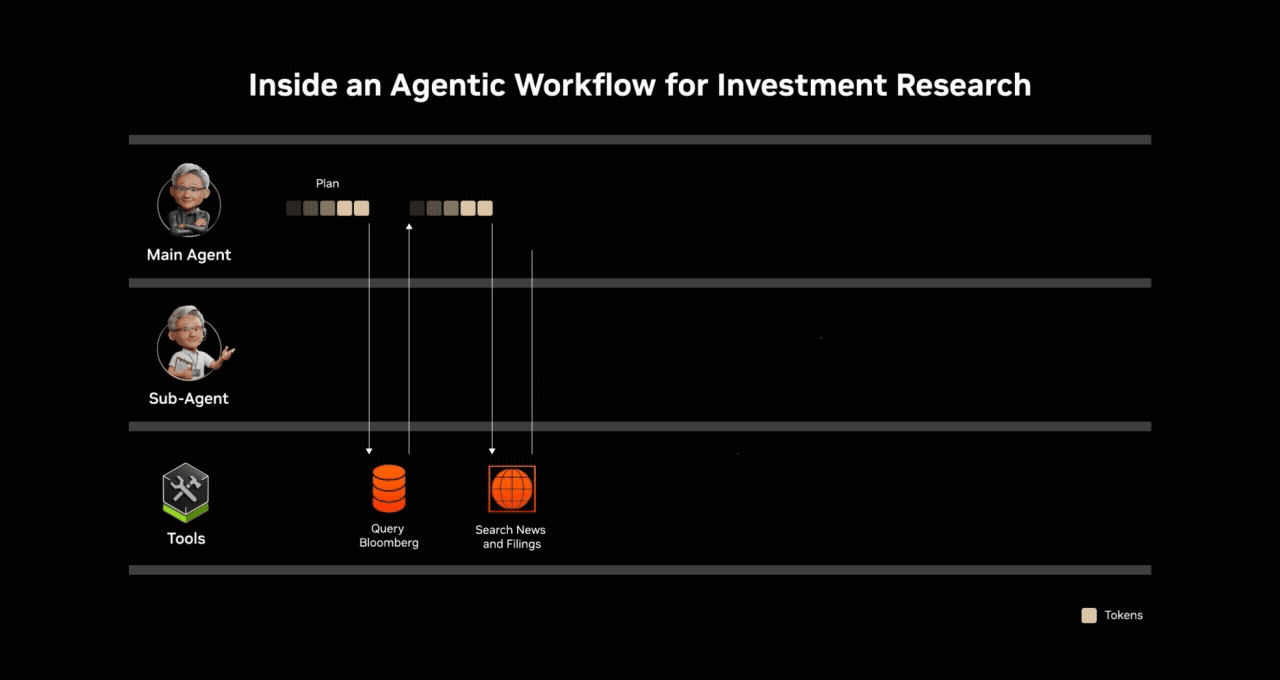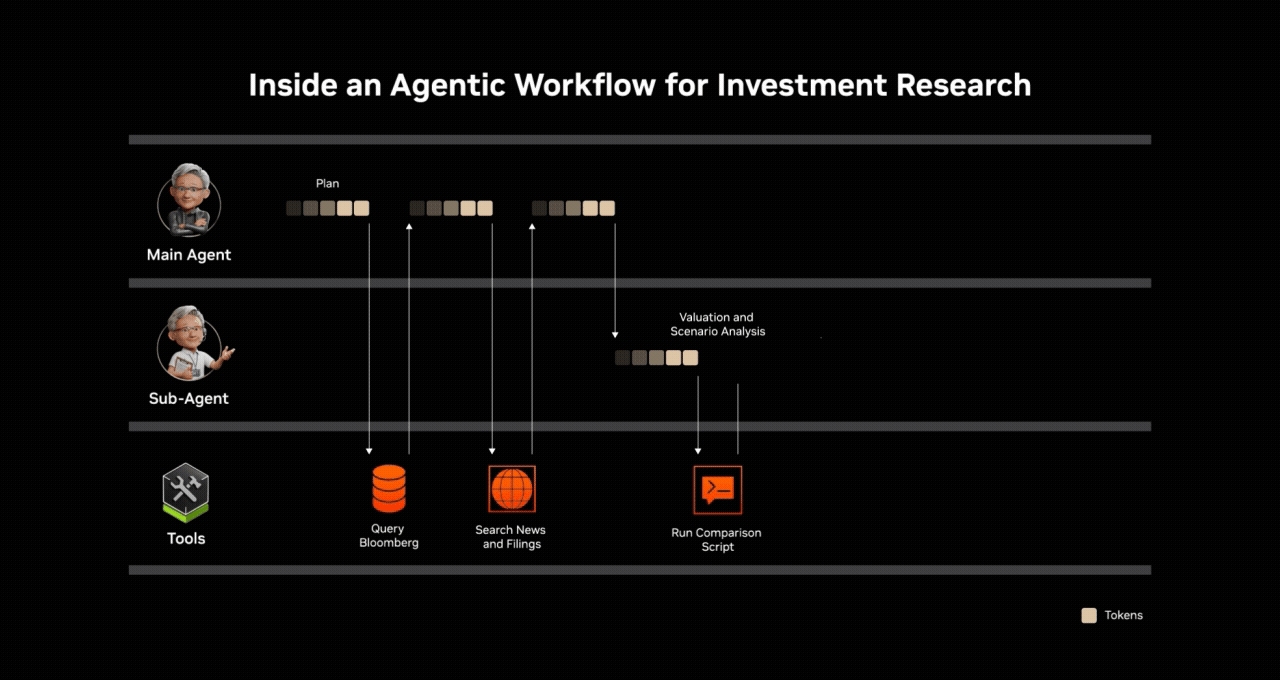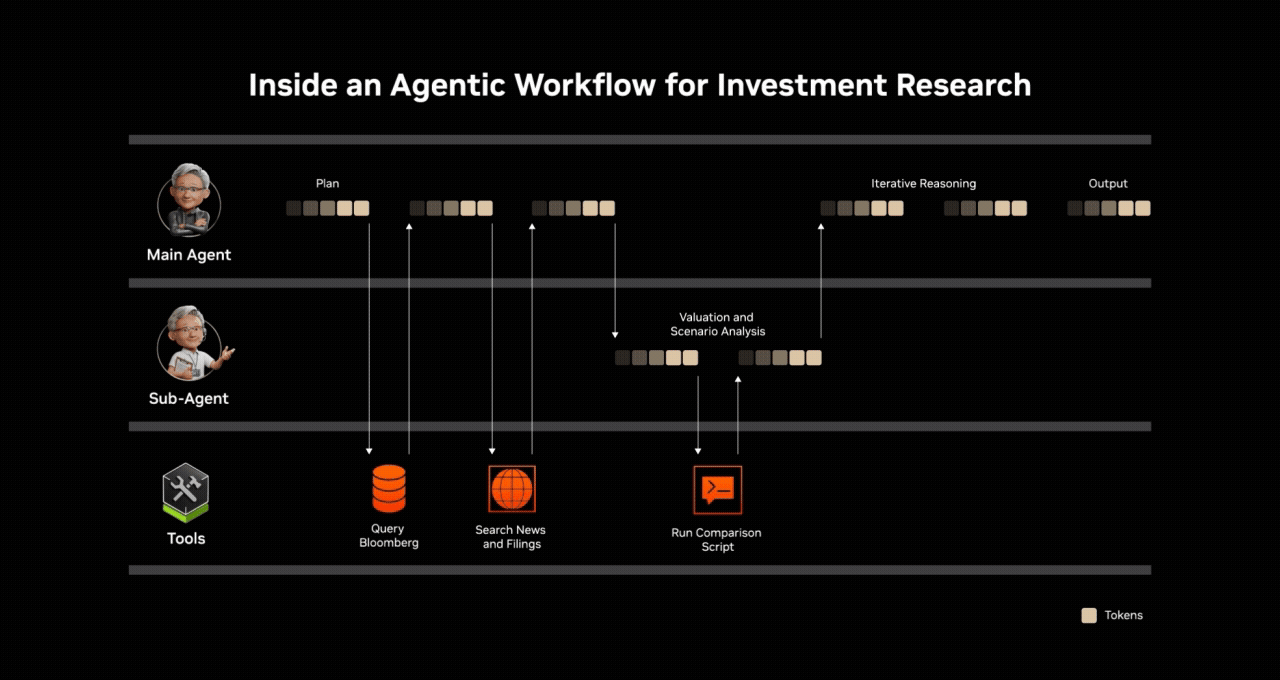
从软件开发到客户服务,再到深度研究,所有智能体场景都遵循同一模式。
随着智能体 AI 在各行业进入生产环境,承载它的基础设施必须以足够高的效率,接住这样的 Token 需求。
SemiAnalysis AgentX 的最新数据显示,在智能体负载下,NVIDIA Vera Rubin NVL72 系统的每兆瓦吞吐量最高达到 NVIDIA GB300 NVL72 的 30 倍。SemiAnalysis AgentX 的负载由真实智能体编码会话录制而成,完整保留了实际的上下文增长、工具调用与子智能体派生过程。对于受供电约束的 AI 工厂而言,这一性能意味着在相同能耗下完成 30 倍的智能体工作量。
这些属于 Vera Rubin NVL72 的早期成绩,体现了 NVIDIA 加快的创新节奏。随着软件持续优化,Vera Rubin NVL72 与 GB300 NVL72 的性能都将继续提升。
一、Vera Rubin NVL72:每兆瓦吞吐提升 30 倍,Token 成本降至 1/45
智能体负载与聊天、文档摘要类负载有本质区别:后者的输入与输出序列通常在 1K 到 8K Token 之间;而在智能体会话中,上下文跨步骤累积,输入 Token 可达数十万,且不同请求之间的输入、输出长度差异极大。性能度量方式必须随之演进——衡量的是完整的智能体工作流,而非单次推理请求。
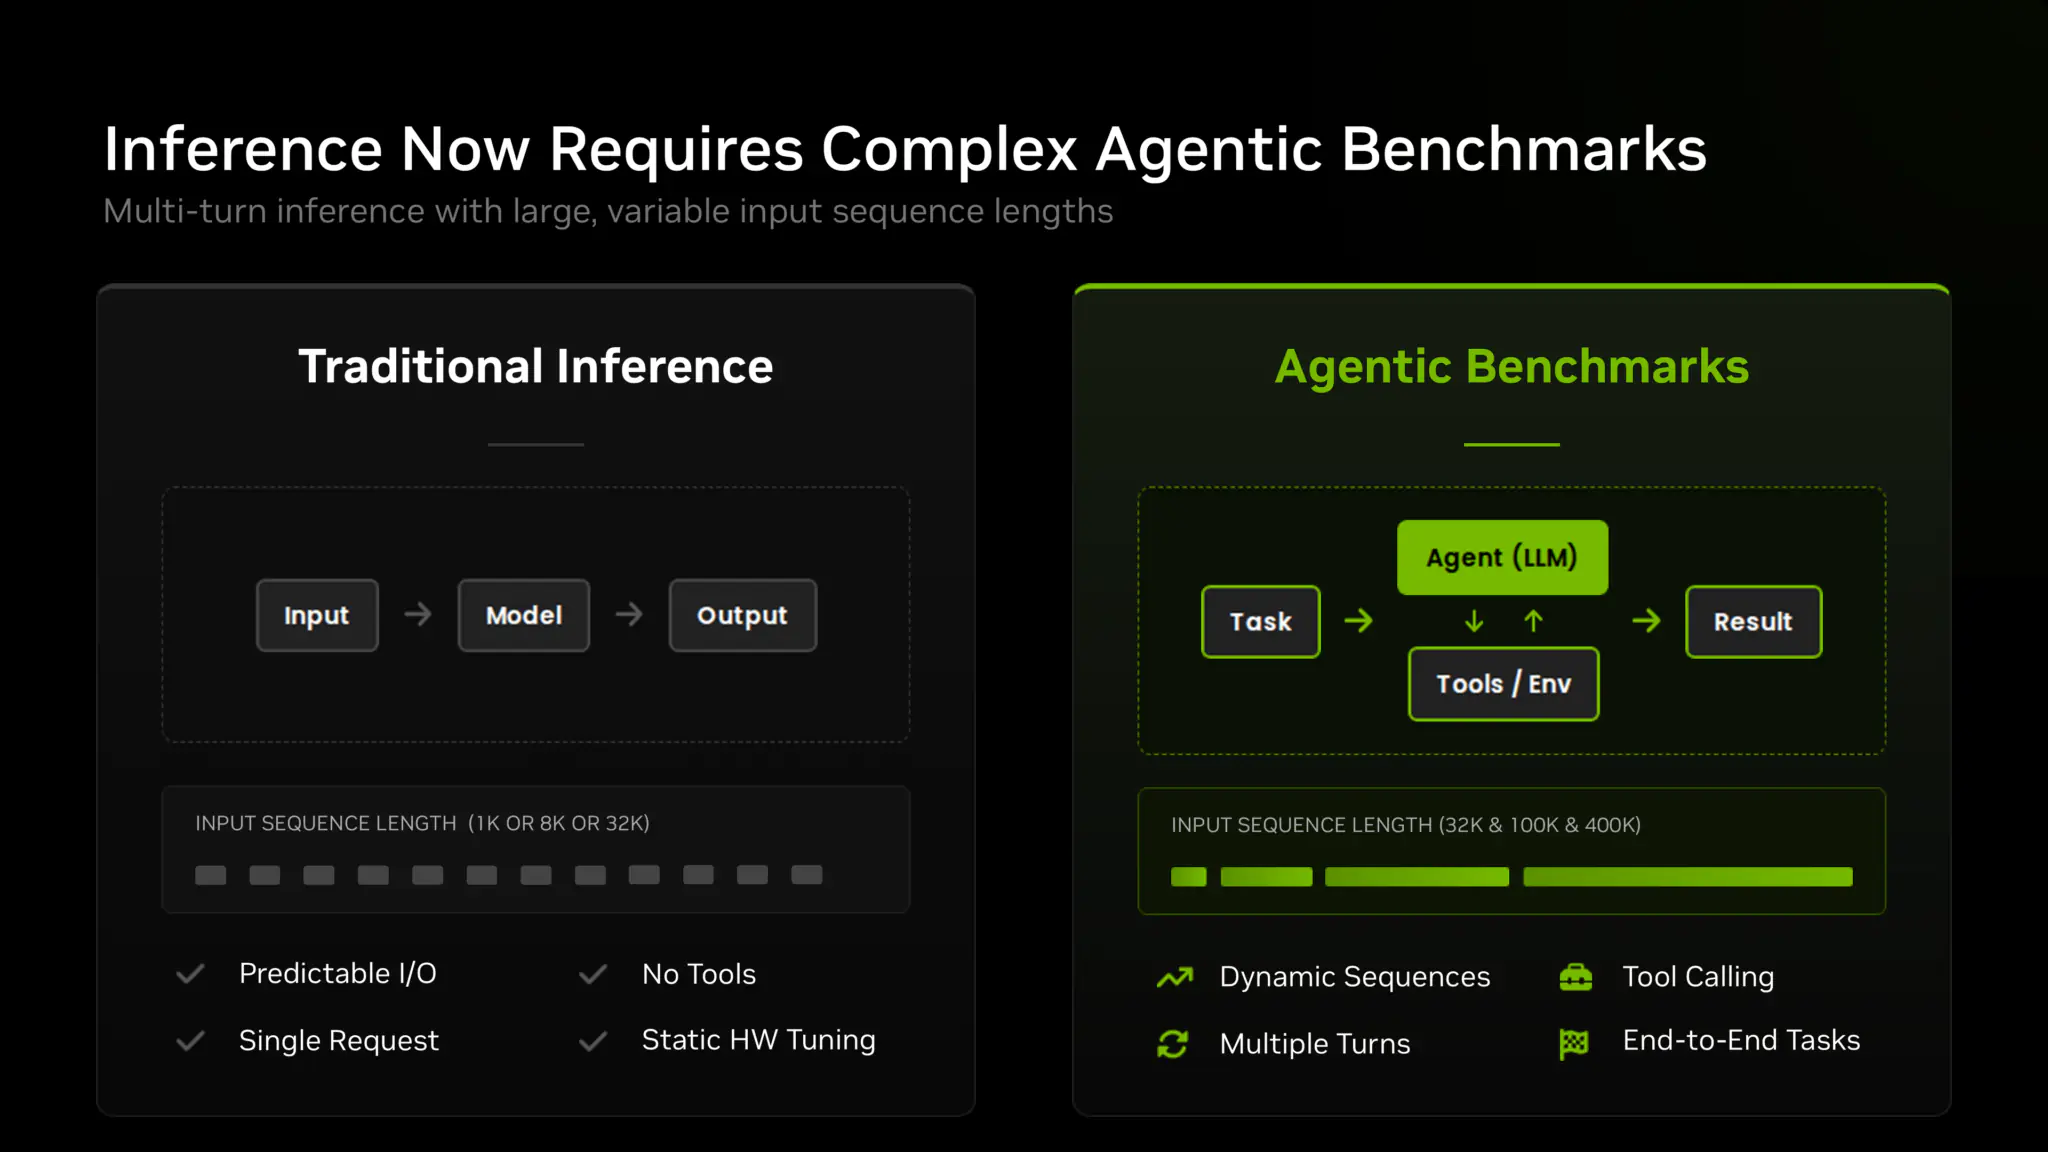
以下结果均基于真实智能体编码轨迹实测。
在 SemiAnalysis AgentX中,NVIDIA Blackwell 平台在 Kimi K3、MiniMax M3、GLM5.3、Qwen3.5 与 DeepSeek V4 Pro 等多款智能体模型上均取得领先性能。
例如在 DeepSeek V4 Pro 模型上,GB300 NVL72 的每兆瓦吞吐量最高达到 NVIDIA Hopper 架构的 15 倍,为客户运行智能体负载提供了高性能基础。这一跃升,体现了更大的纵向扩展 GPU 域与协同设计软件在推理效率上的优势。
Vera Rubin 把这一优势进一步拉大:在 DeepSeek V4 Pro 模型上,其每兆瓦吞吐量最高达到 GB300 NVL72 的 30 倍,整条帕累托曲线上的性能被同步抬升。需要说明的是,这些在 SemiAnalysis AgentX 负载上测得的早期成绩,尚未计入 Vera CPU 在工具调用上的表现。
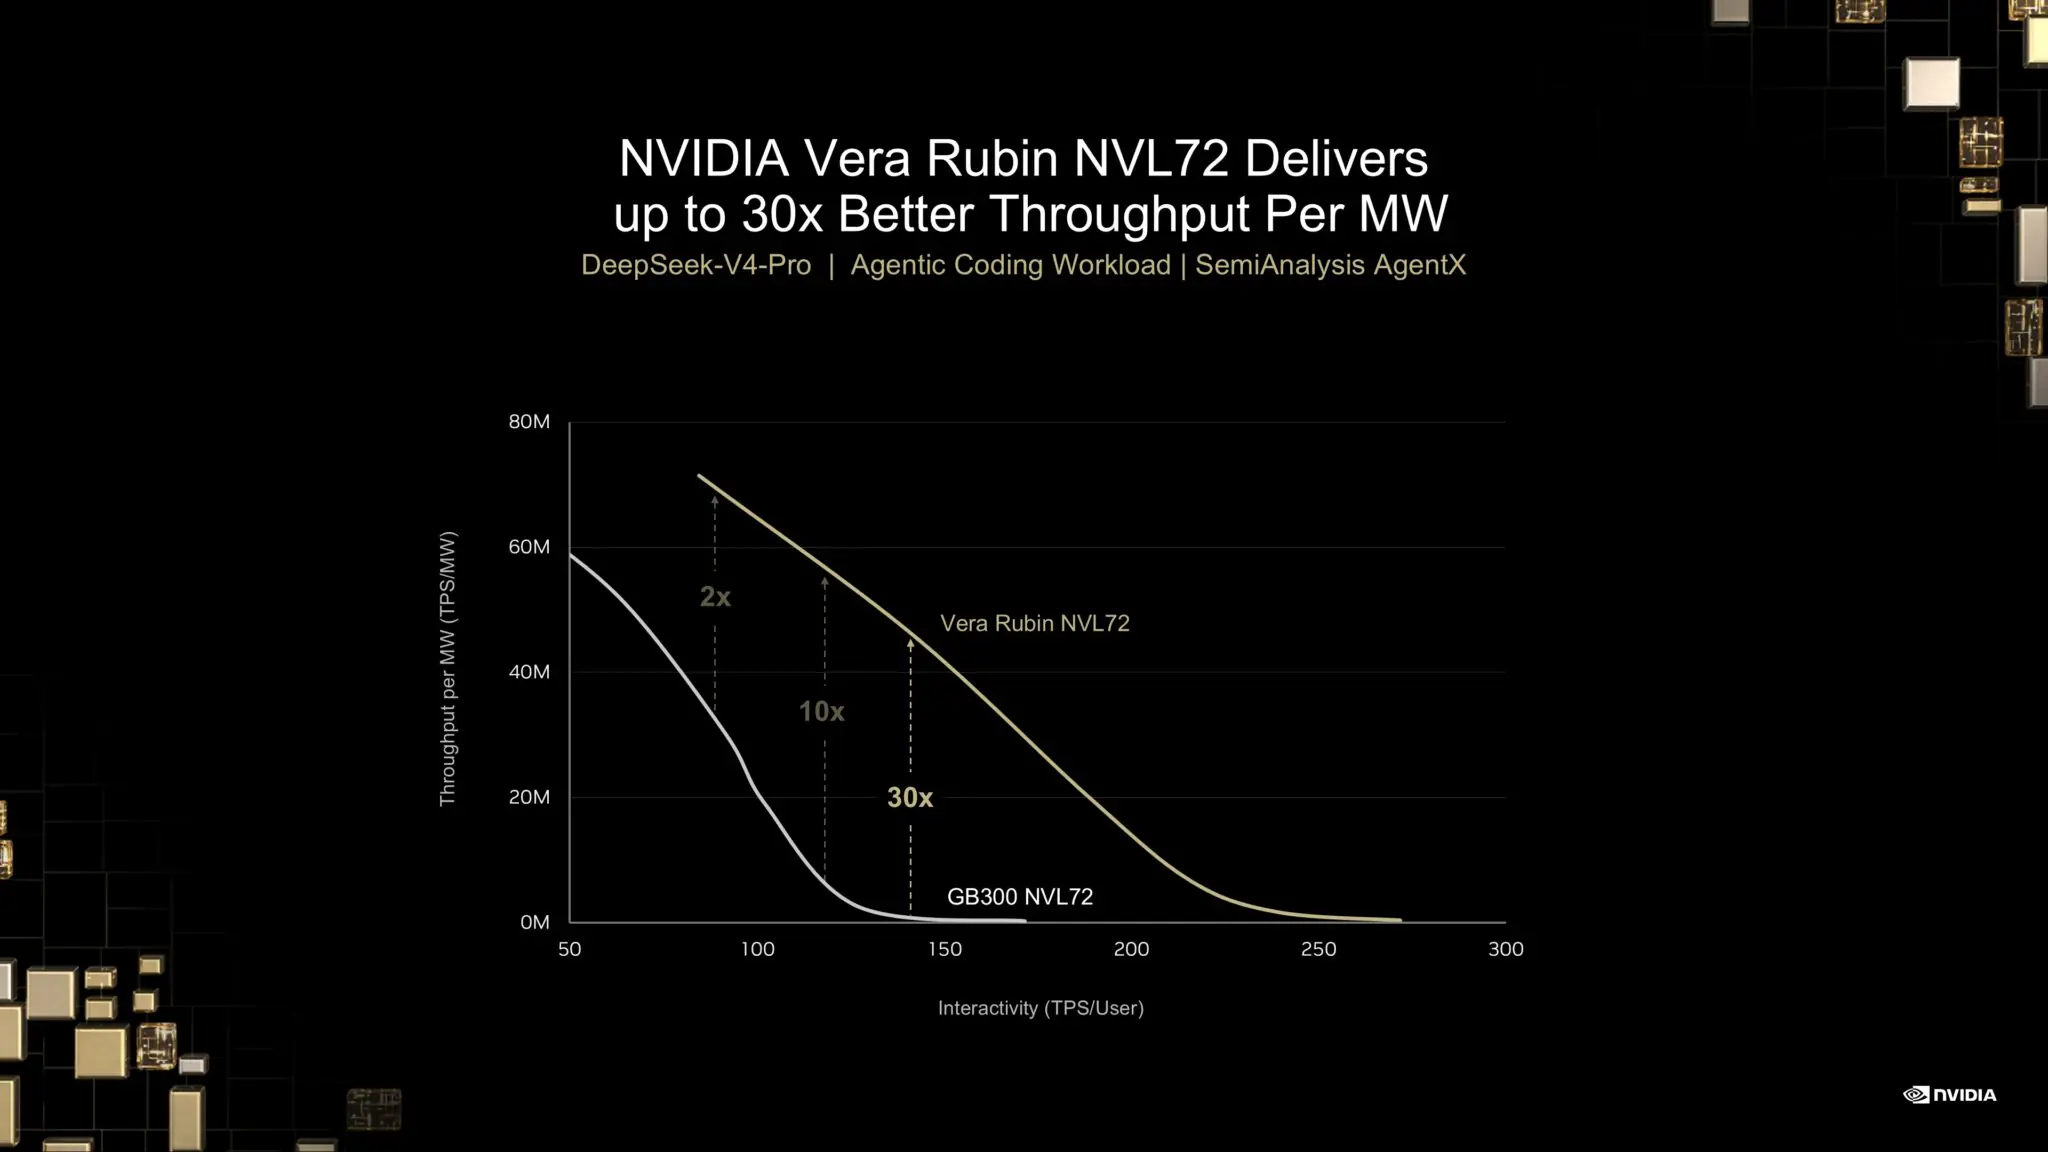
NVIDIA DSX MaxLPS 技术在 GPU、机架与负载三个层级统筹电力,可在相同的兆瓦预算内多部署最高 40% 的 GPU,从而在 AI 工厂规模上进一步推高每兆瓦吞吐。
每兆瓦吞吐还直接影响每一个 Token 的成本。相比 GB300 NVL72,Vera Rubin NVL72 的每百万 Token 成本最低可降至 1/45,因而能够以规模化方式,持续运行覆盖客户各类负载的智能体。
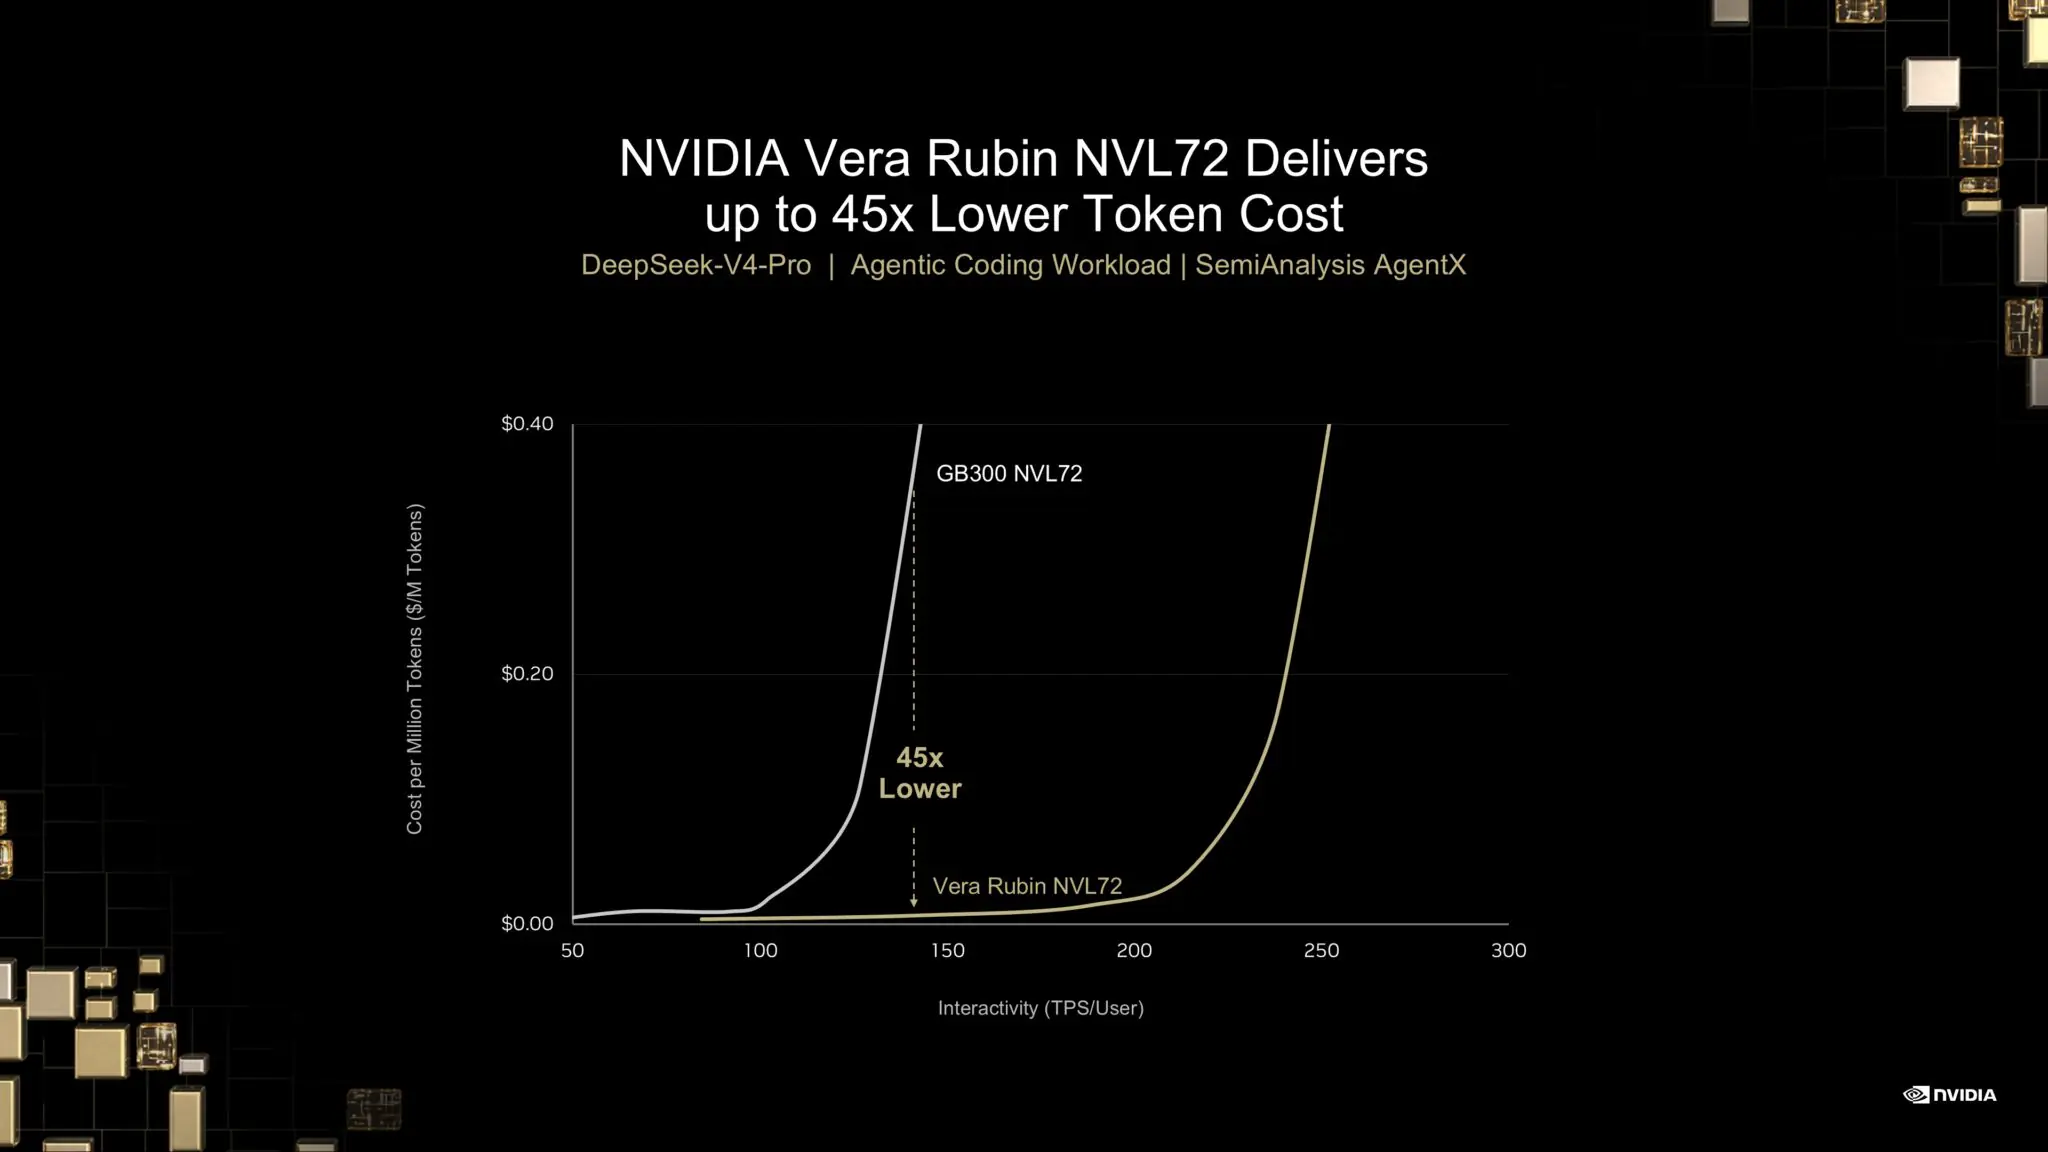
对受供电约束的 AI 工厂来说,每兆瓦吞吐决定工厂的收入,而每百万 Token 成本决定这份收入能留下多少利润。
二、面向智能体规模的极致协同设计
现代推理优化涵盖一系列技术,这些技术在智能体 AI 场景中尤为关键。NVIDIA Vera Rubin NVL72 通过平台各层的极致协同设计(extreme codesign),把这些技术全部落地并进一步扩展,从而带来数倍性能提升。
-
分离式服务:将上下文处理(预填充,prefill)与响应生成(解码,decode)拆开,使两者可独立扩展。
-
速率匹配:让预填充 GPU 与解码 GPU 的 Token 产出速度保持同步,以最大化效率。
-
大规模专家并行:将混合专家模型中的专家子网络分布到整个纵向扩展 GPU 域。
-
分布式 KV 缓存:把缓存能力扩展到整个纵向扩展 GPU 域;KV 缓存卸载则把活跃度较低的上下文分层下沉到主机内存与存储,使此前处理过的上下文无需重新计算即可调用。
-
KV 感知路由:把新到的请求直接导向已持有相关缓存上下文的 GPU,减少长会话中的重复计算。
-
MegaMoE 等融合 CUDA 内核:把大量计算与 GPU 间通信操作合并进单次执行,让 GPU 持续运转,而不是空等数据。
NVIDIA Rubin GPU 增强的第五代 Tensor Core,同时加速推理的预填充与解码阶段。NVFP4 量化把模型权重压缩到 4 位精度,在不牺牲输出质量的前提下降低显存占用、提升吞吐。
NVL72 的纵向扩展域是 Vera Rubin 与 Grace Blackwell 共有的标志性架构,它提供的 GPU 间高带宽、低时延通信,正是大规模专家并行、分布式 KV 缓存等技术得以成立的前提。第六代 NVIDIA NVLink 互连技术与 NVLink Switch 专为支撑这一扩展域而设计,报文速率是通用以太网方案的 10 倍,时延仅为后者的三分之一。
从优化后的 CUDA 内核,到 NVIDIA TensorRT LLM 这类推理运行时,再到 NVIDIA Dynamo 这类服务框架,NVIDIA 的软件栈与硬件协同设计,使上述推理优化得以生效。
上述结果反映的是 Vera Rubin NVL72 当前的性能,而完整平台是一套七芯片架构,还包括 NVIDIA Vera CPU、Groq 3 LPU、NVLink 6 Switch、BlueField-4 DPU、Spectrum-6 SPX 与 ConnectX-9 SuperNIC——全部为规模化部署智能体的 AI 工厂专门设计。
极致协同设计也延伸到 NVIDIA 与合作伙伴的联合工程。Vera Rubin 已全面量产,并正在整个生态中扩大部署。