NVIDIA Vera Rubin NVL72 在 MLPerf Inference v6.1 首秀中性能领先
Vera Rubin NVL72 首秀 MLPerf Inference v6.1:Qwen3-VL 预览提交吞吐最高为 GB300 NVL72 的 3.7 倍;GB300 NVL72 288 卡扩展效率达 99%,软件优化较 v6.0 再提 1.6 倍。
系统性能、高效的基础设施扩展能力与持续的软件优化,是决定 AI 推理经济性的三个关键杠杆。更高的系统性能意味着生成更多 Token,从而带来更高收入;高效扩展意味着增加硬件时吞吐按比例增长,从而在规模化服务用户时占用更少资源;持续优化意味着从基础设施投资中产出更多价值。
支撑这三者的,是平台的可互换性:同一套基础设施可运行任何模型、任何负载——从训练到推理、从推荐系统到推理性负载、从语言到视频——从而把利用率维持在较高水平。
NVIDIA 平台正是为同时优化这三者而专门设计。今日发布的 MLPerf Inference v6.1 结果即是印证:
-
NVIDIA Vera Rubin NVL72 系统首秀即性能领先:在首次 MLPerf Inference 预览提交中,NVIDIA Vera Rubin NVL72 的吞吐量最高达到 GB300 NVL72 的 3.7 倍。
-
NVIDIA GB300 NVL72 以领先效率实现扩展:一项跨四台 GB300 NVL72 机架、共 288 张 GPU 的提交实现了 99% 的扩展效率,吞吐相对单机架基线接近线性增长。
-
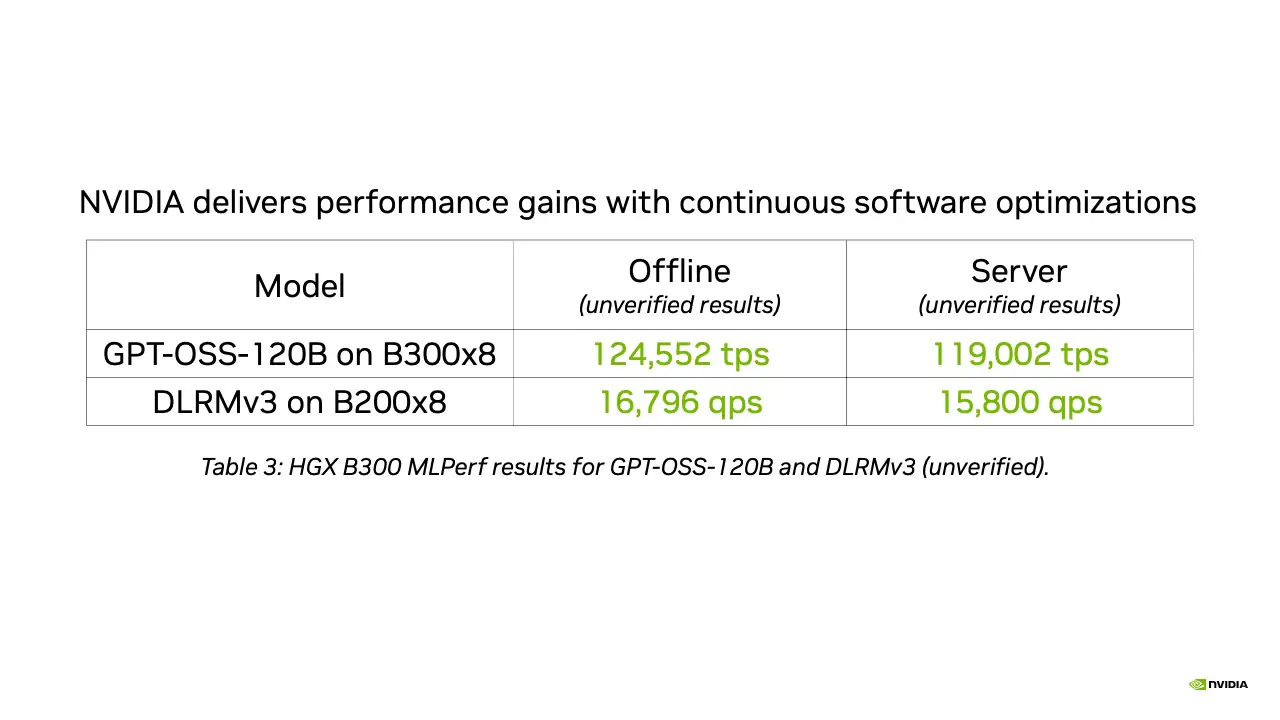
持续的软件优化带来性能提升:NVIDIA 在 MLPerf Inference v6.1 提交中的软件优化,使性能较 v6.0 最高提升 1.6 倍。v6.1 提交之后优化仍在继续,并进一步带来性能增益。
对于正在做 AI 基础设施决策的组织而言,性能、扩展效率与软件迭代速度,是决定长期推理经济性的重要考量。
一、Vera Rubin NVL72 首秀即性能领先
NVIDIA 在 MLPerf Inference v6.1 套件中两项最严苛的基准上,提交了 Vera Rubin NVL72 的预览成绩:DeepSeek-R1 与 Qwen3-VL。
在 Qwen3-VL 上,Vera Rubin NVL72 于离线(offline)、服务器(server)与交互式(interactive)三种场景下,吞吐量均最高达到 GB300 NVL72 的 3.7 倍,所用软件栈为 vLLM 搭配 NVIDIA Dynamo 开源推理框架。在 DeepSeek-R1 上,借助 NVIDIA TensorRT-LLM 库,吞吐量最高达到 GB300 NVL72 的 2.5 倍。这些早期成绩既体现了 NVIDIA 加速创新的节奏,也说明性能将随持续的软件优化继续提升。
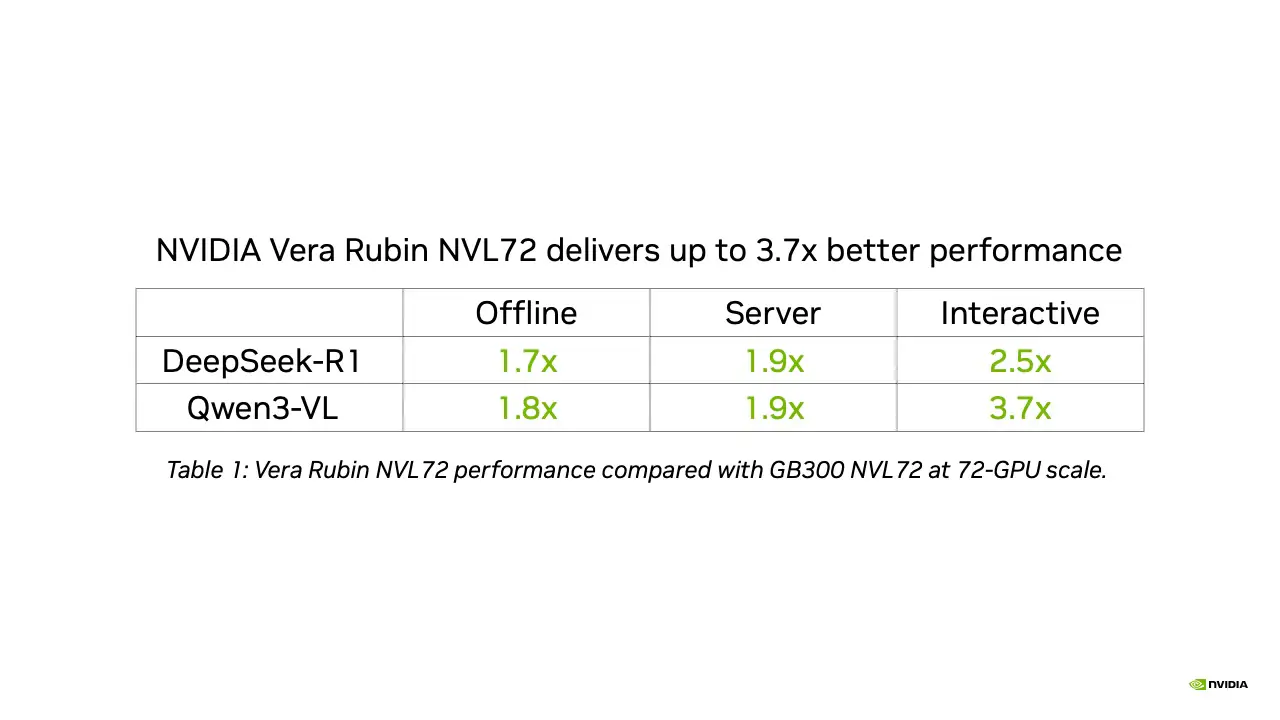
MLPerf Inference v6.1,Closed Division(封闭组)。结果于 2026 年 9 月 16 日取自 www.mlcommons.org。NVIDIA 平台成绩来自以下提交条目:6.1-0106 与 6.1-0074。MLPerf 名称与标识是 MLCommons Association 在美国及其他国家和地区的注册商标与非注册商标,保留所有权利,严禁未经授权使用。详情请见 www.mlcommons.org。
这样的性能意味着:相比一台 GB300 NVL72 机架,每台 Vera Rubin NVL72 机架可交付显著更多的 Token、服务更多用户、创造更多收入,同时降低单位 Token 成本。
这些成绩源于软硬件的全栈协同设计。Vera Rubin 增强的 Tensor Core 与 Transformer 引擎同时加速推理的预填充(prefill)与解码(decode)阶段;NVFP4 精度则降低了模型权重、注意力机制与 KV Cache 的显存占用——在输出质量几乎不受影响的前提下提升吞吐。
Vera Rubin 的提交大量采用分离式服务(disaggregated serving),将预填充与解码拆分,并结合大规模专家并行,在驱动 DeepSeek-R1、Qwen3-VL 等模型的混合专家(MoE)层上实现最高效率。
NVL72 的纵向扩展域由第六代 NVIDIA NVLink 与 NVLink Switch 支撑,报文速率是通用以太网的 10 倍、时延仅为后者的三分之一——正是这套互连基础,让上述技术在机架级规模上真正生效。
这种协同设计也延伸到 NVIDIA 的合作伙伴生态:Nebius 同样提交了 Vera Rubin NVL72 预览成绩,并展现出优异表现。
能够在多个步骤中推理、规划并执行动作的 AI 智能体,正在改变推理性能的衡量方式。在为此类转变而设计的基准中(例如 SemiAnalysis AgentX),Vera Rubin NVL72 在预览测试中的性能达到 GB300 NVL72 的 30 倍。此外,即将推出的 MLPerf Endpoints 基准将为智能体推理负载引入标准化衡量,覆盖传统吞吐基准无法反映的部分。
二、NVIDIA GB300 NVL72 以领先效率实现扩展
扩展效率——即新增 GPU 能在多大程度上转化为吞吐提升——是衡量 AI 基础设施产出能力的关键指标。NVIDIA 依靠机架内的高带宽、低时延纵向扩展互连,机架间的高带宽网络,以及跨节点的高效请求编排来实现这一点。
NVIDIA 的 DeepSeek-R1(DSR1)提交从单台 GB300 NVL72 机架(72 张 GPU)扩展至四台机架(288 张 GPU),在离线场景下实现 99% 的扩展效率,吞吐增长几乎与新增硬件成正比。
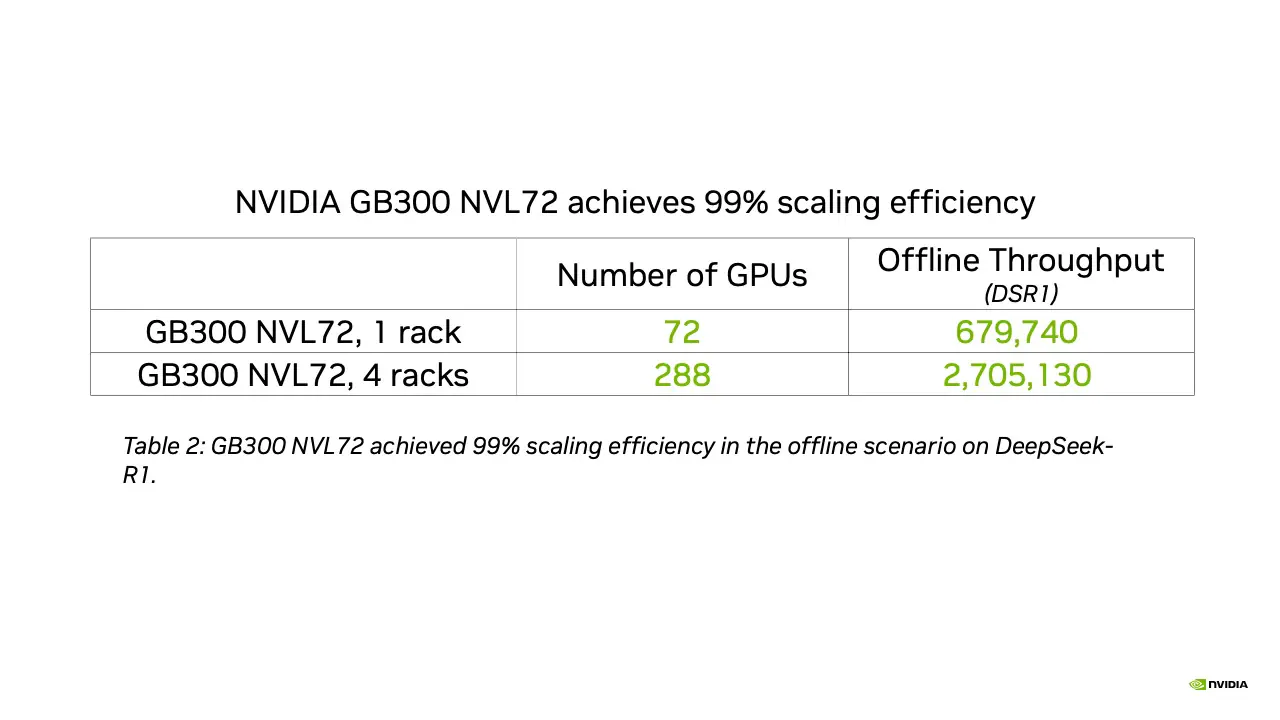
MLPerf Inference v6.1,Closed Division(封闭组)。结果于 2026 年 9 月 16 日取自 www.mlcommons.org。NVIDIA 平台成绩来自以下提交条目:6.1-0073 与 6.1-0074。MLPerf 名称与标识是 MLCommons Association 在美国及其他国家和地区的注册商标与非注册商标,保留所有权利,严禁未经授权使用。详情请见 www.mlcommons.org。
扩展效率之所以关键,是因为 GPU 数量的增加并不自动带来成比例的吞吐提升。如果 GPU 数量接近翻倍、吞吐却只提升个位数百分比,基础设施成本的增速就会远远超过性能回报。架构、互连与软件必须同步扩展。
GB300 NVL72 还在 WAN 2.2 文生视频基准上展示了机架级效率:每秒生成 0.65 段 720p 视频,单段视频耗时 5.7 秒——吞吐是单节点的 9 倍,时延比单节点低 7.5 倍。
三、软件优化带来持续性能增益
NVIDIA 平台持续进行软件迭代,不断交付性能与功能上的改进。
在 v6.1 中,GB300 NVL72 在 Qwen3-VL 上的性能较 v6.0 成绩最高提升 1.6 倍。增益来自更低的 KV Cache 精度、更多的内核融合(kernel fusion)、更优的内核实现,以及基于 vLLM 与 NVIDIA Dynamo 的分离式服务。
软件优化在 v6.1 提交截止之后仍在继续。在 GPT-OSS-120B 与 DLRMv3 上,提交后取得的、尚未经 MLCommons 验证的结果显示出进一步的性能提升。
四、覆盖各类规模的 AI 推理
除 NVIDIA Grace Blackwell 与 Vera Rubin NVL72 平台成绩之外,NVIDIA 还基于新近推出的 Edge-Agentic 基准(采用 Qwen3.6-27B),使用 NVIDIA TensorRT Edge-LLM 提交了 Jetson AGX Thor 的成绩。
NVIDIA 合作伙伴生态广泛参与,19 家合作伙伴——其中 8 家基于多节点 Blackwell NVL72 系统——均展现出优异表现,包括 ASUS、Azure、Cisco、CoreWeave、Crusoe、Dell Technologies、Fujitsu、Giga Computing、HPE、Inventec、Lambda、MiTAC Computing、Nebius、Oracle Cloud Infrastructure、Quanta Cloud Technology、Red Hat、ScitiX、Supermicro 与 Wiwynn。
从紧凑的边缘设备到规模最大的 AI 工厂,NVIDIA 通过每年一代的平台架构节奏、持续改进的软件,以及为规模化交付而构建的生态,在全技术栈上持续推进性能提升。