
在 8 个 NVIDIA DGX Spark 节点上运行前沿级 AI 模型
NVIDIA 宣布支持 8 节点 DGX Spark 集群,统一内存扩展至 1 TB,可在桌面本地运行 GLM 5.3(753B)等前沿级开源模型;优化集合通信后端令解码扩展效率提升 45%,从零预训练 8 节点加速 7.79 倍、效率 97.4%。
AI 开发者早已不满足于运行单个模型——他们并行编排多个模型、串联推理调用,并试验需要数百 GB 内存的前沿级架构。NVIDIA DGX Spark 的使命是把 AI 开发带到桌面上,而现在,你可以把更多 Spark 节点连接在一起。
在 GTC Berlin 上,NVIDIA 宣布正式支持八节点 DGX Spark 集群,把统一内存扩展至 1 TB,为前沿级模型、多智能体负载与近线性预训练打开大门——全部在本地运行。
NVIDIA Sync 让组网变得简单,其集群助手(Cluster Assistant)负责设置与设备管理。NVIDIA Sync 对八节点集群的支持将在今年年底前推出。
运行更大、更新的前沿级模型
八节点集群最大的红利是内存。单台 DGX Spark 提供 128 GB 统一内存;四节点达 512 GB;八节点达 1 TB。这一容量让一类此前无法在四节点系统上启动的模型成为可能,其中包括来自 Z.ai 的完整 GLM 5.3(753B)模型。
装得下只是第一步,这套集群的设计目标是要能交互式地服务这些模型。作为早期示例,我们在八节点集群上运行 GLM 5.3 Flash,测得生成速度约 80 Token/秒(TPS),足以支撑针对前沿级混合专家(MoE)模型的交互式本地开发。
完整的 GLM 5.3(753B)检查点(checkpoint)可在 8×128 GB 集群上运行,这使它成为可以在本地服务的最大开源模型之一。
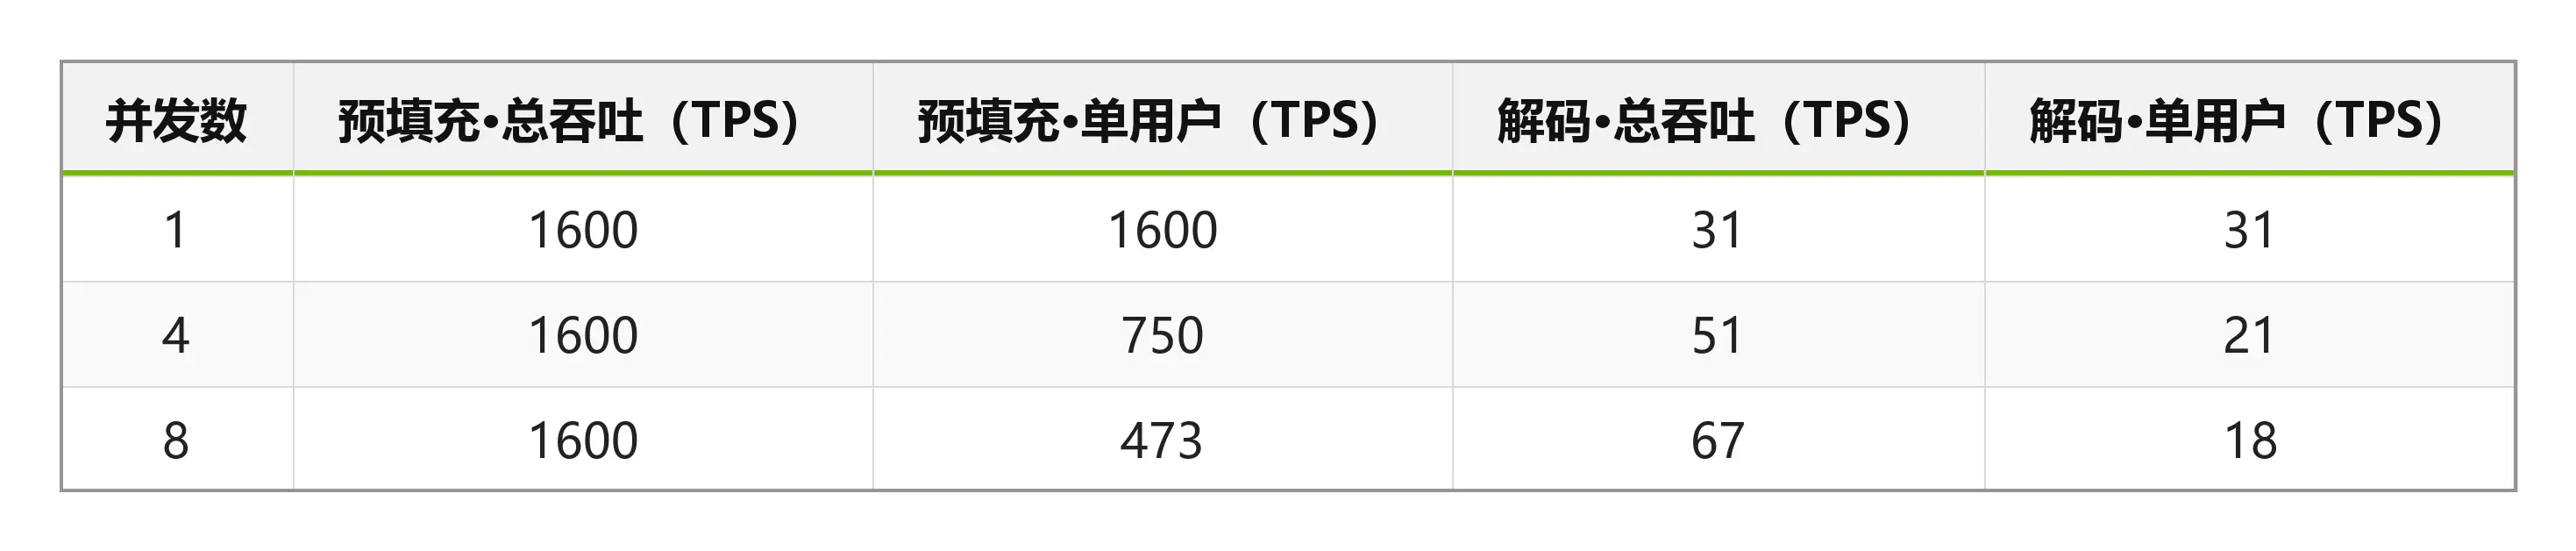
表 1:完整 GLM 5.3(nvidia/GLM-5.3-NVFP4)在八节点 DGX Spark 集群上的性能。模型 NVFP4 权重约 470 GB,以 MTP3 在并发 1、4、8 下测得;预填充按每请求 8K 输入序列长度(ISL)测量。
借助 Spark 优化后端加快集合通信
张量并行推理有相当一部分时间花在 all-reduce(全归约)等集合操作上。在交换机连接的集群上,我们一直在评估一个面向 Spark 优化的集合通信后端 RoCEnante,用于降低本地 AI 硬件上张量并行解码的典型模式——小消息、低并发、适中 rank 数——下的集合延迟。
该后端实现的是一次 all-to-all 交换加本地归约:每个 rank 把自己的输入分享给所有其他 rank,然后在本地完成加总。整个交换与归约由单个 GPU 内核协调。
主要收益是通信步骤更少。环形 all-reduce 需要多个轮次在相邻 rank 之间传递数据;这种方案直接与所有对端交换数据,避免了那条转发链。对小消息和适中的 rank 数而言,这可以降低时延。
代价是更多的数据搬运。每个 rank 都要把自己的完整输入发给每一个对端,并自行归约所有输入。随着消息规模或 rank(节点)数增长,这些额外流量变得越来越贵,环形 all-reduce 的带宽效率也就越来越有吸引力。如果需要支持高并发、更大规模集群或环形拓扑,NVIDIA 集合通信库(NCCL)的表现会更好。
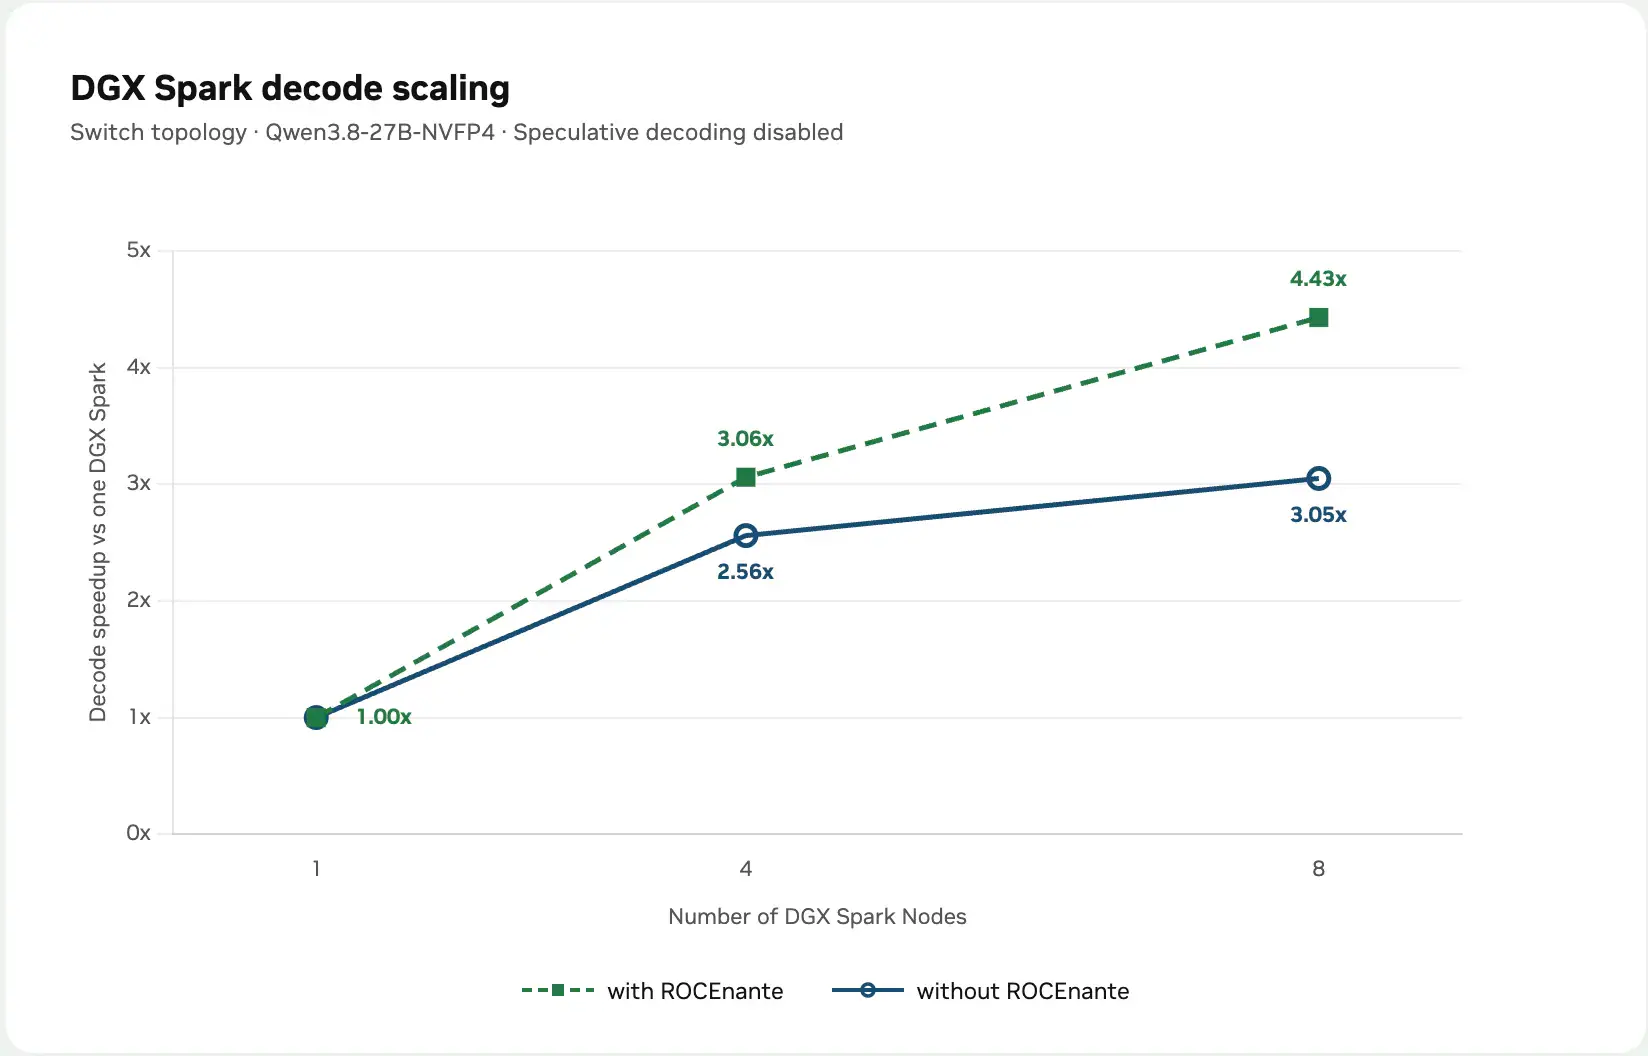
图 1:在交换机拓扑上启用与不启用 ROCEnante 的 Spark 解码扩展(Qwen3.8-27B-NVFP4,关闭投机解码)。八个 Spark 节点时,ROCEnante 加速 4.43 倍,不启用为 3.05 倍——扩展效率提升 45%。
实际测试中,四节点(NVFP4)预填充吞吐约高 5%、解码吞吐约高 21%;八节点非量化模型解码吞吐约高 18%——与上述时延对带宽的权衡一致。该后端已合并进 FlashInfer,若启动自检失败会透明回退到 NCCL。
该后端只适用于交换机连接拓扑,因为它依赖所有节点之间的直接点对点交换。它不是 NCCL 的替代品——NCCL 仍是受支持的默认选项,并且随集群规模与并发增长始终是更好的选择。最初的 one-shot all-reduce 方案由社区贡献(Jason Cook/el8)。
二、四、八:集群如何扩展
低时延的 NVIDIA ConnectX-7 网卡与基于融合以太网的 RDMA(RoCE)通信,让 DGX Spark 节点得以高效交换张量,你可以把模型扩展到更多节点上——既为了把它装进内存,也为了提升吞吐。为了隔离集群扩展行为、排除场景相关干扰,我们在一至八个节点上对稠密的 Qwen3.8-27B(NVFP4)模型做了基准测试,关闭投机解码/MTP:
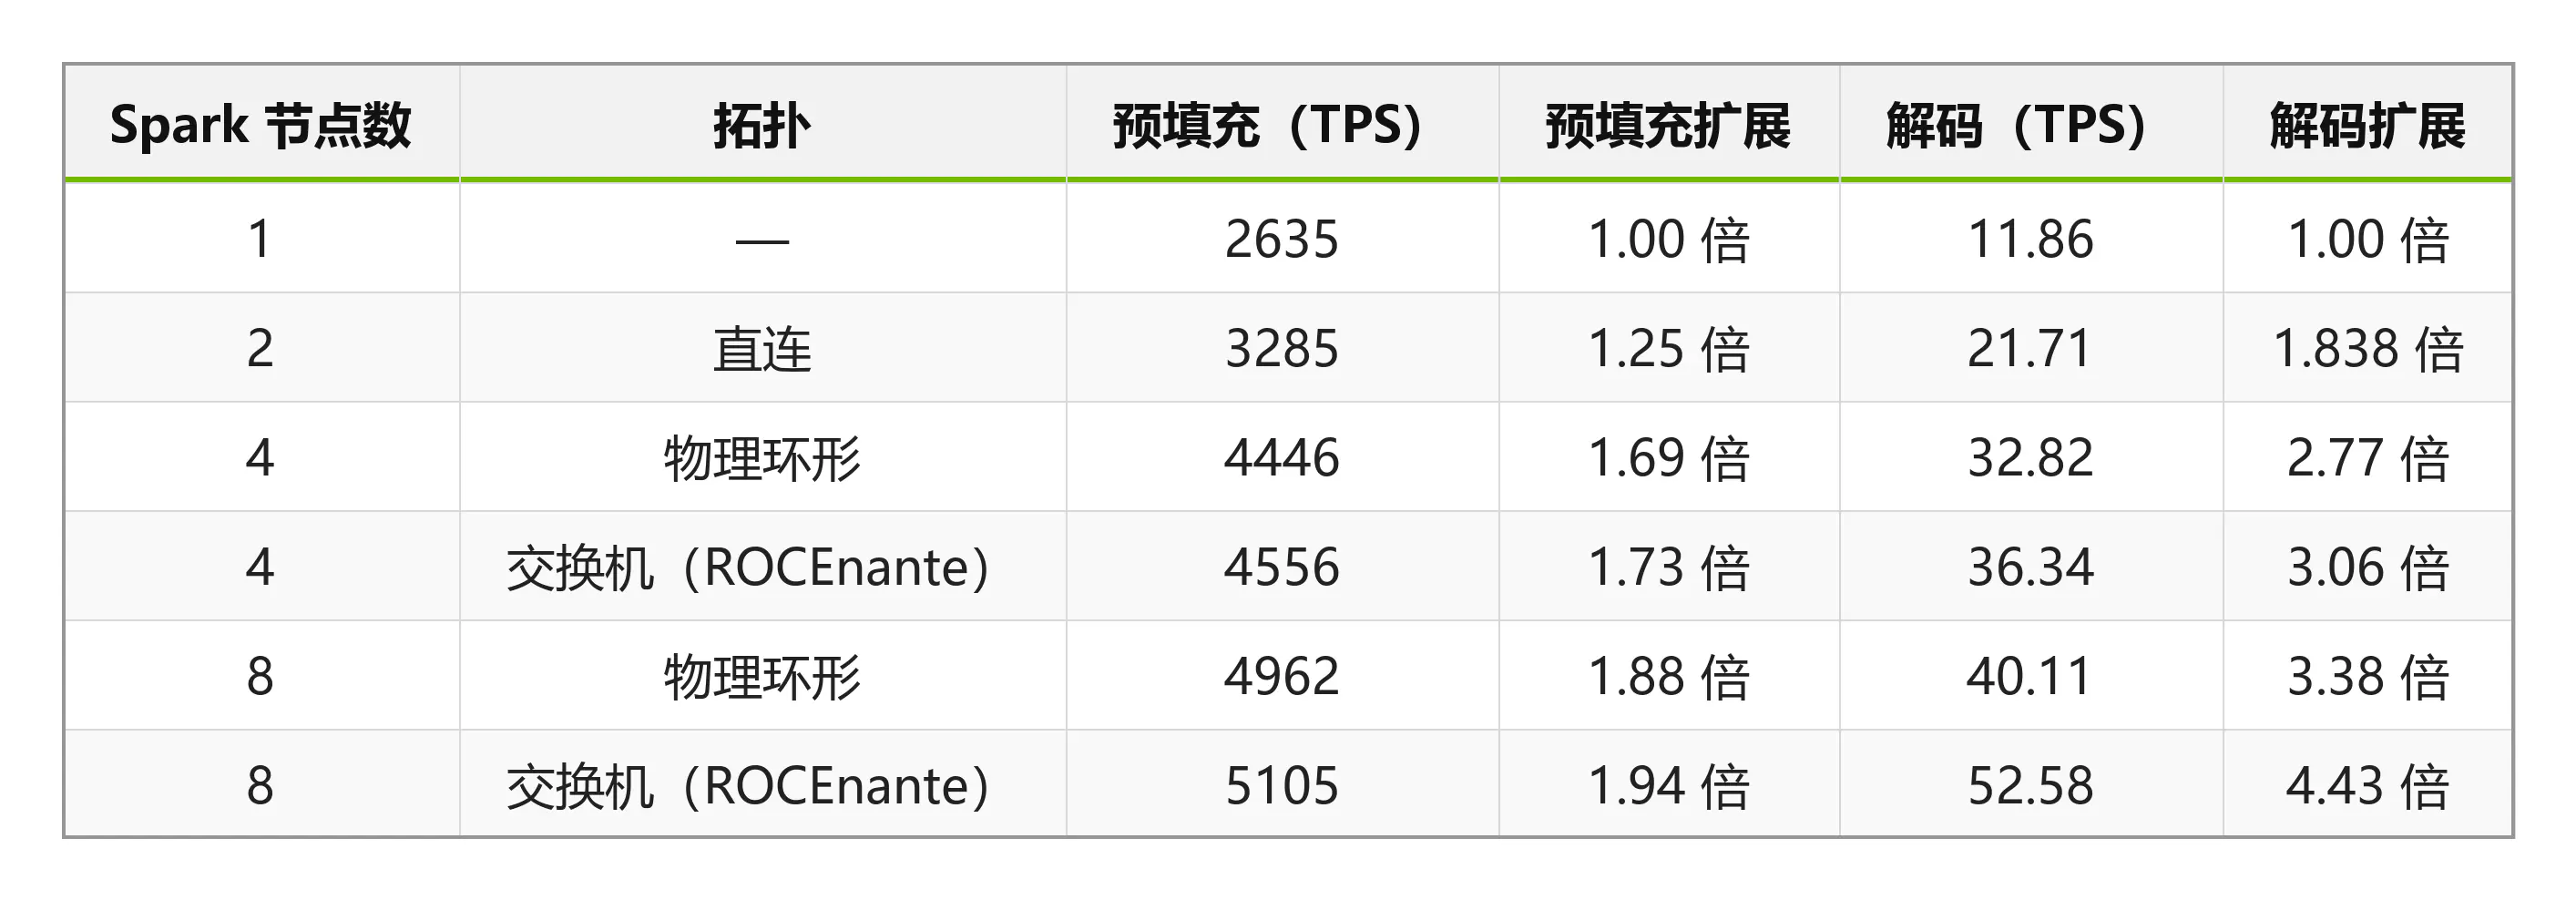
表 2:NVIDIA/Qwen3.8-27B(NVFP4)跨拓扑扩展,支持时启用 ROCEnante 后端。使用 llama-benchy 测量,ISL 8192 Token、OSL 256 Token、并发 1。扩展倍数以同精度单台 Spark 为基准。
两个规律值得关注。第一,解码吞吐量随节点数强劲扩展:单节点约 12 TPS,八节点 52 TPS。
第二,最优拓扑取决于负载:物理环形为“单个模型摊到全部节点”的场景提供出色的解码吞吐;一旦要把集群拆成独立分组,或运行需要节点间任意直连的负载,就需要交换机。
想亲手一试的话,这份组网指南从两节点配置讲起、逐步向上扩展,带你完成集群搭建。
无交换机环形拓扑与部署简便性
不是每个集群都需要交换机。DGX Spark 节点可以直接首尾相连组成环,成本低、部署简单——对发烧友和小型部署很有吸引力。
在四节点 DGX Spark 部署中,NCCL 默认采用基于环的算法做张量并行通信,无交换机环形拓扑因此与流量走向完美契合,能以更低的成本给出可观的吞吐。如表 2 所示,四节点环形在该负载的预填充与解码吞吐上表现出色。
但规模一大或用途一专,画面就变了:
- 八节点或分组使用:想把集群拆成比如两组四节点,环形拓扑表达不了这种结构,你需要交换机。
- all-to-all 与传统 HPC 负载:任何依赖点对点模式的任务(例如基于 MPI 的集群)都需要交换机,环形会付出额外的跳数开销。
- 优化集合通信后端:前文的 Spark 优化后端要求所有节点之间直接点对点连接,因此只适用于交换机配置。
一句话总结:想要最简单、最便宜的四节点推理方案,选无交换机环形;要扩展到八节点、拆分集群,或运行环形拓扑承载不了的通信模式,选交换机。
用 Switchyard 编排多模型
不是每个请求都需要你最大的模型。在一套共享的八节点集群上,把简单请求路由给小而快的模型、把大模型留给难题,可以显著提高整体吞吐。
NVIDIA NeMo Switchyard 让这件事落地:一个轻量分类器检查每个请求(或会话),把它路由到合适的模型池,再由负载均衡器把流量分摊到各副本。由于这种布局把八个节点拆成相互独立的模型池,Switchyard 需要运行在交换机连接的集群上——跨副本路由请求所需的任意节点互连,正是交换机提供的。
在原型中,我们用 OpenBMB 的 MiniCPM5 2B 充当分类器并处理简单任务,复杂任务交给 Qwen3.8 Flash Next。在一个标准加困难档的工具调用基准上,路由智能体拿到了与纯 Qwen 配置持平的质量,同时释放了集群容量。
在 92 例工具调用基准(含困难档)上,路由智能体得分 91/100,与纯 Qwen 配置持平。
MiniCPM 单副本每秒承接的请求数大约是 Qwen 的一个数量级,把一部分流量转移给小模型,等于抬高了整个集群的吞吐上限。把三个 Qwen 副本(每个占两台 Spark 节点)和两个 MiniCPM 副本(各占一台 Spark)铺到八个节点上,结果如下:
- 一半请求路由给 Qwen 时,聚合吞吐约为纯 Qwen 基线的 1.5 倍。
- 四分之一请求路由给 Qwen、其余给 MiniCPM 时,聚合吞吐约为 3.0 倍。
路由策略就是一个简单的 YAML 文件,NVIDIA 提供了示例策略作为起点;开发者可以按自己的负载调整分流比例与分类器。
从零预训练:nanochat 的近线性扩展
训练的行为与推理不同。当每个节点持有模型的完整副本时,唯一的跨节点通信是每步一次的梯度同步,因此集群扩展接近线性。为了演示,我们从零预训练了一个 nanochat 模型(约 8.965 亿参数、20 层 Transformer、隐藏维度 1280、序列长度 2048 Token),并测量随节点数增加的训练吞吐。
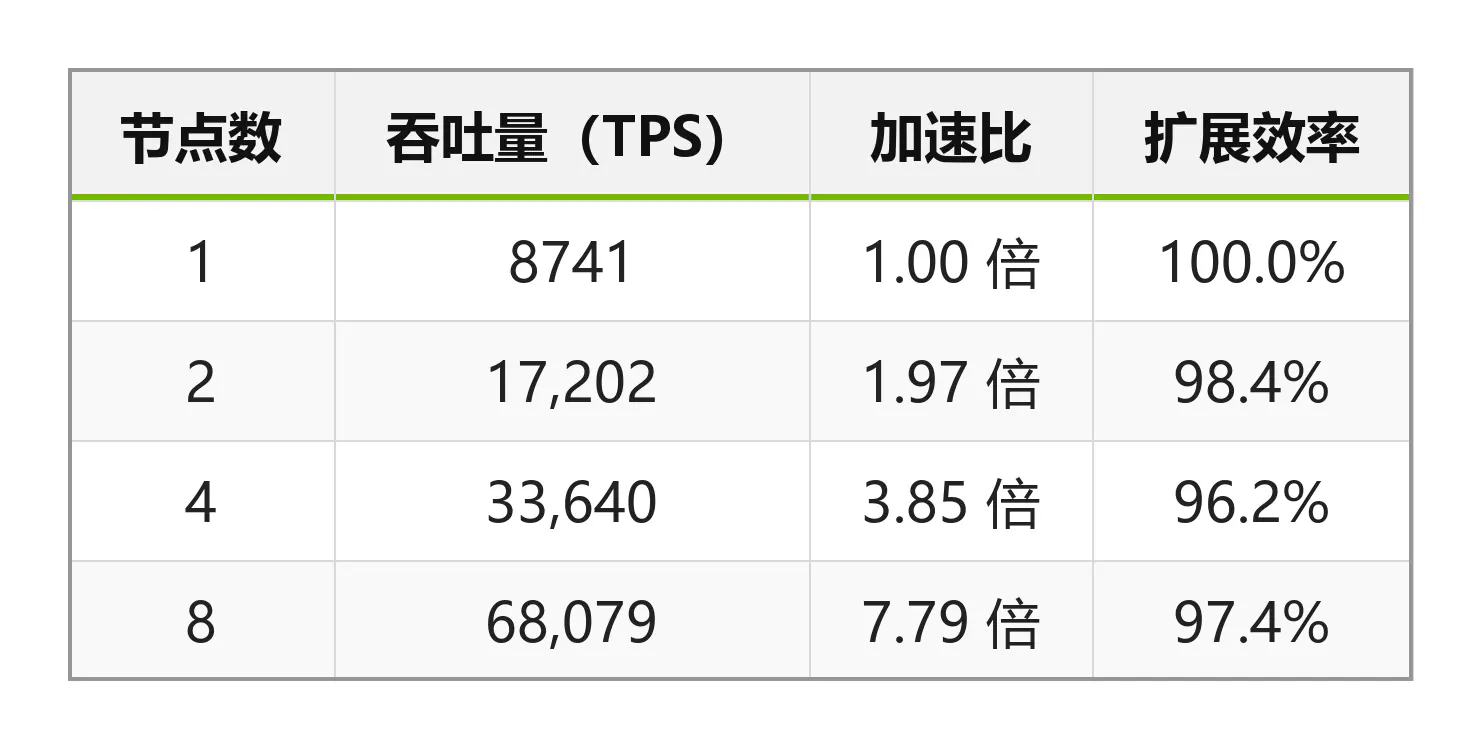
表 3:nanochat 预训练吞吐量从 1 到 8 个 DGX Spark 节点的扩展(每步全局批量 524,288 Token,每个 GPU 微批量 32 条序列)。
八个节点带来 7.79 倍加速、效率 97.4%——这种近线性扩展,让八节点 Spark 集群成为一个可信的“从零训练小模型”平台,而不只是服务大模型。它也是一条自然的进阶路径:先在本地做原型与预训练,再随模型长大向外扩展。
作为AI原生的基础设施产品和全栈方案提供商,以及NVIDIA Compute(计算)与Networking(网络)双Elite精英级合作伙伴,超擎数智支持NVIDIA DGX Spark现货在仓、快速交付,并针对四台及八台集群规模,完整打通高速组网调优、分布式推理部署、开源模型适配到本地智能体联调的工程链路,让企业跳过繁琐的底层磨合,直接进入业务应用阶段。