技术博客
沉淀 AI 算力、无损网络、高速互联、集群验收和 AIDC 工程实践,帮助团队更快识别问题、验证方案和复用经验。
驾驭 SSD “荒年”:AI 推理如何重塑云存储服务与 NAND 产业格局
AI推理从后台走向大规模商用,彻底打破NAND闪存行业延续多年的消费电子周期规律。2026年数据中心需求历史性反超智能手机,成为NAND最大下游市场,SSD从传统冷数据仓库升级为AI推理KV缓存的核心扩展层,云存储服务与NAND产业格局随之迎来深度重塑。

什么是 AI 工作负载?
本文系统解析AI推理工作负载的定义、类型与工作原理,梳理其快速增长的驱动因素,并对比训练与推理差异,进一步说明其在性能、成本与规模化落地中的关键作用及对应硬件基础。
光学Shuffle架构:超大规模AI GPU集群高效扩容的关键底座
随着AI GPU集群从万卡向十万卡级规模演进,传统电交换架构下海量光纤布线拥堵、空间占用超标、运维难度指数级上升的问题彻底暴露。光学Shuffle架构依托无源ShuffleBox器件完成高密度光纤的精准重排与路由调度,无需光电转换开销,大幅压缩机柜占用空间、简化部署流程,成为超大规模AI GPU集群实现高效平滑扩容的核心底座。
NVIDIA RTX PC 与 DGX Spark 加速由 Hermes 解锁的自主进化 AI 智能体
Hermes是全球热度最高的开源自主进化AI智能体框架,依托NVIDIA RTX PC的Tensor Core推理加速能力与DGX Spark全天候算力底座,实现技能自主迭代、子智能体隔离调度、全流程本地私密运行,在端侧即可获得比云端方案更低延迟、更高可靠性的智能体使用体验。
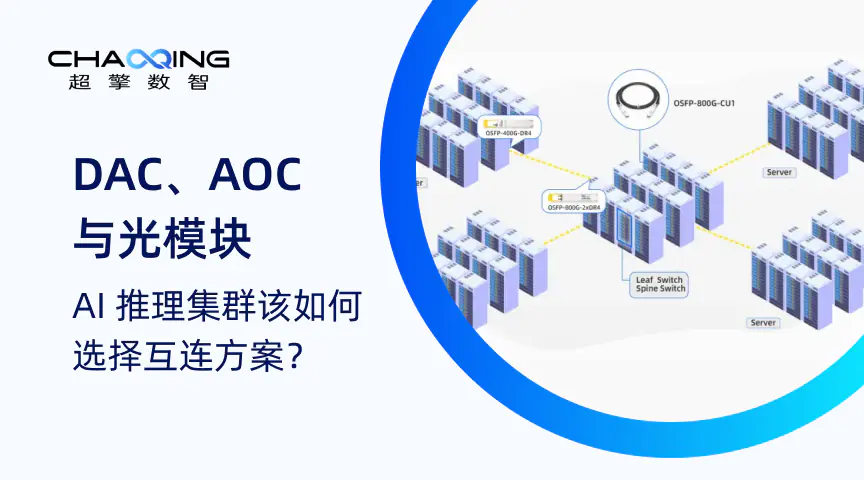
DAC、AOC 与光模块:AI 推理集群该如何选择互连方案?
在AI推理集群中,互连方案的选择直接影响系统性能与扩展能力。本文对比DAC、AOC与光模块的差异,并提供基于距离、成本与架构的分层选型策略。
为何全球头部自动驾驶企业均采用 VAST Data 平台
自动驾驶企业在海量路采视频、点云数据的采集、清洗、标注、模型训练全流程中,长期被传统存储架构的性能割裂、数据孤岛、扩容滞后等问题困扰。VAST Data平台依托独创的DASE分解式全共享架构,以统一命名空间承载全类型非结构化数据,为自动驾驶数据飞轮提供持续稳定的高带宽供数能力,支撑百万级GPU规模下的智驾模型高效迭代,成为全球头部自动驾驶企业的共同选择。
大规模 AI 推理工作负载面临的五大挑战
AI Inference Workloads规模化部署正面临内存瓶颈、时延压力与高并发通信等核心挑战。本文围绕推理系统的关键瓶颈,解析内存优化、低时延互联及新型硬件架构等主要技术方向。
破局万卡集群网络拥塞:NVIDIA Spectrum-X 搭载 MRC 协议重塑超大规模 AI 互联
万卡级AI训练集群长期受网络拥塞、链路抖动、训练中断的困扰,GPU空转损耗居高不下。NVIDIA Spectrum-X平台搭载全新MRC多路径可靠连接协议,通过多路径动态分流、微秒级故障旁路能力,让集群可平滑扩展至数十万个GPU规模,彻底突破超大规模AI互联的性能瓶颈。
优化 AI 推理工作负载:降低时延、提升吞吐并控制成本
AI 推理系统需要在时延、吞吐和成本之间取得平衡。本文从模型压缩、KV Cache、批处理、互连网络和硬件选型等角度,解析如何优化大规模推理工作负载。