技术博客
沉淀 AI 算力、无损网络、高速互联、集群验收和 AIDC 工程实践,帮助团队更快识别问题、验证方案和复用经验。
常见光模块故障原因与保护措施
本文系统梳理光模块在高速数据中心和AI集群中的常见故障原因——包括ESD损伤、光口污染、劣质连接器、器件老化、兼容性问题和环境压力,并提供对应的保护措施与选型建议,帮助提升链路稳定性与运维效率。

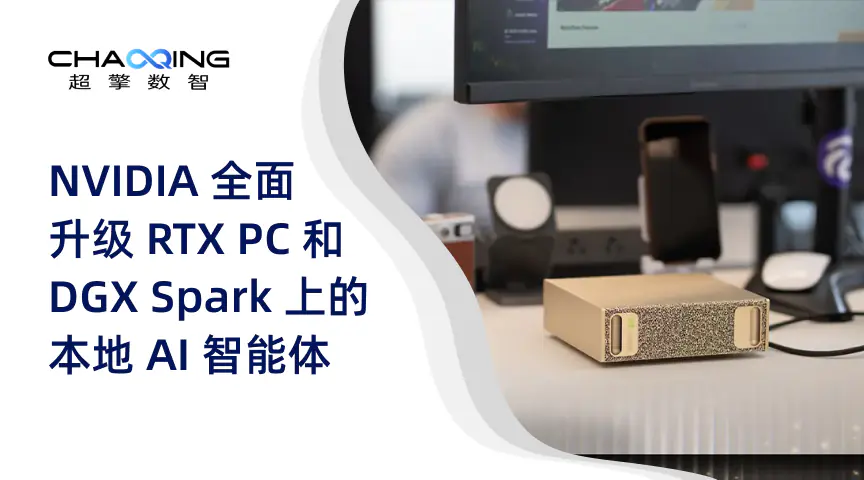
NVIDIA 全面升级 RTX PC 和 DGX Spark 上的本地 AI 智能体
NVIDIA在GTC台北大会上全面升级RTX PC与DGX Spark本地AI智能体体系,联合微软推出OpenShell安全运行时,实现llama.cpp推理性能最高2倍加速,依托统一内存架构与多GPU优化,让端侧设备可私密、低延迟运行百亿参数智能体,完成从消费级PC到桌面超算的全场景本地智能体算力覆盖。
为什么大型 AI 集群需要 Optical Shuffle 架构实现高效扩展
大模型训练与AI推理持续向超大规模演进,GPU集群正从万卡迈向十万卡。传统布线已无法满足高密度全互联需求,Optical Shuffle架构通过物理层光通道重排实现扁平化互联,成为超大规模AI网络的核心基础能力。
面向800G/1.6T时代,MMC跳线如何重塑AI数据中心互联底座
随着AI数据中心全面向800G、1.6T高速光互联时代演进,传统MPO跳线逐渐遭遇面板芯数密度、链路损耗管控与部署空间瓶颈,MMC微型多芯跳线凭借仅为传统MPO四分之一的体积、更低插入损耗与更高端口适配性,完美适配51.2T/102.4T高密度交换机布线需求,为下一代智算集群重构高密、高效、可平滑升级的互联底座。
释放 GPU 算力极限:VAST “三位一体”架构破局 AI 推理瓶颈
大模型推理规模化落地中,传统分层存储架构导致GPU频繁空转,算力利用率被严重限制。VAST推出"三位一体"全新架构,通过全路径GPU加速、持久化推理记忆、无分层统一存储三大核心设计,彻底打破存储I/O瓶颈,让向量检索从秒级降到毫秒级,支撑十亿级上下文窗口低延迟推理,真正释放GPU的完整算力潜能。
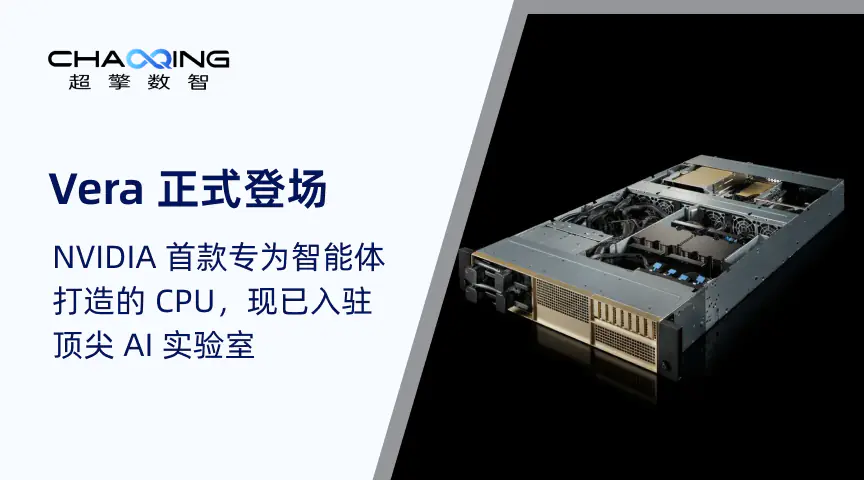
Vera 正式登场:NVIDIA 首款专为智能体打造的 CPU,现已入驻顶尖 AI 实验室
NVIDIA正式推出首款专为AI智能体场景定制的Vera CPU,搭载88颗自研Olympus核心与1.2TB/s LPDDR5X高带宽内存,单芯片架构消除跨芯粒延迟,智能体工作负载性能较传统x86处理器最高提升6倍,目前已率先入驻OpenAI、Anthropic、SpaceX AI等全球顶尖AI实验室,为大规模智能体部署提供全新算力底座。
能跑测试不等于能跑生产:AI基础设施的真实可用性门槛
在数据中心和AI基础设施建设中,“测试通过”往往只验证了受控条件下的基本功能,而生产环境要求的是长期稳定、高负载一致性和故障快速恢复能力。本文分析了为什么“能跑测试”不等于“能跑生产”,以及如何评估基础设施是否真正具备生产可用性。
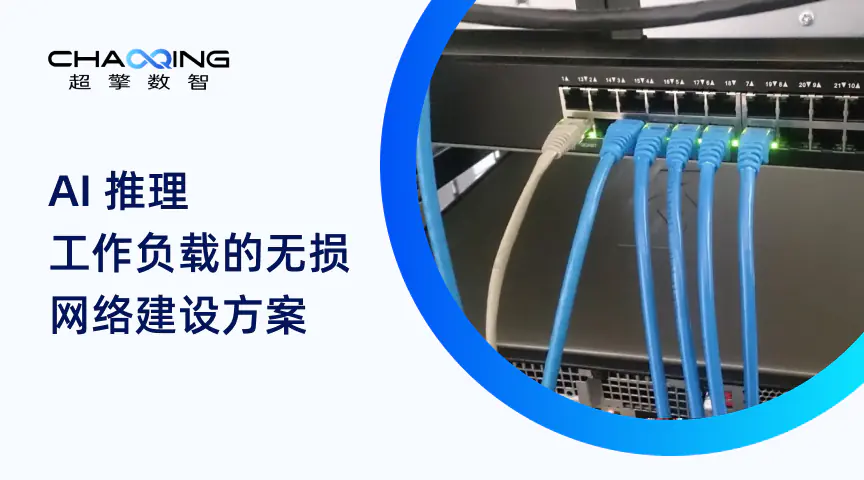
AI 推理工作负载的无损网络建设方案
AI 推理集群对低时延、稳定吞吐和多网络协同提出更高要求。本文围绕计算网络、管理网络和存储网络的分层设计,解析如何构建面向推理工作负载的高性能无损网络。
51.2T交换机选型指南:64×800G VS 128×400G,如何构建更适合AI集群的高速网络底座?
51.2T交换机已是下一代AI数据中心主流基准,64×800G与128×400G两款同容量方案在端口粒度、互联成本、扩展灵活性上差异显著。本文结合训练、推理集群实际场景拆解选型边界,帮你构建兼顾当下需求与1.6T演进空间的AI高速网络底座。