技术博客
沉淀 AI 算力、无损网络、高速互联、集群验收和 AIDC 工程实践,帮助团队更快识别问题、验证方案和复用经验。
224G SerDes 如何在不增加通道数量的前提下实现 1.6T 网络能力
224G SerDes是1.6T网络实现的关键技术,通过将单通道速率从112G提升至224G,在不大幅增加通道数量和系统复杂度的前提下实现带宽翻倍,为AI数据中心迈向更高带宽、更高密度和更高能效提供基础支撑。

消除数据与算力壁垒 积极拥抱智能体时代
本文结合2026年AI智能体产业规模化落地的行业趋势,梳理当前企业面临的数据孤岛、算力调度不均等核心痛点,给出破除壁垒、高效布局智能体业务的可落地实施路径。
1.6T 网络为何成为下一代 AI 集群核心
本文从大模型训练数据同步延迟、AI智能体多节点协同带宽需求出发,解析1.6T网络替代800G网络成为下一代AI集群核心组网方案的底层技术逻辑与全链路部署要点。
MRC协议开源:两层交换机如何连起13万块GPU
本文完整还原MRC协议从技术研发到开源落地的全链路背景,深度拆解其将单条800G链路拆分为8条100G并行子链路的核心设计,解析其替代传统3-4层Clos拓扑、仅用两层交换机即可实现13.1万块GPU全无阻塞互联的架构原理,同时梳理该协议在大模型训练场景下微秒级绕开链路故障、消除路由收敛抖动的实际生产验证效果,为企业下一代超大规模智算集群的组网选型提供可落地的前沿参考。
适用于 AI 集群的 Broadcom Tomahawk 5 交换机的主要替代方案
本文以Broadcom Tomahawk5交换机性能为基准,梳理适配AI集群的三大主流替代方案,为智算组网选型提供可落地参考。
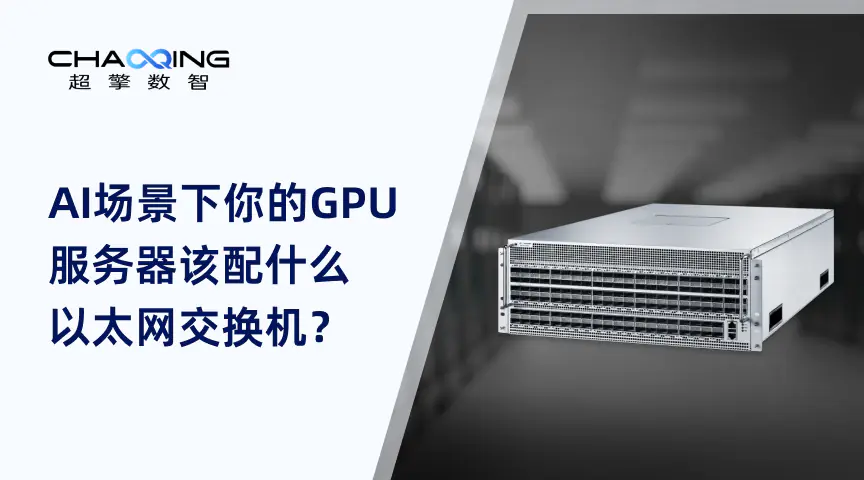
AI场景下你的GPU服务器该配什么以太网交换机?
本文结合AI训练与推理场景的带宽、时延需求,梳理GPU服务器适配以太网交换机的核心选型维度,为智算集群组网提供实用参考。
超擎实测|如何加速具身智能开发?基于RTX PRO 5000的强化学习全流程验证
本文通过实测验证RTX PRO 5000 72GB大显存平台,可高效承载具身智能场景下强化学习从仿真环境到策略训练的全流程开发需求。
为什么现在值得考虑 Spectrum-4 51.2T 交换机用于 AI 网络
本文结合当前AI集群组网落地现状,分析Spectrum-4 51.2T交换机适配AI网络的核心优势,为智算中心交换机选型提供实用参考。
NVIDIA Vera CPU正式交付,1.6T光互联需求加速释放
本文解析NVIDIA Vera CPU正式交付后,AI集群算力协同架构升级对全链路带宽的提升需求,梳理1.6T光互联产业加速落地的核心驱动逻辑。