新闻动态
在 8 个 NVIDIA DGX Spark 节点上运行前沿级 AI 模型
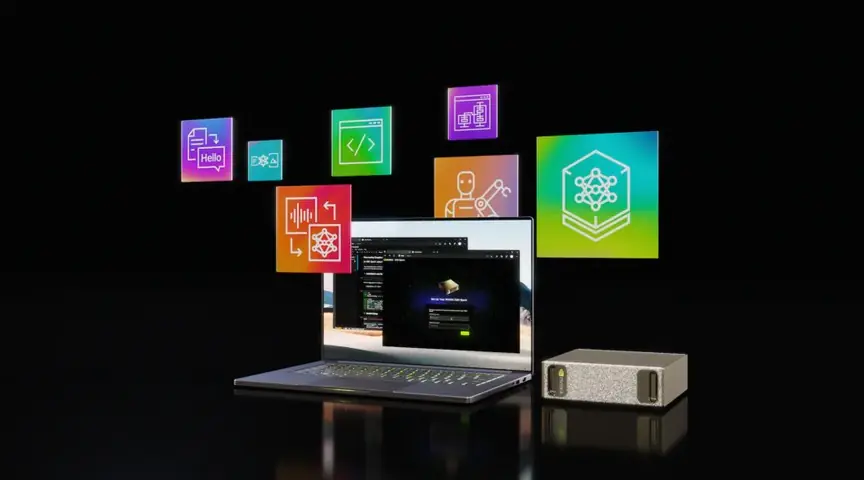
NVIDIA 宣布支持 8 节点 DGX Spark 集群,统一内存扩展至 1 TB,可在桌面本地运行 GLM 5.3(753B)等前沿级开源模型;优化集合通信后端令解码扩展效率提升 45%,从零预训练 8 节点加速 7.79 倍、效率 97.4%。

Vera 尽显双重优势:兼具最高吞吐量与最快智能体性能
AI 智能体在 GPU 推理与 CPU 执行间反复切换,电力成为 AI 工厂的核心约束。NVIDIA 在 100 兆瓦数据中心对比测试中发现:与速度最快的 x86 CPU 相比,Vera 在同等功耗下可支持多 1.6 倍的智能体;与能效最高的 x86 CPU 相比,智能体执行速度提升 2 倍。Perplexity、DeepInfra、ClickHouse、Daytona、Modal 等六家厂商已在真实负载中完成实测背书。
两台桌面设备,承载一个科室的“数字员工编制”
听微 (上海) 科技的数字员工产品 createrole,基于两台 NVIDIA DGX Spark(GB10 Grace Blackwell、128GB×2 统一内存、ConnectX-7 200GbE 直连)组成桌面集群,本地部署 Qwen、GLM、DeepSeek 开源权重模型,采用 NVFP4 低精度权重与投机解码加速,单请求上下文约 100 万 token,为不能上云的政企客户实现“当天开箱、拔线可用”的私有化交付。
选择你的第一个本地 AI 项目
本地 AI 让敏感数据不出内网、节省云成本、可离线运行。这份 NVIDIA 指南基于 RTX PRO 工作站(单卡最高 96 GB 显存)给出三个上手项目:ChatRTX 无代码 RAG 聊天机器人、本地 PDF 转播客、视频搜索与摘要智能体。
Paper2Gal 基于 NVIDIA DGX Spark,打造论文视觉小说式学习体验
Paper2Gal 把论文与文档转成视觉小说式学习内容。针对扫描件、多栏公式与跨页表格的解析难题,它基于 NVIDIA DGX Spark 构建本地 AI 环境,用一台桌面设备完成论文解析、剧情生成、互动问答与 TTS 语音验证。
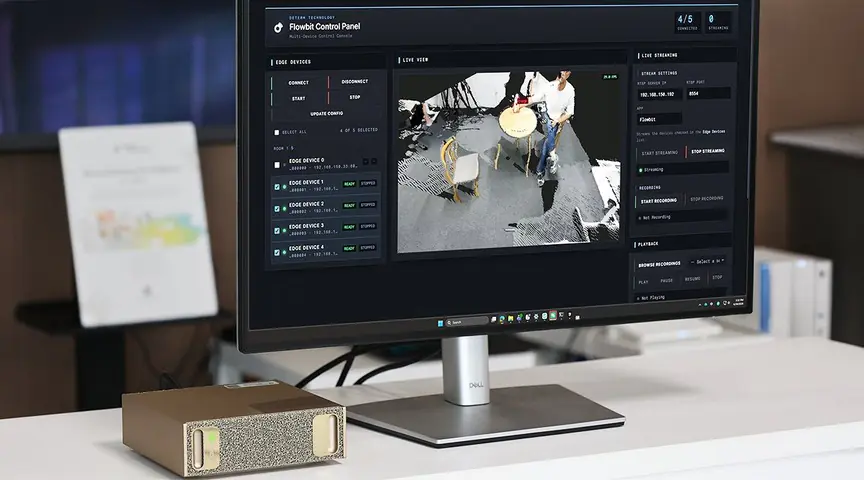
借助 NVIDIA DGX Spark 加速 3D 视觉全流程,及拓科技构建面向物理 AI 开发与落地的本地化平台
及拓科技基于 NVIDIA DGX Spark 构建本地化 3D 视觉与物理 AI 平台:GB10 Grace Blackwell 架构、20 核 Arm 处理器、128 GB 统一寻址内存,让 Flowbit Engine、Flowbit SpatialSeg、Flowbit SpatialTag 在同一台桌面级设备上协同运行,打通点云串流、3D 智能分割、开放词汇语义标注与现场部署全流程。
为 Vera Rubin 而生:NVIDIA Spectrum-6 亮相超大规模 AI 工厂
NVIDIA Spectrum-6 以太网交换系统容量为上一代 2 倍,作为 Vera Rubin 平台的组成部分进入超大规模 AI 工厂,CoreWeave、Microsoft 等率先引入;10 万张 GPU 以上部署网络效率最高 95%。
TrendForce:2027 年服务器 CPU 出货量预计同比增长逾 40%,Arm 架构产品份额持续攀升
TrendForce 预计服务器 CPU 出货量 2026 年同比增长 31%、2027 年增长逾 40%;AI 智能体推高推理负载,CPU 与 GPU/ASIC 配比从 1:8 转向 1:2,Arm 架构份额 2027 年将达约 30%。
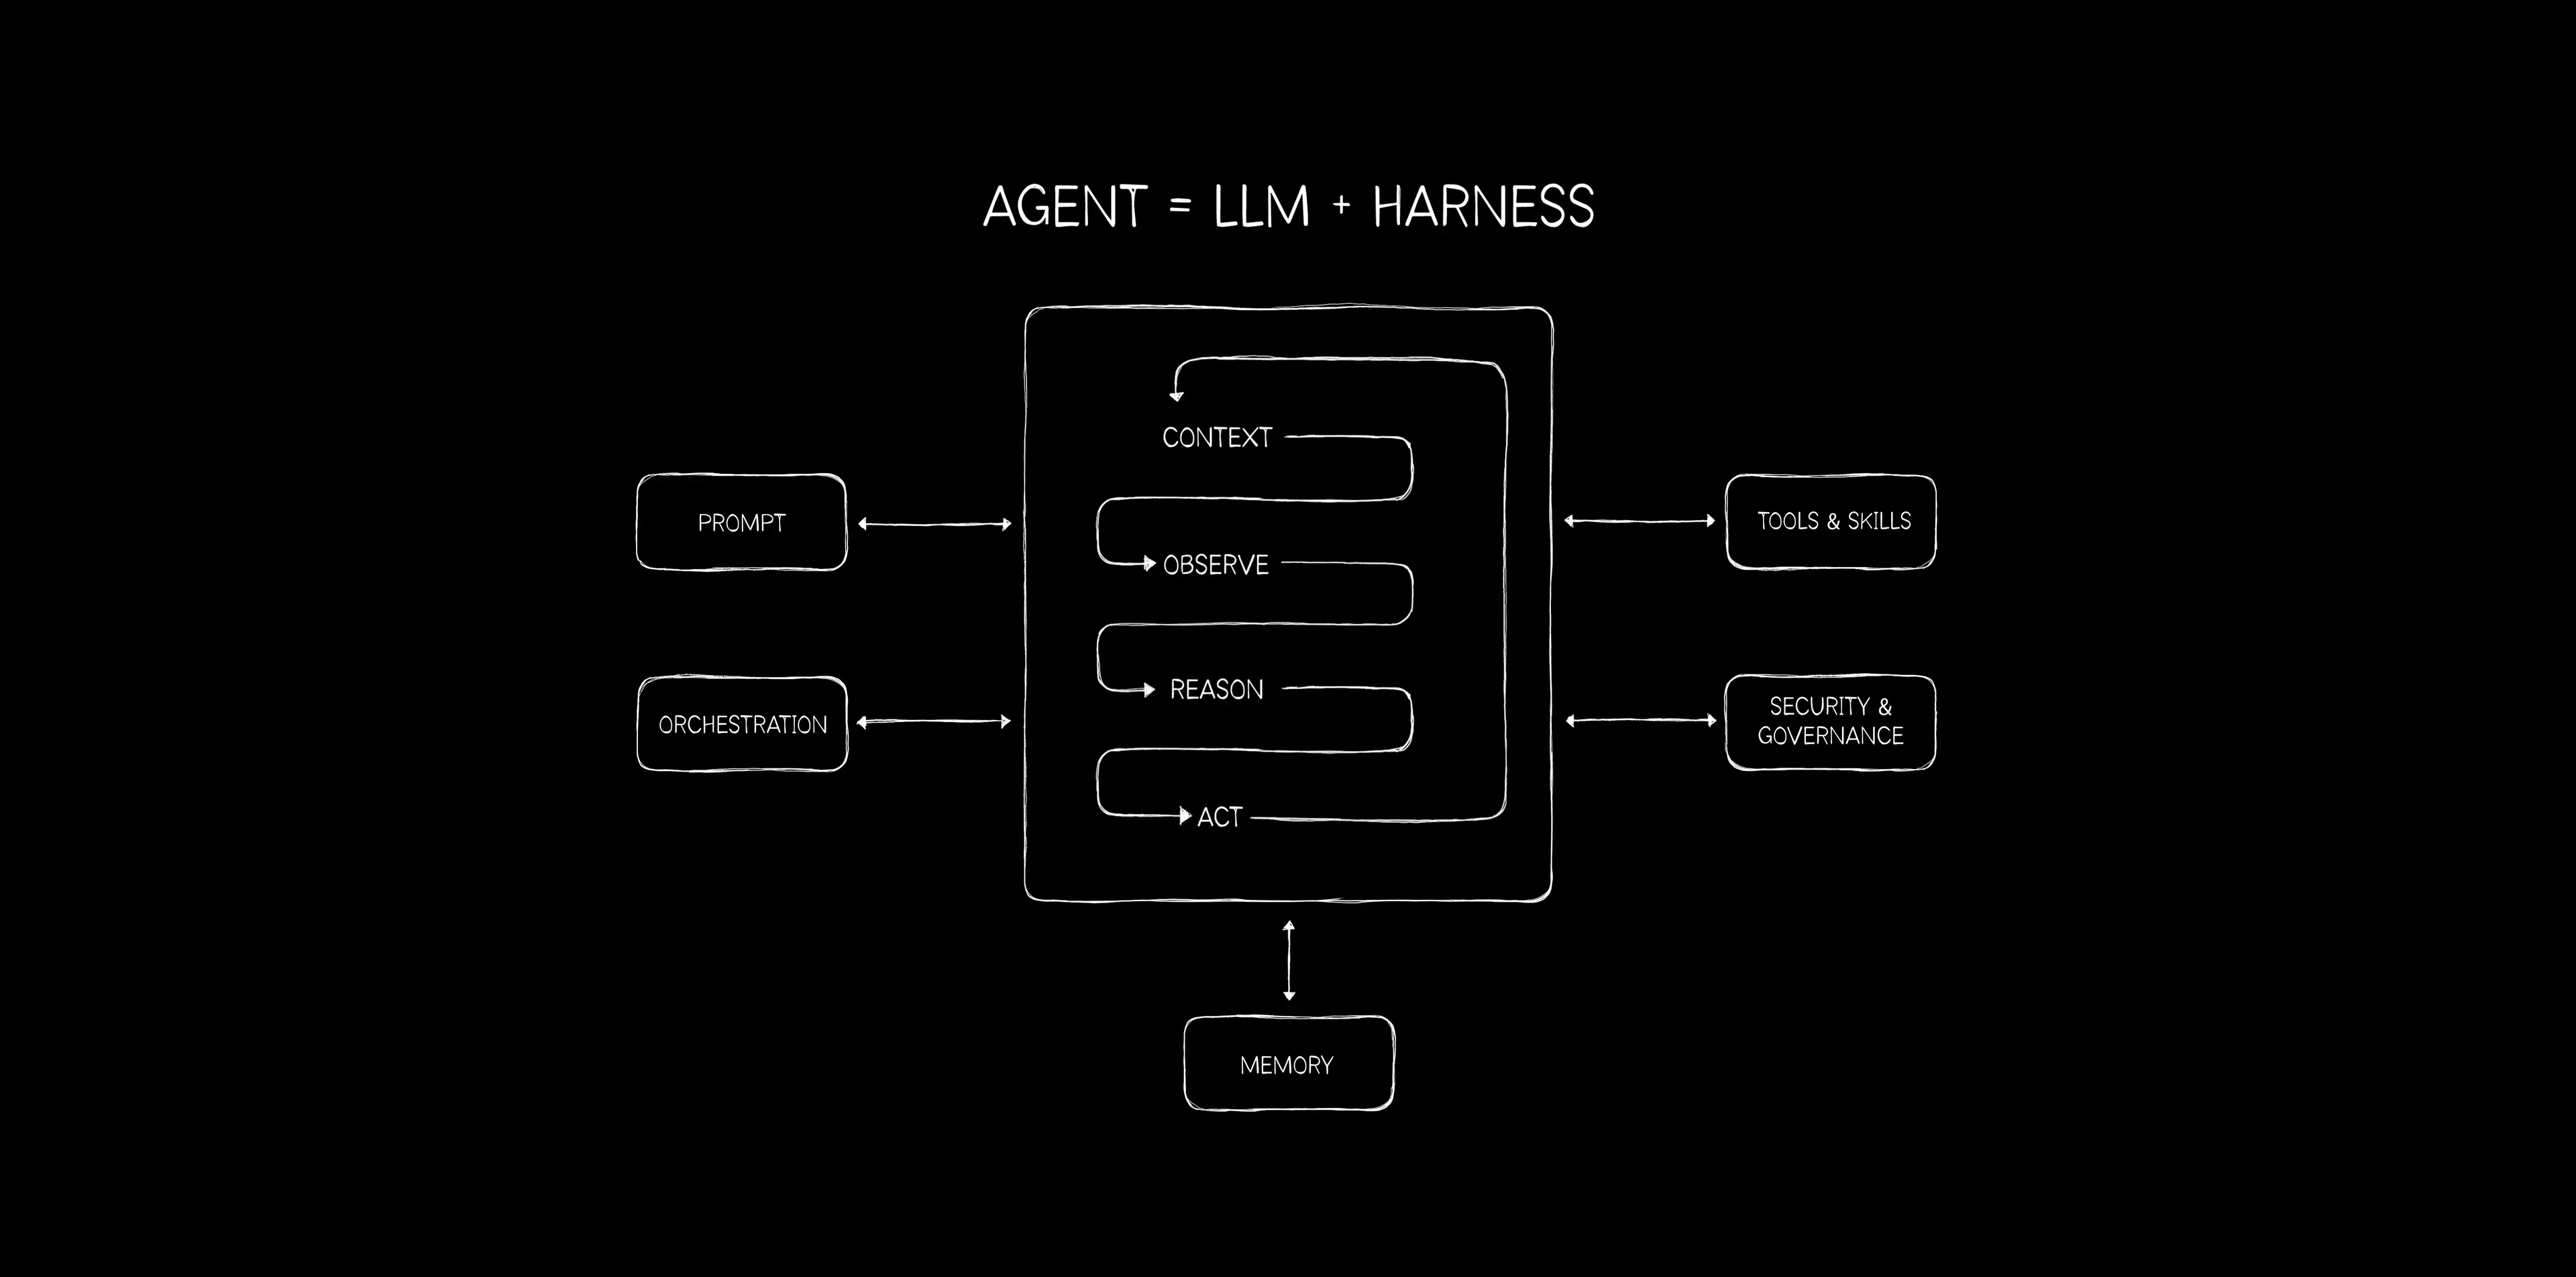
NVIDIA Blackwell 在首个智能体 AI 基础设施基准中领跑
业界首个智能体 AI 基准 AgentPerf 首轮结果:以 DeepSeek V4 Pro 测试,NVIDIA GB300 NVL72 每兆瓦可运行的智能体数量最高为 HGX H200 的 20 倍;工具调用以 CPU 时间模拟。