技术博客
沉淀 AI 算力、无损网络、高速互联、集群验收和 AIDC 工程实践,帮助团队更快识别问题、验证方案和复用经验。
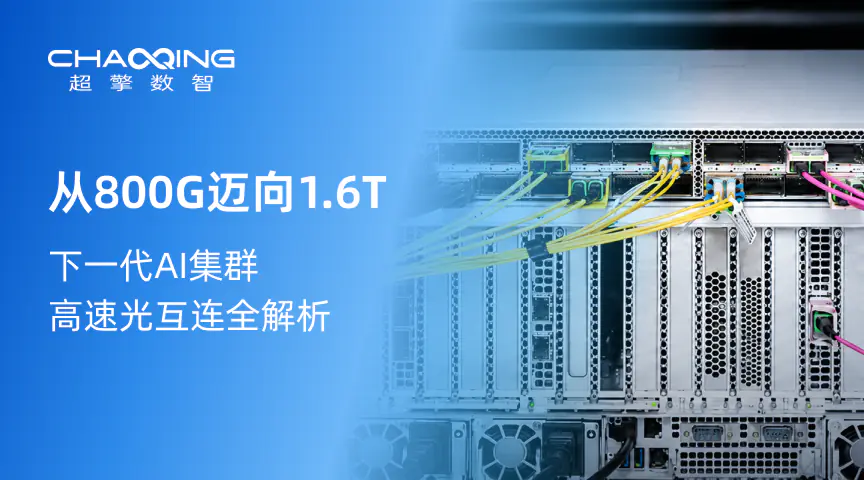
从800G迈向1.6T:下一代AI集群高速光互联全解析
随着大模型参数规模与训练集群规模持续增长,800G 光互联正快速成为下一代 AI 集群的带宽瓶颈。1.6T 光互联作为下一代演进方向,单端口速率相比 800G 翻倍,依赖 224G SerDes、可插拔光模块(OSFP/QSFP-DD)、MPO 高密度布线与新一代交换机 ASIC 的同步升级。本文系统梳理 1.6T 光互联的演进时间表、关键技术规格、与 AI 集群 Scale-out / Scale-up 网络的部署匹配度,并结合超擎数智在 800G → 1.6T 算网演进路径上的方案积累,给出企业级 AI 集群光互联规划建议。

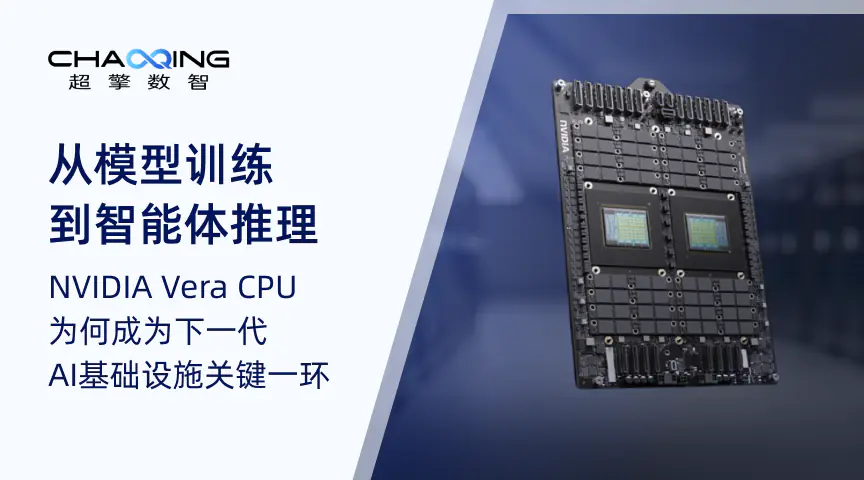
从模型训练到智能体推理:NVIDIA Vera CPU为何成为下一代AI基础设施关键一环
随着 AI 负载从模型训练向智能体(Agentic AI)推理演进,AI 基础设施的瓶颈正从 GPU 算力转向主机侧的数据编排与调度能力。NVIDIA Vera CPU 作为 NVIDIA 自研的下一代数据中心 ARM CPU,与 Rubin GPU 组成 Vera Rubin 平台,针对数据搬运、智能体推理、安全隔离与多模型编排等场景做了专项优化。本文系统梳理 Vera CPU 的架构定位、与上一代 Grace 的差异、在 AI 工厂中的角色,以及从模型训练到智能体推理全流程中 CPU 承担的关键作用。超擎数智同步提供基于 Vera Rubin 平台的下一代 AI 基础设施规划与部署服务。
重磅解构 | 解锁Kimi K3极致性价比,超擎数智企业级本地大模型全栈解决方案实践
随着开源与国产大模型能力快速提升,越来越多企业希望把高性能大模型落到自己的机房里。超擎数智重磅解构 Kimi K3 的企业级本地化实践:围绕模型选型、量化压缩、推理加速、算力整机配置、集群调度与运维托管,给出一套端到端的全栈解决方案。方案在保证推理性能与数据安全的前提下,显著降低单位 Token 的成本,解锁本地大模型的极致性价比。本文详解方案架构、关键技术环节与典型落地场景,企业用户可联系超擎数智获取方案咨询与 PoC 测试。
NVIDIA Spectrum-6 专为 Vera Rubin 打造,登陆十亿瓦级 AI 工厂
NVIDIA 正式发布 Spectrum-6 高性能以太网交换机平台,专为下一代 Vera Rubin 平台打造,单芯片提供 102.4T 交换容量,全面对接十亿瓦级 AI 工厂与超大规模集群的组网需求。Spectrum-6 在端口密度、能效比、RoCE 优化与 AI 任务调度等方面全面升级,与 Vera Rubin GPU 形成 Scale-out 网络的协同设计。本文系统梳理 Spectrum-6 的关键规格、技术亮点、与 Spectrum-4 的代际差异,以及它在 AI 工厂中作为网络底座的核心价值,并结合超擎数智在高性能算网方向的方案积累,给出下一代 AI 集群网络规划建议。
NVIDIA CMX:跨越显存边界,重构智能体时代的“上下文记忆”
随着智能体(Agentic AI)任务复杂度提升,单次推理往往需要调用工具、检索外部知识、维护多轮对话状态,传统的 KV Cache 显存边界成为长上下文场景下的核心瓶颈。NVIDIA 推出 CMX(Coherent Memory eXtension)技术,跨越单卡显存边界,把"上下文记忆"作为一等公民重新设计:跨节点、跨存储层级统一管理 KV Cache 与对话状态,为智能体推理提供大容量、低延迟、可持久化的记忆底座。本文系统梳理 CMX 的核心机制、与传统 KV Cache 卸载的差异、对智能体推理吞吐的影响,以及超擎数智在企业级智能体私有化部署中的方案对接建议。
WAIC展品抢鲜看 | 超擎数智CQIS服务,解锁AI算力底座的高效交付密码
WAIC 2026 即将启幕,超擎数智将携 CQIS 算力底座服务亮相。CQIS 把"算力交付"做成标准化产品,覆盖从 GPU/NPU 整机选型、硬件调优、集群组网、模型适配到长期运维托管的全流程,让企业用户可以像采购云服务一样采购本地 AI 算力。在 WAIC 现场,超擎数智将通过实物展示与现场讲解,呈现 CQIS 在大模型训练、智能体推理、企业级私有化部署等场景下的交付效率与稳定性。本文抢先剧透 CQIS 的核心能力、典型客户案例与展会现场亮点,欢迎莅临超擎数智展位交流。
WAIC展品抢鲜看 | AI Driver Platform亮相:让AI持续创造业务价值
很多企业的 AI 落地止步于"单点试验"——模型跑起来了,业务价值却没有跟上。超擎数智 AI Driver Platform 在 WAIC 2026 亮相,正面回应这一痛点:把算力调度、模型服务、智能体编排与业务指标打通成闭环运营平台,让 AI 从一次性项目变成持续创造业务价值的生产系统。平台覆盖模型全生命周期管理、推理服务治理、效果量化与持续调优,让业务团队看得见每一分算力投入的产出。本文抢先剧透 AI Driver Platform 的核心能力、典型业务场景与展会现场亮点,欢迎莅临超擎数智展位交流。
携手英伟达 VAST Data 构建面向大规模 AI 的全新内存层级
随着模型规模与上下文长度持续膨胀,GPU 显存正成为大规模 AI 的第一道"墙"。NVIDIA 宣布携手 VAST Data,构建面向大规模 AI 的全新内存层级:把存储系统从"数据仓库"升级为"记忆层级",通过 KV Cache 分层卸载、上下文持久化与跨节点共享,让 GPU 显存、主机内存与高性能存储协同成一个统一的大容量内存体系。该架构可显著支撑超长上下文推理、多智能体记忆共享与超大模型部署,是 AI 工厂演进中的关键一环。本文详解双方合作的技术架构、关键能力与落地价值,并结合超擎数智在算网与存储融合方向的方案积累,给出企业级部署建议。
WAIC展品抢鲜看 | 超擎数智 AIDC Shuffle解决方案,赋能下一代AI数据中心网络架构
当 AI 集群规模从千卡迈向万卡、十万卡,传统 Fat-Tree 三层网络架构正面临端口爆炸、成本激增与运维复杂的多重挑战。超擎数智 AIDC Shuffle 解决方案在 WAIC 2026 亮相,正面回应这一痛点:通过 Shuffle/Dragonfly 风格的高阶网络拓扑,把跨 Pod 的"全局带宽"重新组织为更扁平、更经济的近邻互联结构,显著降低交换机数量与布线成本,同时保持大模型训练所需的高带宽与低延迟。方案覆盖拓扑设计、交换机选型、路由算法、运维监控与平滑演进路径,是面向下一代 AI 数据中心的关键网络底座。本文抢先剧透 AIDC Shuffle 的核心原理、典型客户场景与展会现场亮点。