技术博客
沉淀 AI 算力、无损网络、高速互联、集群验收和 AIDC 工程实践,帮助团队更快识别问题、验证方案和复用经验。
WAIC 2026重磅首发 | 超擎数智成为VAST中国区合作伙伴,推动构建AI工厂全栈方案
WAIC 2026 期间,超擎数智正式宣布成为 VAST 中国区合作伙伴,这是 VAST 在中国市场战略落地的重要里程碑,也是超擎数智"AI 工厂全栈方案"的关键一环。双方将围绕 AI 存储与记忆层级,深度融合 VAST 在 AI 数据平台、KV Cache 分层卸载与企业级存储方面的领先能力,与超擎数智在算力、网络、应用层的方案形成端到端闭环。中国客户将能享受到本地化交付、合规可控与一站式服务的价值,方案覆盖大模型训练、智能体推理、企业级 AI 工厂等核心场景。本文详解合作内容、方案亮点与中国区落地路径,并附超擎数智企业咨询服务入口。

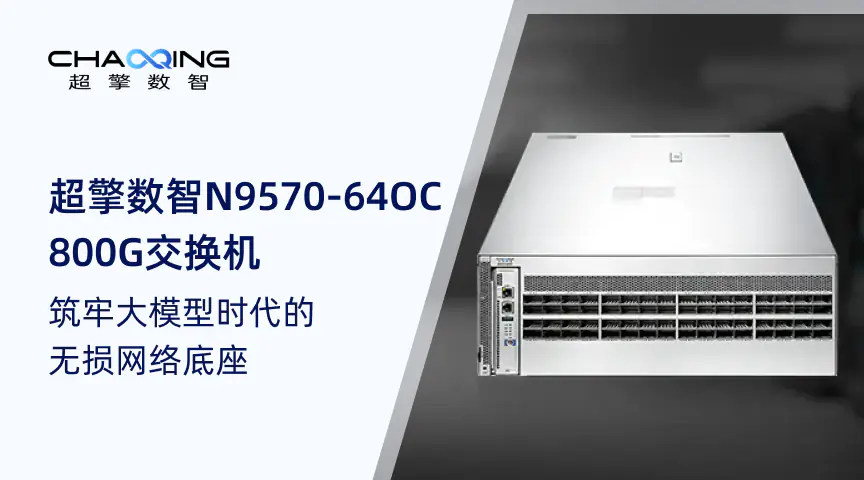
WAIC展品抢鲜看 | 超擎数智N9570-64OC 800G交换机:筑牢大模型时代的无损网络底座
大模型参数规模迈入万亿、十万亿时代,AI 集群对网络底座提出前所未有的高带宽与低延迟要求。超擎数智在 WAIC 2026 推出 N9570-64OC 64 口 800G 数据中心交换机,单芯片提供 51.2T 交换容量,原生支持 RoCE 无损网络与端到端拥塞控制,可显著降低大模型训练中的通信等待时间,并支撑智能体推理、海量向量检索等高并发场景。设备兼容 OSFP 800G 光模块与 400G 兼容模式,可灵活适配 AIDC Shuffle、Fat-Tree 与 Dragonfly 等多种网络拓扑。本文抢先剧透 N9570-64OC 的关键规格、技术亮点与展会现场展示,欢迎莅临超擎数智展位交流。
超擎数智 × 生物制药 | 软硬一体算力底座 + 软件加速平台,加速生物制药AI创新落地
超擎数智面向生物制药行业发布软硬一体算力方案:自研 GPU 算力底座 + 软件加速平台,覆盖分子生成、蛋白质结构预测、虚拟筛选与分子动力学等 AI for Drug 场景,显著加速新药研发管线。本文详解方案架构、典型场景与落地价值,附超擎数智行业实践经验。
AI数据中心网络交换机选购指南:面向低延迟、高吞吐的网络架构
本文系统梳理AI网络交换机的两大核心性能指标、两条技术路线、完整选型参数体系,以及网卡与光模块的配套选型逻辑,帮助工程师与决策者在技术迭代加速的背景下做出经得起未来验证的硬件选择。
NVIDIA DGX B300 集群布线方案详解:InfiniBand 与 RoCE 网络部署指南
本文以搭载 ConnectX-8 网卡的 NVIDIA DGX B300 AI 集群为对象,分别介绍 InfiniBand 与 RoCE 两种网络架构下计算网、存储网的 Leaf-Spine 全光布线设计,对比了两套方案的交换机、光模块、光纤选型及 8SU 规模下节点与光缆配置,指出两种方案光纤组件需求量大,部署时需结合集群规模、传输距离与机房现有条件综合选型。
不选最贵,只选最适合!5款主流AI GPU选项指南
很多团队在租GPU时真正的问题不是“性能不够”,而是性能远超需求、成本却长期买单。本文从业务场景出发,解析RTX 5090、RTX Pro 6000、H100、H200、B300五款主流AI算力卡的选型逻辑,帮助个人开发、初创团队与企业级用户做出最适合的决策。
如何为 AI 集群选择网络交换机?五个关键步骤
将GPU集群投入生产时,网络是容易被低估的一环。本文把AI集群网络交换机的选型拆解为五个关键步骤——从明确工作负载、确定网络拓扑、推导交换机规格,到评估功能特性与落地约束,帮助决策者系统性地完成交换机选型。
深入解析OCS:基于光层直连的交换技术
深入分析 OCS(Optical Circuit Switch)在AI训练和高性能计算数据中心中的应用价值,探讨其光层直连技术、低时延与高带宽优势,以及在补充传统电交换网络、优化大规模集体通信中的潜力和局限。
英伟达 Feynman 架构深度解析:1.6nm芯片如何改写AI算力规则?
英伟达 Feynman(费曼)架构基于台积电 A16(1.6nm)工艺与背面供电技术,通过 3D 堆叠 LPU、异构存储体系和低延迟推理优化,为大模型时代提供高效能、低功耗的下一代 AI 算力基础。